AI Agent可观测性的另一半:执行级验证

AI Agent 可观测性需从执行轨迹延伸到外部系统中的执行级结果验证。
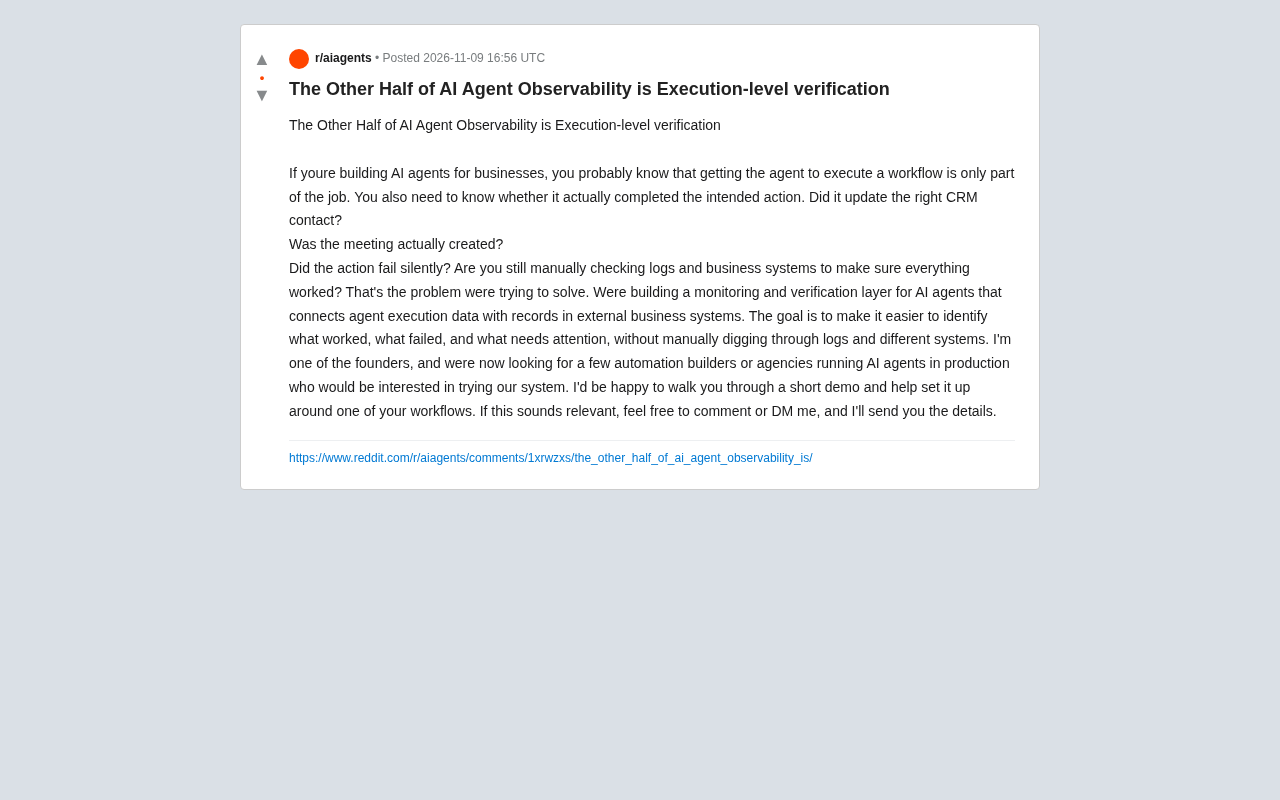
文章指出,让 AI Agent 跑通工作流只是任务的一半,另一半是确认它是否真的在业务系统中完成了预期动作。现有可观测性工具多聚焦执行轨迹,能记录工具调用与报错,却回答不了 CRM 联系人是否更新、会议是否创建、动作是否静默失败等业务结果问题。对此,Reddit 上一位创始人提出构建监控与验证层,将 Agent 执行数据与外部业务系统记录连接,实现结果确认、异常归因和人工介入优先级三层价值。该需求最先出现在已把 Agent 投入生产、动作后果具体的团队中。素材未披露具体实现方式、支持系统类型与验证延迟等细节。
AI Agent 能跑通工作流,不等于它做对了事。真正让团队夜不能寐的,是 Agent 执行完之后,那些没人知道到底成没成的业务动作。
问题:执行完成了,然后呢?
很多团队在构建面向企业的 AI Agent 时,会把大量精力放在“让 Agent 能执行工作流”上。这当然重要,但只是任务的一半。另一半是:确认它是否真的完成了预期动作。
据 Reddit 上一位正在构建此类系统的创始人描述,常见的困境包括:
- Agent 是否更新了正确的 CRM 联系人?
- 会议是否真的被创建了?
- 某个动作是否静默失败了?
这些问题如果靠人工翻日志、逐个检查业务系统来回答,不仅低效,而且很容易漏掉。更麻烦的是,静默失败往往不会抛出明显的错误,等发现时可能已经影响了客户体验或业务数据。
传统可观测性的盲区
现有的 AI Agent 可观测性工具,大多聚焦在“执行轨迹”层面:记录 Agent 调用了哪些工具、输入输出是什么、耗时多久、有没有报错。这些信息对于调试很有价值,但它回答不了业务负责人最关心的问题——执行结果在外部系统中是否生效。
换句话说,执行轨迹告诉你“Agent 说自己做了”,而执行级验证告诉你“业务系统里确实发生了”。两者之间的差距,正是许多生产环境事故的温床。
这位创始人提出的思路是:构建一个监控与验证层,把 Agent 的执行数据与外部业务系统中的记录连接起来。目标不是替代日志,而是在日志之上增加一层“结果核对”,让团队能更容易地识别哪些动作成功了、哪些失败了、哪些需要人工介入。
执行轨迹(execution trace) 是 AI Agent 可观测性中的基础数据形态,通常由 Agent 框架在每一步调用时自动记录:包括模型生成的思考链或工具选择、工具调用的入参和返回值、耗时、token 消耗以及错误码。这类数据本质上描述的是「Agent 内部视角的执行过程」,其完整性依赖 Agent 自身的埋点质量。
与之相对的概念是执行级验证(execution-level verification),它不信任 Agent 的自述,而是以外部业务系统(CRM、日历、工单等)中的实际记录为准,通过查询接口做状态回读(read-back),再与 Agent 声明结果比对。二者的关键差异在于数据来源的独立性:执行轨迹来自 Agent 自己,执行级验证来自被操作的目标系统。也正因如此,后者才能暴露「API 返回 200 但实际未写入」这类只在外部系统中可见的偏差。
执行级验证在解决什么
从产品思路来看,执行级验证的核心价值可以拆成三层:
第一层是结果确认。 对每一个关键业务动作,系统需要去外部系统(比如 CRM、日历、工单系统)中查询实际状态,并与 Agent 声明的结果做比对。这样一来,静默失败就不再静默。
第二层是异常归因。 当比对不一致时,团队需要知道问题出在哪:是 Agent 选错了对象,还是外部 API 返回了成功但实际没写入,还是权限或数据格式导致的隐性失败。执行数据与业务记录的关联,为归因提供了线索。
第三层是人工介入的优先级。 不是所有失败都需要立刻处理,但系统应该帮助团队区分“必须马上修”和“可以稍后看”的情况,减少无差别的人工巡检。
静默失败(silent failure) 指的是动作未达预期却未抛出错误的现象。在 Agent 场景中,它常由几种机制造成:外部 API 返回成功状态码但业务层校验未通过、异步写入最终被丢弃、Agent 把参数填进了错误但合法的字段、或者 OAuth 权限范围不足导致写入被系统忽略。这些情况不会出现在错误日志里,因此传统基于异常捕获的监控无法捕捉。
验证层应对静默失败的典型做法是幂等回读与最终一致性对账:在动作完成后延迟一段时间(覆盖异步写入窗口)再回查目标系统,并将回读结果与 Agent 声明的实体标识、关键字段逐一比对。这也解释了为什么「验证延迟」是一个关键设计参数——间隔太短会误判异步操作失败,太长则削弱告警的时效性。
谁需要这类工具
这位创始人明确表示,他们正在寻找在生产环境中运行 AI Agent 的自动化构建者或代理机构,愿意试用这套系统。这透露出一个信号:执行级验证的需求,最先出现在那些已经把 Agent 投入实际业务、且动作后果比较具体的场景里。
对于还在实验阶段的团队,执行轨迹可能已经够用;但对于每天要处理大量业务动作的团队,缺少结果验证意味着要么增加人工复核成本,要么承担静默失败的风险。
多源信息交叉来看,Reddit 原帖提供了产品定位和问题描述,截图仅作为来源佐证,没有额外的技术细节。因此,关于这套系统的具体实现方式、支持的系统类型、验证延迟等关键信息,目前还无法从素材中确认。
一个值得关注的缺口
AI Agent 的可观测性正在从“能看到执行过程”向“能确认执行结果”延伸。这个方向并不新奇——传统自动化领域早有结果校验的做法——但把它系统化地应用到 AI Agent 场景,并打通外部业务系统,仍然是一个有实际痛点的缺口。
对于正在生产环境运行 Agent 的团队,值得问自己一个问题:你今天有多少时间花在手动确认 Agent 到底做对了没有? 如果这个数字不小,执行级验证可能正是缺失的那一半。
相关推荐
5.3英寸手机众筹:小屏复兴还是599美元的无奈?
Enough Phone 在 Kickstarter 众筹,5.3 英寸小屏搭配 8GB 内存和 5000 万像素传感器,定价 599 美元。The Vergecast 讨论小屏手机能否在旗舰大屏与功能机之间找到中间地带,以及廉价手机为何越来越难做。
Asahi Linux弃用MIT转GPL:一场针对Omarchy的闹剧?
Asahi Linux将代码许可证从MIT改为GPL V2,指控Omarchy窃取代码并商业化。分析认为此举理由牵强且违反MIT协议,暴露开源社区政治分歧与AI争议。
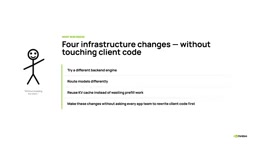
5分钟读懂NVIDIA Dynamo前端:兼容OpenAI的推理架构入口
NVIDIA Dynamo前端是什么?本文基于官方5分钟系列视频,解析它如何以OpenAI兼容API作为稳定边界,实现后端引擎替换、路由与KV缓存复用的解耦架构。