AI Agent跨项目上下文管理:HN社区实战经验

HN讨论揭示跨客户项目AI agent上下文隔离的实践方案与安全底线。
文章基于Hacker News一则关于跨客户项目AI agent上下文管理的讨论,梳理了开发者面临的核心问题:如何在多个客户项目间保持上下文隔离,同时复用通用知识。文章指出上下文隔离不仅是效率问题,更是防止客户数据泄露的安全底线。主流方案包括为每个项目创建独立的agent实例(如项目规则文件),以及维护中央知识库并动态注入项目上下文(如读取`.ai-context`文件)。工具层面,Cursor的项目规则、`AGENTS.md`版本控制、多会话管理和向量数据库记忆持久化都是常见实践。文章还总结了上下文窗口限制、配置维护成本和工具碎片化三大挑战,社区共识是“从简单开始,按需演进”。
引言
当开发者同时在多个客户项目中使用AI编程助手时,一个棘手的问题浮现:如何让AI agent在不同项目间保持上下文隔离,同时又能高效复用知识?Hacker News上的一则"Ask HN"帖子引发了17条评论的热烈讨论,虽然原帖只有16个points,但话题直击当前AI辅助开发的核心痛点——上下文管理。
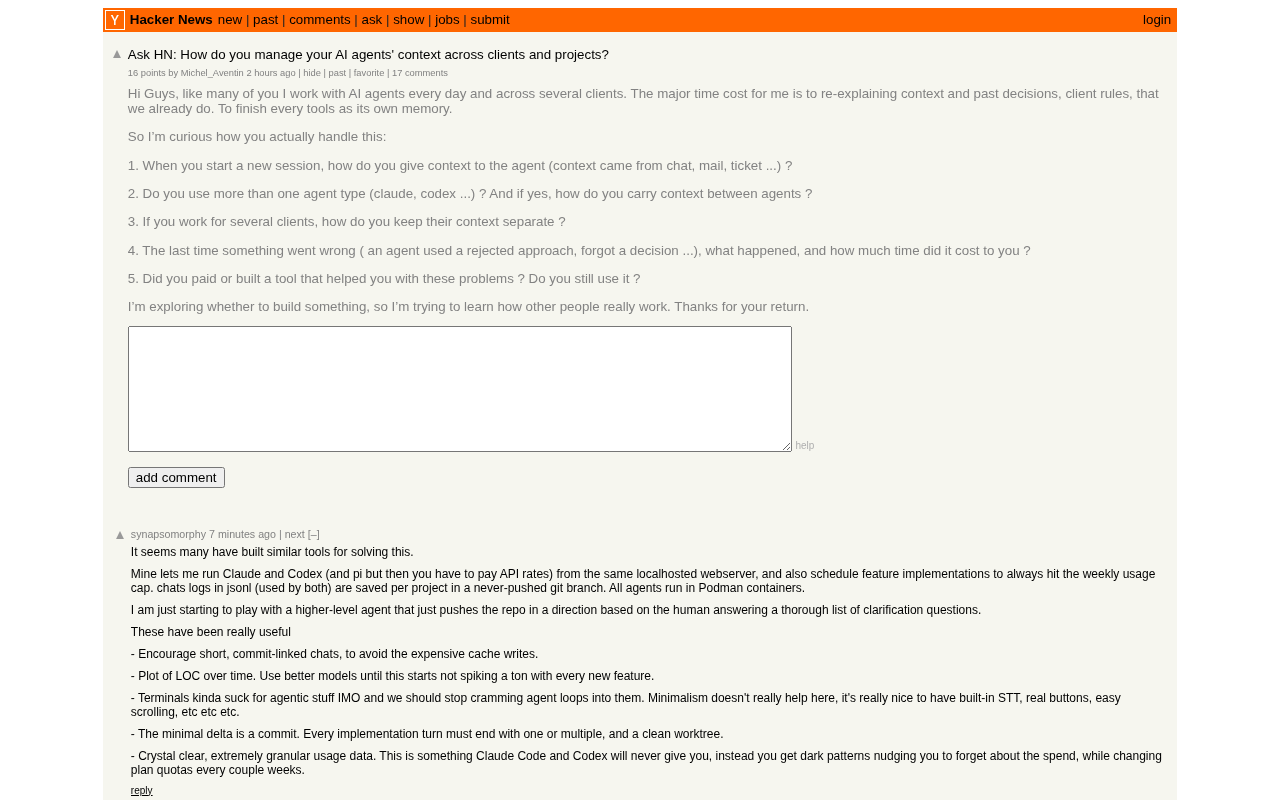
本文基于该讨论及社区常见实践,梳理出几种主流方案和关键考量。
为什么上下文管理如此重要
AI agent的上下文窗口是其能力的边界。在单一项目中,开发者通常通过系统提示词、项目文档和代码库索引来构建上下文。但跨客户项目时,问题变得复杂:不同客户的技术栈、业务逻辑、甚至代码风格都可能不同,而AI agent若混淆了这些信息,轻则给出不相关建议,重则泄露敏感数据。
Hacker News评论中,多位开发者强调,上下文隔离不仅是效率问题,更是安全底线。尤其对于咨询公司或自由职业者,客户A的架构决策不应出现在客户B的对话中。
上下文窗口(Context Window)是指大语言模型在一次推理中能够接收和处理的token总数上限,包括输入提示和模型生成的输出。当前主流模型的上下文窗口从数万到数十万token不等。超出窗口的内容会被截断或无法处理,因此开发者需要精心选择哪些信息放入上下文。对于代码库而言,即使是一个中等规模的项目,其全部源码、文档和配置也可能轻松超过窗口限制,这使得检索增强生成(RAG)成为必要手段:先将代码库切分并建立向量索引,再根据当前任务检索最相关的片段注入上下文,而非一次性塞入全部内容。理解上下文窗口的硬性边界,是设计跨项目上下文管理方案的前提。
主流方案:分层配置与项目级隔离
方案一:每个项目独立的agent实例
最直接的做法是为每个客户项目创建独立的AI agent配置。评论中有人提到,使用类似Cursor的"项目规则"功能,或为每个仓库维护一个专属的系统提示词文件。这样,当切换到不同项目时,agent的默认行为随之改变。
这种方式的优点是简单清晰,缺点是配置重复,且难以在项目间共享通用知识(如公司编码规范)。
方案二:动态上下文注入
更灵活的做法是维护一个中央知识库,根据当前项目动态注入相关上下文。例如,通过环境变量或配置文件指定当前项目标识,agent启动时加载对应的项目文档和代码片段。评论中有开发者分享,他们使用脚本在会话开始时自动读取项目根目录下的.ai-context文件,将其内容作为前置提示。
这种方案需要一定的工程化投入,但能兼顾隔离与复用。
系统提示词(System Prompt)是对话开始前注入给模型的指令性文本,用于设定agent的角色、行为准则和默认约束。在项目级隔离方案中,系统提示词文件通常以纯文本或Markdown格式存放在仓库根目录,agent每次启动时读取并作为最高优先级的上下文。与之配合的.ai-context这类约定文件,本质上是一种配置即代码的实践:把项目特有的技术栈说明、编码规范、禁忌事项固化到版本控制中,使团队内所有人和所有AI工具读取同一份事实来源。这种做法的好处是上下文随代码一起演进、可审查、可回滚,避免了口口相传或散落在个人笔记中的隐性知识。
工具与工作流实践
利用现有AI编程工具的项目管理功能
许多AI编程工具已经内置了项目级上下文管理。例如,Cursor支持在项目根目录放置规则文件,GitHub Copilot允许通过注释和配置文件引导行为。HN讨论中,有用户提到将AGENTS.md或类似文件纳入版本控制,作为项目上下文的标准入口。
会话管理与记忆持久化
对于需要长期对话的场景,会话管理变得关键。一些开发者使用支持多会话的客户端,并为每个客户项目固定一个会话线程。另一些人则借助外部记忆工具(如向量数据库)存储项目特定的交互历史,在需要时检索注入。
你可能没注意到,评论中有人提醒:记忆持久化需谨慎,避免将不同项目的记忆混合。建议为每个项目设置独立的记忆命名空间。
向量数据库在AI记忆场景中扮演检索层角色:它将文本片段转换为高维向量并建立近似最近邻索引,使agent能够根据语义相似度而非关键词精确匹配来召回历史交互或项目知识。记忆命名空间则是在同一向量库内划分的逻辑隔离分区,每个项目使用独立的命名空间,检索时限定在对应分区内,从根本上杜绝跨项目污染。部分工具还支持在写入记忆时附加元数据(如项目ID、时间戳、敏感级别),以便在检索阶段做过滤。需要权衡的是,向量检索存在召回不精确的风险,且记忆内容会随时间累积膨胀,因此定期清理和分级存储是维持系统健康度的必要运维工作。
关键挑战与社区共识
尽管方案多样,讨论中透露出几个未解的难题:
- 上下文窗口限制:即使隔离了项目,单个项目的代码库也可能超出模型上下文,需要有效的检索策略。
- 配置维护成本:随着项目增多,手动维护每个项目的上下文配置变得繁重。
- 工具碎片化:不同AI工具对上下文管理的支持程度不一,缺乏统一标准。
社区共识倾向于:从简单开始,按需演进。初期可以为每个项目建立基础规则文件,随着痛点出现再引入自动化注入或记忆系统。
总结
跨客户项目的AI agent上下文管理没有银弹,但通过项目级隔离、动态注入和谨慎的记忆管理,开发者可以在效率与安全之间找到平衡。Hacker News的讨论虽然规模不大,却真实反映了当前AI辅助开发中的实践困惑。随着AI工具链的成熟,这一领域有望出现更标准化的解决方案。
相关推荐
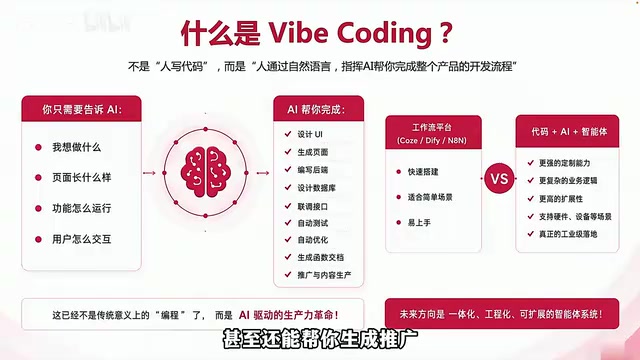
Vibe Coding零基础入门:AI辅助编程实战指南
Vibe Coding 零基础入门实战指南:解析 AI 辅助编程如何让人指挥 AI 写代码,覆盖 Claude Code、Cursor 类工具与 AI 协同开发、多端开发、自动化运营的全链路一人公司实战路径。
Gemini 4 Neon 实测:谷歌中型模型叫板 Opus 5.5
Gemini 4 Neon 实测解读:谷歌中型模型在代码任务上比肩 Opus 5.5,连贯性与长任务表现突出,价格更便宜,但3D生成与架构分析仍有短板。

警用转录公司数据泄露:云服务器裸奔暴露执法敏感信息
一家服务警方、检察官和科技巨头的转录公司因云服务器未设密码,导致审讯录音和执法记录仪视频等敏感数据暴露。本文分析事件背后的第三方风险与云安全老问题。