AI Agent人工审批放错位置:你需要两道关卡吗?
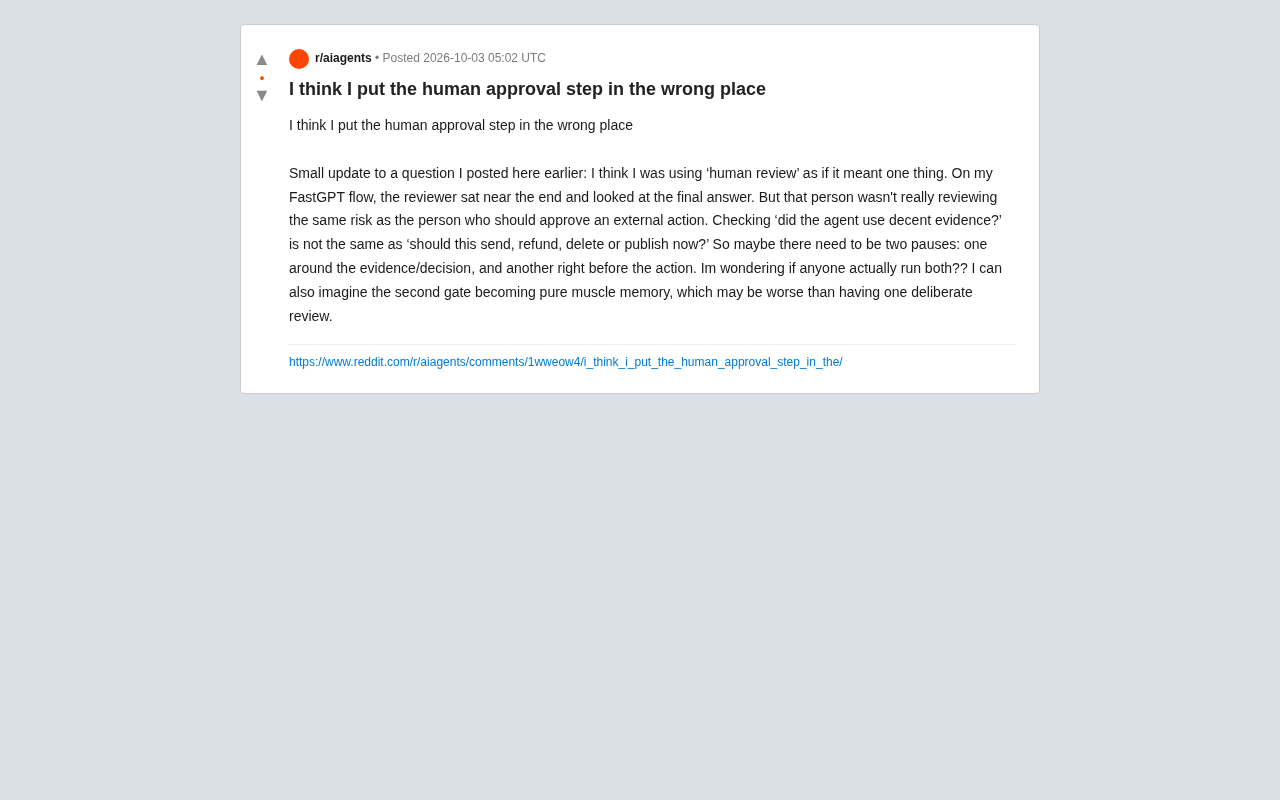
AI Agent工作流中,人工审核应按风险类型精确落位,而非默认堆在流程末尾。
本文从一位Reddit用户的实践反思出发,指出AI Agent工作流中一个常见但被忽视的设计错误:将人工审核点默认置于流程末尾。作者将人工审核拆解为两种本质不同的类型——针对推理过程的"决策/证据审查"与针对不可逆外部动作的"行动前审查"——并论证两者的风险性质截然不同,不应混为一谈。由此引申出双关卡架构设想,但同时警示:过度频繁的审批弹窗会让审核者陷入"肌肉记忆"式的机械点击,反而制造虚假安全感。文章最终提炼出三条设计原则:按风险类型而非流程位置放置审核点、区分可逆与不可逆操作、警惕审批疲劳。
一个被忽视的设计错误
在构建AI Agent工作流时,很多人会习惯性地加入一个"人工审核"环节,并把它放在流程末尾——让审核者检查Agent生成的最终答案。这看似稳妥,却可能从一开始就把关卡放错了地方。
一位Reddit用户在分享自己使用FastGPT搭建流程的经验时提出了这个问题。他原本把审核者安排在流程接近结束的位置,专门检查最终输出。但他很快意识到:检查"Agent用的证据靠谱吗"和判断"这件事现在该不该发送、退款、删除或发布",根本是两种完全不同的风险。
这个看似微小的反思,实际上触及了AI Agent安全设计中的一个核心命题:人工介入的位置,决定了它能挡住什么风险。
两种本质不同的审查
把"人工审核"当成一个单一概念,是许多流程设计的隐患。原帖作者敏锐地把它拆成了两类:
决策/证据审查
第一类审查关注的是推理过程的质量:Agent是否基于合理的证据得出结论?它引用的信息是否可靠?推理链条有没有明显漏洞?这是对"思考质量"的把关,发生在决策形成阶段。
行动前审查
第二类审查关注的是不可逆的外部动作:这封邮件该不该发出去?这笔退款该不该执行?这条内容该不该发布?这些操作一旦落地,往往无法撤回,风险性质与前者截然不同。
作者的核心洞见在于:一个坐在流程末尾、只看最终答案的审核者,很可能既没有真正评估证据质量,也没有专门为高风险的外部动作把关。他审查的"风险"和真正需要被审查的风险并不对应。
这种拆分思路与信息安全领域的"控制点"(Control Point)理论一脉相承。传统的访问控制设计早已区分"身份验证"与"操作授权"——前者判断"你是谁",后者判断"你能做什么"。AI Agent场景中的两类审查与之高度同构:决策/证据审查相当于验证推理的合法性,行动前审查相当于对高权限操作的二次授权。忽视这种区分,本质上是把两个不同层级的控制责任压缩到了同一个审核动作里,必然导致其中一类风险被系统性地忽略。
两道关卡的设想与隐忧
基于这个判断,作者提出了一个更合理的架构设想:设置两个暂停点。一个围绕证据与决策,另一个紧挨在执行外部动作之前。
这种双关卡设计在逻辑上更贴合实际风险分布。决策关卡确保Agent"想得对",行动关卡确保系统"做得对",两者各司其职,不再混为一谈。
但作者同时提出了一个值得警惕的反向担忧:第二道关卡可能退化成纯粹的肌肉记忆。当审核者面对一个个"确认执行"的弹窗时,久而久之很容易变成机械式点击,审查沦为形式。到那时,这道看似增加了安全性的关卡,反而可能比只有一个经过深思熟虑的审查环节更糟糕——因为它制造了"已经审查过"的虚假安全感。
这是一个相当深刻的观察。人工审核的价值不在于"有没有这个步骤",而在于审核者是否真正处于一种能够做出判断的认知状态。一个被过度触发、失去注意力的关卡,等同于没有关卡。
这种认知退化现象在人因工程(Human Factors Engineering)领域被称为"自动化偏见"(Automation Bias)——当人类长期处于监督自动化系统的角色时,会逐渐倾向于过度信任系统输出,降低独立判断的主动性。经典案例来自航空业:飞行员在高度依赖自动驾驶的环境下,手动操控能力和情景感知能力会随时间衰退。在Agent审批场景中,"确认执行"弹窗触发越频繁、Agent输出越稳定,审核者就越难维持真正的警觉状态。这意味着关卡的设计不仅要考虑"放在哪里",还要考虑如何在触发频率和认知负荷之间取得平衡。
对Agent工作流设计的启示
从这个讨论可以提炼出几条实用的设计原则:
按风险类型而非流程位置来放置审核点。 不要默认把审核堆在流程末尾,而应思考每个关卡具体要拦截什么风险,并把它放在最能发挥作用的位置。
区分"可逆"与"不可逆"操作。 发送、退款、删除、发布这类不可逆动作,天然需要独立的、更郑重的审批机制,不应与普通的质量检查混在一起。
警惕审批疲劳。 如果一个关卡被触发得过于频繁,就要考虑它是否真的有效。或许可以通过只在高风险场景触发人工审批、对低风险动作自动放行的方式,保留审核者的注意力和判断力。
作者在帖子最后抛出的问题——"有没有人真的同时跑了这两道关卡?"——至今仍是开放的。这也说明,在实践中如何平衡安全性与可用性,仍然缺乏成熟的共识。但他提出问题的方式本身,已经为所有正在搭建AI Agent的开发者提供了一个值得反复推敲的思考框架。
在工程实现层面,一些Agent框架已开始提供对"不可逆工具调用"的原生标记支持,允许开发者在工具定义阶段声明某个函数是否具有副作用(side effect),并据此自动插入审批节点。LangGraph等框架引入的"中断点"(interrupt)机制,正是为了在图执行过程中的特定边上挂起流程、等待人工确认。这种架构上的显式区分,比在提示词里反复强调"请谨慎"更可靠——它将风险边界从模型推理层下沉到了执行引擎层,从根本上降低了因提示词漂移导致的安全失效概率。
结语
人工审批不是一个可以随意插入的"安全补丁",而是需要和风险结构精确对齐的设计决策。放错位置的审核,可能既浪费人力又无法真正降低风险;而机械堆叠的审核,又可能制造虚假的安全感。真正的挑战,是让每一次人工介入都发生在它最该发生的时刻。
相关推荐
TabPFN:终结机器学习调参的表格数据基础模型
深度学习曾在表格数据上失败,TabPFN 如今已超越 XGBoost 和 CatBoost。本文解析这个完全用合成数据训练的表格基础模型如何以单次前向传播完成预测、支持因果推理,并在 Kaggle 竞赛中一行代码夺冠。
完美世界模型也打不赢卡尔森:AI预测与决策的鸿沟
AI研究者Alexander Mattick指出,即使拥有完美的象棋世界模型也无法战胜卡尔森,因为预测未来与做出正确决策是两回事。本文解析世界模型的能力边界、人形机器人只会后空翻却不会取牛奶背后的触觉感知与接触密集环境难题。
重写AI智能体能否弯曲智能曲线?WeCo的递归自我改进实验解析
WeCo.ai的CEO蒋正耀详解递归自我改进(RSI)实验:如何通过重写AI智能体的harness而非模型本身来弯曲智能曲线,提出RSI四级框架,剖析奖励黑客防御机制与人机协作的边界。