AI Agent上线一周被回滚:链式衰退如何毁掉自动化

AI Agent生产事故复盘:多步骤概率执行导致端到端成功率骤降,需精简步骤并设置人工卡点。
本文复盘了一个客服/业务操作型AI Agent上线不到一周即被下线的真实事故。核心问题是"链式衰退":即使每个步骤成功率高达95%,10个步骤串联后整体成功率仅剩约59%,在生产环境中完全不可接受。测试阶段因流程组合爆炸性增长只能验证原子能力,掩盖了累积误差。作者提出两条优化路径:一是把确定性逻辑收敛进代码、精简模型决策步骤;二是在高风险节点设置人工卡点以阻断错误链式放大。最终结论是,Agent的价值在于"自动化"而非"全自动",错误率低于人工即有应用价值,团队应理性评估哪些环节适合交给概率模型。
一个真实的生产事故:Agent运行不到一周就下线
一位开发者在B站分享了他团队近期的一次失败实践:他们上线了一个类似客服/业务操作型的AI Agent,目标是替代大量人工操作,实现业务流程自动化。然而这个Agent运行不到一周便被紧急下线回滚。
这不是模型能力不足的问题,也不是产品方向错了,而是一个在Agent工程落地中极具代表性的陷阱——业务成功率的链式衰退。对于正在考虑把Agent推向生产环境的团队来说,这个复盘比任何demo演示都更有参考价值。
链式衰退:95%的十次方只剩59%
问题的核心在于Agent的概率执行特性。一个完整业务流程往往由多个关键步骤串联而成,而每个步骤都存在失败的可能。
作者给出了一个直观的数学模型:假设一个业务流程包含10个关键步骤,每个步骤的成功率高达95%,看起来已经相当可靠。但当这些步骤串联在一起时,整体成功率变成了 0.95 的十次方——约等于59%。
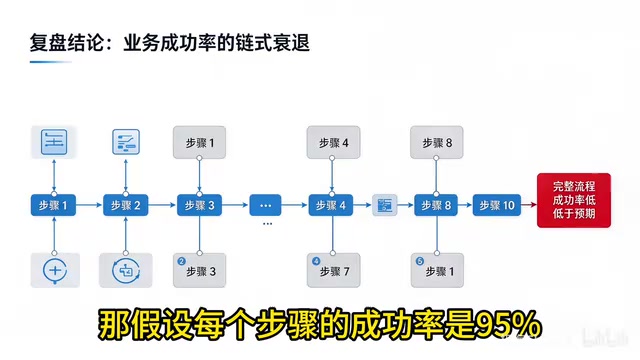
换句话说,一个完整业务流程的端到端成功率可能连60%都不到。对任何严肃的生产业务而言,这个数字是不可接受的。Agent本意是节省人力成本,结果却需要人工持续监控、随时介入,反而增加了运维负担。
这个简单的乘法揭示了一个被很多人忽视的真相:单步看起来很高的成功率,在长链路中会被迅速稀释。 步骤越多,衰退越严重。
这种现象在可靠性工程中被称为串联系统可靠性问题(Series System Reliability)。在传统软件工程里,一个确定性函数要么成功要么失败,通常可以通过异常处理和重试机制兜底;但在LLM驱动的Agent中,每一步的「失败」并不总是抛出异常——更危险的情况是模型给出了一个看起来合理、实则错误的输出,而这个隐性错误会无声地传入下一步。这类「软失败」不会触发任何报警,却会在链路中悄悄累积偏差。因此,Agent系统的95%单步成功率,实际上包含了两种截然不同的风险:可检测的硬失败,以及难以察觉的语义漂移,后者往往才是生产事故的真正根源。
为什么测试阶段没发现问题
一个自然的疑问是:上线前为什么不做全流程测试?
作者坦言,表面原因是业务编排的流程组合实在太多了。
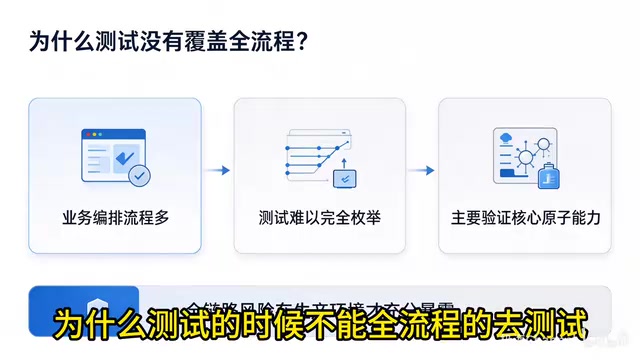
当一个Agent可以根据用户输入动态编排不同的执行路径时,可能的流程组合近乎爆炸式增长,测试几乎无法穷举所有分支。因此测试阶段通常只能验证一些核心的原子能力——确保单个工具调用、单个决策节点是正常的,却难以覆盖它们组合后的整体表现。
这正是链式衰退的隐蔽之处:每个原子能力测试都通过,给人一切正常的错觉,但真正到了生产环境把它们串起来跑,累积误差才会暴露出来。
优化方向一:精简步骤,把确定性收敛进代码
作者明确表示,换更强的模型并不是解药,那只是缓解现象而非解决根因。真正的改进要回到Agent的设计思路本身。
第一个优化点是精简流程步骤。根据单步概率模型,步骤越少,整体成功率越高。
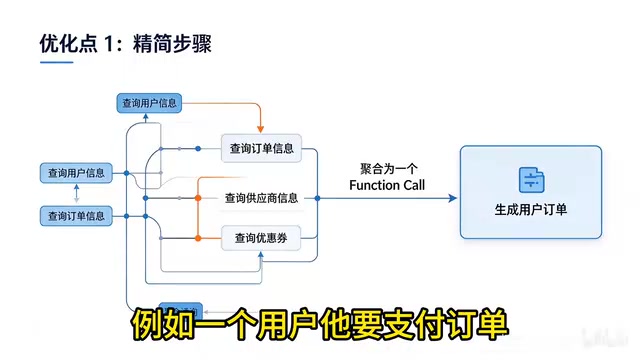
作者举了一个支付订单的例子。旧的设计思路把function call拆得非常细:用户输入指令后,让模型分别去查询用户信息、查询订单信息、查询供应商信息、查询优惠券……每一步都交给模型决策。
但实际上,这中间的很多步骤是确定性的,根本不需要模型来做概率判断。更合理的做法是把它们聚合成一个function call——比如直接"生成用户订单",把原本分散的查询逻辑在代码层面固化下来。
这背后的设计哲学值得记住:把概率的决策权重新收敛到代码里。 能用确定性代码解决的,就不要交给概率模型。模型只负责它真正擅长、也真正需要它判断的环节。
优化方向二:增加人工卡点,阻断错误放大
第二个优化方向是在关键节点插入人工确认。
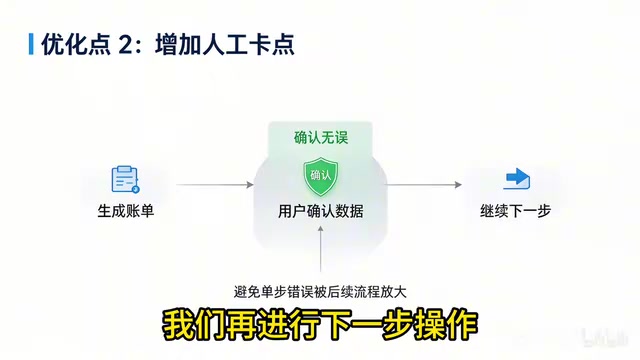
比如在生成账单之后,让用户确认数据无误再进入下一步,而不是把整条流程完全交给Agent一气呵成。
这样做的意义在于阻断错误的链式放大。在全自动流程中,前面某一步的微小错误会被后续步骤继承并逐级放大,最终导致整个业务结果偏离。设置人工卡点,相当于在链路上安装了"熔断器",让错误在传播之前就被拦截和纠正。
这其实是一种务实的 human-in-the-loop 设计——不追求100%无人化,而是在风险最高的节点保留人的判断。
Human-in-the-loop(HITL)是AI系统工程中的一个成熟设计模式,指在自动化流程的特定节点保留人类介入的机制。它并不意味着系统「不够智能」,而是一种经过工业界验证的风险管理策略。在自动驾驶领域,L2/L3级别的辅助驾驶正是典型的HITL设计——系统处理大量常规决策,人类在关键时刻接管。将这一思路引入Agent工程,核心在于识别「高影响、低置信」的节点:即一旦出错后果严重、且模型判断置信度相对较低的环节。在这些节点设置确认步骤,既保留了Agent的效率收益,又将不可控风险限制在人类可以及时干预的范围内。
结论:Agent的核心价值是自动化,而非全自动
作者的总结冷静而清醒:不要期望Agent能够完整实现你所有的业务流程。
在他看来,Agent的核心价值可以浓缩为一个词——自动化,即替代以前大量由人工完成的工作。衡量标准也很直接:只要Agent的错误率低于人工,它就有应用价值。 人本来也会犯错,关键看谁犯得更少、成本更低。
需要强调的是,作者并不反对Agent这条技术路线,而是呼吁大家理性评估自己的业务场景:这个流程适合交给Agent吗?哪些步骤是确定性的可以用代码兜底?哪些环节必须保留人工卡点?
对于所有正在推进Agent落地的团队,这次"上线一周即回滚"的复盘提供了三条可直接复用的经验:用数学模型评估端到端成功率、把确定性逻辑收敛进代码、在高风险节点设置人工卡点。能跑通demo和能扛住生产,中间隔着的正是这些工程细节。
相关推荐

智能体底座(Harness)比模型本身更关键:YC深度解析Agent架构演进
YC在Harness Night分享会上提出:决定智能体能力的关键不是模型本身,而是外层的Harness底座。本文梳理从GPT-2到自改进Harness的演进,解析Prime Agent、OpenJarvis、QM三大实践及Agent架构设计要点。

用n8n搭建LinkedIn线索抓取与丰富化自动工作流
一套基于n8n的LinkedIn线索抓取与丰富化自动工作流:只需填写职位、地点、行业和公司规模,系统即可自动生成含专业邮箱和验证状态的客户名单并写入Google表格。本文解析其流程、输出字段与合规注意事项。

SageMaker HyperPod:跨团队共享GPU集群的隔离与公平性实践
Amazon SageMaker HyperPod 推出跨团队共享GPU集群的参考架构,通过IAM Identity Center认证、Kubernetes命名空间隔离、Task Governance公平调度和成本分摊,实现算力安全共享与费用透明化。