AI Agent实战教程:从零搭建企业级智能体

系统梳理智能体的本质、能力闭环、技术演进、企业级技术栈与应用场景。
文章从传统程序与智能体的本质区别切入,指出前者是固定输入输出的封闭系统,后者能对模糊需求动态响应。智能体的能力可拆解为感知引擎、决策大脑、执行器官构成的闭环,三者环环相扣。技术演进经历规则引擎、NLP模型、大模型加工具调用与记忆系统三个阶段,当前企业级架构以第三代为主流。技术栈包含大语言模型、工具调用、记忆系统和RAG四项关键技术,它们协同支撑智能体的理解、行动、连贯性与知识更新。文章还列举了客服、数据分析、个人效率等典型场景,并给出从最小闭环起步、逐步迭代的实战建议。
智能体(AI Agent)正成为人工智能领域的热门话题,但很多初学者对它的本质和实现方式仍感困惑。本文基于一套完整的实战教程,系统梳理智能体的核心概念、技术架构与应用场景,帮你建立从理论到实践的完整认知。
传统程序 vs 智能体:本质区别
传统程序的典型特征是“固定输入、固定输出”。无论用Java、Python还是其他语言,开发者预先写好逻辑,程序只能按预设路径执行。就像自助售货机:选可乐、投币、出货,流程完全确定,不会因为你的心情或天气而改变。
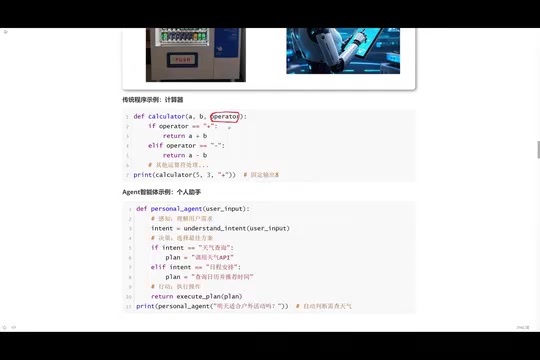
智能体则更像一个拥有思考能力的助手。你给它模糊的需求,比如“五一去旅游,帮我推荐个地方”,它会分析你的城市、交通、季节等因素,动态给出建议。这种“动态响应”的能力,正是智能体区别于传统程序的核心。
代码层面的对比更直观:传统程序传入操作符和数值,返回计算结果;智能体传入自然语言需求,内部经过意图识别、工具调用,最终返回个性化结果。前者是封闭的,后者是开放的。
智能体的核心能力闭环:感知、决策、行动
智能体的能力可以拆解为三个环节,构成一个闭环。
感知引擎负责理解用户输入。它像人的眼睛和耳朵,接收自然语言、语音甚至图像信息。例如用户说“帮我定一个便宜的酒店”,感知引擎会提取出动作(预定)、对象(酒店)、条件(低价)三个关键要素,将模糊需求结构化。
决策大脑基于大语言模型进行推理。它判断该调用哪些工具、如何组合结果。这个环节是智能体的“思考中枢”,决定了响应质量的高低。
执行器官负责实际动作。无论是调用API、查询数据库,还是操作硬件设备,执行层将决策转化为具体行为,再把结果反馈给用户。
这三个环节环环相扣,缺一不可。感知不准,决策就偏;决策不智,执行就无效。
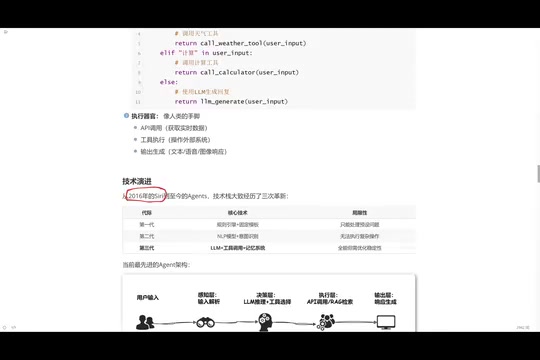
意图识别是感知环节的核心任务,本质是一个文本分类与槽位抽取问题:判断用户话语属于哪类操作意图,并从中提取动作、对象、约束条件等关键参数(即“槽位”)。工程上常用两种路径:一是基于大模型的提示词抽取,灵活但需控制稳定性;二是微调小模型做专用分类,成本低、延迟小。实际系统中常采用“规则兜底+模型主力”的混合策略,并对置信度低的输入触发澄清追问。意图识别的准确率直接决定后续工具选择是否正确,是整个链路中错误放大效应最强的环节,因此值得优先投入优化。
技术演进:从规则引擎到现代智能体
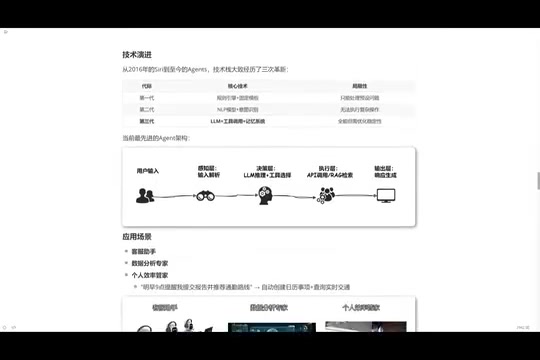
智能体的发展大致经历三个阶段。
第一代:规则引擎+固定模板。 早期的Siri、智能音箱多属此类。问“现在几点”能答,换种说法“帮我把时间调一下”就听不懂了。系统只能识别预设指令,缺乏泛化能力。
第二代:NLP模型+语音识别。 这一代能初步理解用户意图,不再局限于固定句式。但短板明显——没有记忆系统。你刚问完天气,再问“适合出去玩吗”,它不会结合上一轮对话,每次交互都是全新的。
第三代:大语言模型+工具调用+记忆系统。 这是当前企业级智能体的主流架构。大模型提供强大的理解和推理能力,工具调用扩展了行动边界,记忆系统让多轮对话连贯可行。三者结合,智能体才能真正“记住上下文、调用外部资源、完成复杂任务”。
企业级智能体的技术栈解析
要搭建一个可用的智能体,需要关注四项关键技术。
大语言模型(LLM) 是大脑皮层,负责理解、推理和生成内容。选型时需权衡能力、成本与响应速度。
工具调用 让智能体突破纯文本交互的限制。通过函数调用或API集成,智能体可以查询数据库、操作软件、控制设备,真正“动手做事”。
记忆系统 分为短期和长期。短期记忆维护当前会话的上下文,长期记忆存储用户偏好和历史交互,让智能体越用越“懂你”。
检索增强生成(RAG) 解决大模型知识陈旧的问题。通过外接知识库,智能体在回答时能检索最新文档,减少幻觉,提升准确性。
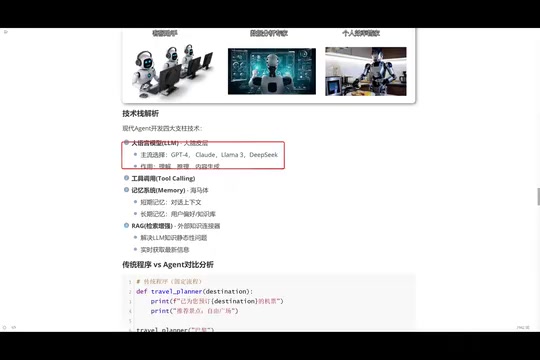
这四项技术并非孤立,而是协同工作:LLM驱动决策,工具调用执行动作,记忆系统维持连贯,RAG补充知识。理解它们的配合方式,是搭建企业级智能体的基础。
检索增强生成(RAG) 的核心思想是在大模型生成答案之前,先从外部知识库中检索与问题相关的文档片段,再将这些片段作为上下文拼接到提示词中,让模型“开卷答题”。典型流程包含三部分:索引阶段把文档切块、向量化后存入向量数据库;检索阶段将用户问题向量化并做相似度匹配,召回Top-K文档;生成阶段把召回内容与原始问题一起送入大模型。RAG的价值在于低成本更新知识、提供可溯源的引用依据,并显著抑制模型编造事实的幻觉问题,特别适合企业私域知识问答场景。
工具调用(Function Calling) 是大模型与外部世界交互的标准化机制。开发者以结构化描述(名称、功能说明、参数schema)向模型注册可用工具,模型在推理时判断是否需要调用、调用哪个工具,并输出符合schema的参数JSON;执行层真正发起API请求后,再把结果回传给模型继续推理。这一机制把“说什么”和“做什么”解耦:模型只负责规划与决策,实际动作由确定性代码完成,既保证了可靠性,也便于权限控制和审计。多工具场景下,模型还可进行串行或并行的调用编排,这正是智能体完成复杂多步任务的技术基础。
典型应用场景
智能体已渗透多个业务领域。客服场景中,智能体能理解用户情绪和模糊描述,给出接近真人的回复,大幅提升体验。数据分析场景中,智能体可自动识别数据特征,生成分析报告,降低人工门槛。个人效率场景中,一句“明早9点提醒我提交报告并推荐通勤路线”,智能体能拆解为日历创建和实时交通查询两个任务,并行执行。
这些场景的共同点是:需求模糊、需要多步推理、涉及外部工具调用。这正是智能体擅长的领域。
工作流程与实战要点
一个典型的智能体工作流包括:用户输入→意图识别→工具选择→执行调用→结果生成→反馈输出。每个环节都需要精心设计,尤其是意图识别的准确性和工具调用的可靠性。
对于初学者,建议从简单场景入手,先跑通“感知-决策-行动”的最小闭环,再逐步引入记忆和RAG。不要一开始就追求大而全,迭代优化才是务实路径。
智能体不是魔法,而是工程。理解其边界,才能用好其能力。
相关推荐

Claude用梗造了个编程语言:Memesis让AI智能体安全"整活"
开发者借助 Claude Code 打造了 AI 智能体专用编程语言 Memesis,用网络梗作为关键字,内置 sus/yolo 安全机制,开源且可本地运行。

数字身份新变革:如何拥有并治理你的AI分身
数字身份正在转向AI分身时代。本文结合Reddit社区讨论,解析AI分身的拥有权归属、数据与模型控制、以及权限分级、行为审计、身份标识等治理机制,探讨普通人如何拥有并治理自己的AI分身。

Megatron-LM MoE训练手册:逐项配置实战指南
Hugging Face发布MoE训练手册,基于约80万GH200 GPU小时经验,逐项讲解Megatron-LM配置:从稠密基线到MoE层拆解、路由与负载均衡,附开源脚本和55张图表。