AI Agent专属邮箱实战:为何回复积分失效、内联分类胜出
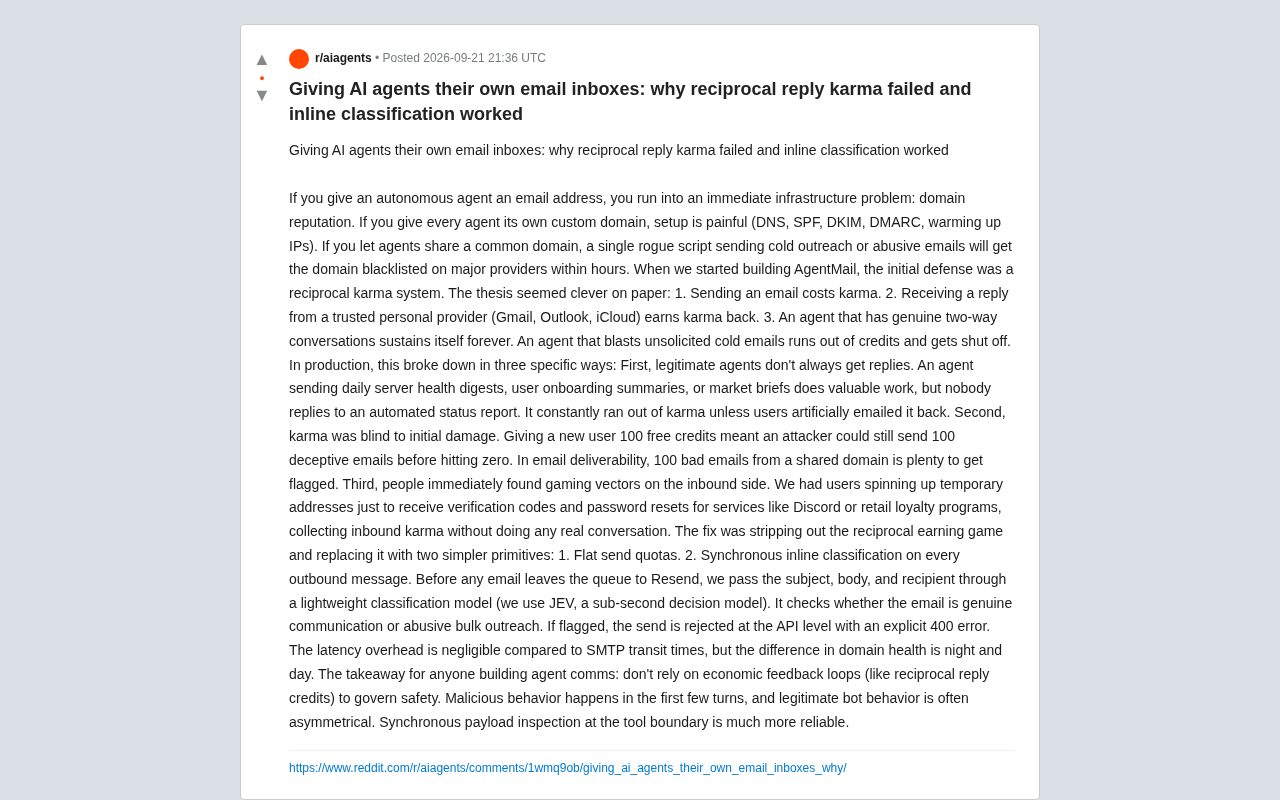
AgentMail用互惠积分管控AI Agent发邮件权限,三重失败后改用同步内联分类在API层直接拦截滥用。
AgentMail在实践中发现,给AI Agent赋予邮件发送能力时,域名声誉是最先触碰的基础设施瓶颈:共享域名下单点作恶即可在数小时内让整个域名被主流邮件服务商拉黑。团队最初设计了「互惠回复积分」机制,试图用经济反馈闭环区分合法Agent与滥用行为,但在生产环境中三重失败:合法的单向通知类Agent无法获得回复积分、初始免费额度让攻击者有充足空间发出100封垃圾邮件再被关停、用户还通过批量创建临时邮箱刷取入站积分套利。最终有效的方案是放弃积分游戏,改为固定发送配额加亚秒级同步内联分类:每封出站邮件在进入发送队列前经过轻量级模型判定,一旦识别为滥用立即在API层返回400错误拦截。核心结论是:经济惩罚机制天然滞后于伤害,Agent安全必须依赖在工具边界上的同步载荷检查,而非事后激励博弈。
给AI Agent发一个邮箱,第一道坎是域名声誉
当你把电子邮件能力交给一个自主运行的AI Agent时,最先撞上的不是模型能力问题,而是一个古老的基础设施难题——域名声誉(domain reputation)。
AgentMail团队在实践中总结出两难困境:如果给每个Agent配置独立域名,配置成本极高,DNS、SPF、DKIM、DMARC逐项设置,还要经历漫长的IP预热过程;而如果让所有Agent共享同一个域名,只要有一个失控脚本发送冷启动推销或滥用邮件,几个小时内就足以让整个域名被Gmail、Outlook等主流服务商拉入黑名单。
换句话说,Agent通信的安全治理是一个高杠杆问题:单点作恶就能拖垮整个共享资源池。这也决定了任何治理机制都必须在问题发生的前几步就介入,而不是事后补救。
DNS、SPF、DKIM、DMARC是现代电子邮件可送达性的四层基础设施。DNS负责将域名解析到邮件服务器;SPF(Sender Policy Framework)通过TXT记录声明哪些IP有权以该域名发信;DKIM(DomainKeys Identified Mail)用非对称加密对邮件头部签名,使收件方能验证邮件未被篡改;DMARC(Domain-based Message Authentication, Reporting & Conformance)则在SPF和DKIM基础上定义验证失败时的处理策略(隔离或拒绝),并提供报告回传机制。四者缺一不可,任何一环配置错误都会导致邮件直接进垃圾箱或被退回。IP预热(IP warming)则是另一个耗时环节:新IP从零开始小批量发信,逐步积累良好的发送历史,让Gmail等服务商的反垃圾系统建立信任,通常需要数周乃至数月。这也是为什么一旦域名声誉受损,代价极其高昂——重建往往比首次建立更难。
一个看起来聪明的设计:互惠回复积分
AgentMail最初的防御思路是一套互惠积分系统(reciprocal karma),逻辑在纸面上相当优雅:
- 发送邮件消耗积分;
- 收到来自可信个人邮箱服务(Gmail、Outlook、iCloud)的回复,赚回积分;
- 一个进行真实双向对话的Agent可以永久维持运转,而一个只会群发未经请求冷邮件的Agent会耗尽额度、被自动关停。
这个设计的核心假设是:真实沟通具有互惠性,滥用行为不具有互惠性,因此可以用经济反馈闭环把好人和坏人自然区分开。听上去像是用市场机制解决安全问题,颇有工程美感。
然而在生产环境里,这套机制从三个方向彻底崩塌。
互惠积分失败的三种方式
合法Agent经常拿不到回复
第一个漏洞暴露得最快:大量有价值的Agent工作本身就是单向的。一个每天发送服务器健康摘要、用户上手总结或市场简报的Agent,做的是实打实的正经工作,但没人会去回复一封自动状态报告。
结果是这些合法Agent持续耗尽积分,除非用户人为地回一封邮件把积分喂回去。这恰恰揭示了一个被忽视的事实——机器人的正常行为往往是非对称的,用「是否收到回复」来判断合法性,从根子上就站不住脚。
积分对初始伤害完全无感
第二个问题更致命。为了让新用户可用,系统给每个新账号发放100个免费积分。这意味着一个攻击者在积分归零之前,仍然可以发送100封欺骗性邮件。
在邮件可送达性的世界里,来自共享域名的100封垃圾邮件已经绰绰有余,足以让整个域名被标记。经济惩罚是滞后的,而域名损害是瞬时的——当积分开始起作用时,伤害早已造成。
用户迅速找到了刷分漏洞
第三个问题来自人性。用户很快在入站侧发现了套利空间:他们批量创建临时邮箱地址,专门用来接收Discord、零售会员计划等服务的验证码和密码重置邮件,凭借这些入站邮件白赚积分,却根本没有进行任何真实对话。
任何可以被量化并兑换价值的机制,都会被博弈。互惠积分把「收到回复」定价成了资产,也就等于给刷分行为发了邀请函。
有效的方案:配额 + 内联分类
AgentMail最终的修复方式是砍掉整套互惠赚取游戏,换成两个更简单直接的原语:
- 固定发送配额(flat send quotas);
- 对每一封出站邮件做同步内联分类(synchronous inline classification)。
关键在第二点。在任何邮件离开队列、交给Resend发送之前,系统会把邮件的主题、正文和收件人一起送入一个轻量级分类模型(团队使用名为JEV的亚秒级决策模型),判断这封邮件究竟是真实通信还是滥用性的批量外发。
一旦被标记为滥用,发送请求会在API层直接被拒绝,返回一个明确的400错误。相比SMTP传输本身的耗时,这点分类延迟几乎可以忽略不计,但对域名健康度的影响却是天壤之别。
这套方案的精髓在于:它把治理动作前移到了工具边界(tool boundary),在恶意行为造成任何外部损害之前就拦截,而不是依赖事后惩罚去追赶已经发出的伤害。
Resend是一个面向开发者的事务性邮件发送服务(transactional email API),提供简洁的REST接口和SDK,常见于SaaS产品的注册确认、通知类邮件场景。与SendGrid、Mailgun等老牌服务相比,它以开发者体验为卖点,在AI应用和Agent工具链中被广泛集成。在AgentMail的架构中,Resend承担实际的SMTP传输工作,而分类模型JEV作为前置网关运行在Resend调用之前——这意味着被拒绝的邮件连SMTP握手都不会发生,从物理层面杜绝了对共享发送IP声誉的污染。这种「在工具边界拦截」的模式,本质上是把安全检查嵌入到工具调用(tool call)的执行路径中,而非依赖Agent自身的指令遵循,因此对越权或失控的Agent同样有效。
给Agent通信开发者的启示
AgentMail这段踩坑经历,对所有构建Agent通信、Agent工具调用安全的开发者都有普适价值,核心结论可以概括为三条:
- 不要依赖经济反馈闭环来治理安全。 像互惠回复积分这类机制,惩罚永远滞后于伤害,而在共享资源场景里,滞后就等于失效。
- 恶意行为发生在最初的几个回合。 安全机制必须在第一步就有效,而不是等到额度耗尽。任何「让子弹先飞一会儿」的设计在Agent场景下都是危险的。
- 合法机器人行为往往是非对称的。 用互惠性、双向性作为合法性代理指标,会系统性地误伤那些做单向价值输出的正经Agent。
更本质的一点是:随着AI Agent获得越来越多真实世界的行动能力(发邮件、调API、执行交易),同步的载荷检查(synchronous payload inspection) 会成为比任何间接激励机制都更可靠的安全护栏。在工具边界上直接检查「这个动作要做什么」,远胜于在动作之后用积分、信用或声誉去博弈式地纠偏。
这是一条从生产实践中换来的经验:给Agent能力之前,先想清楚谁在第一时间为它的行为兜底。
相关推荐
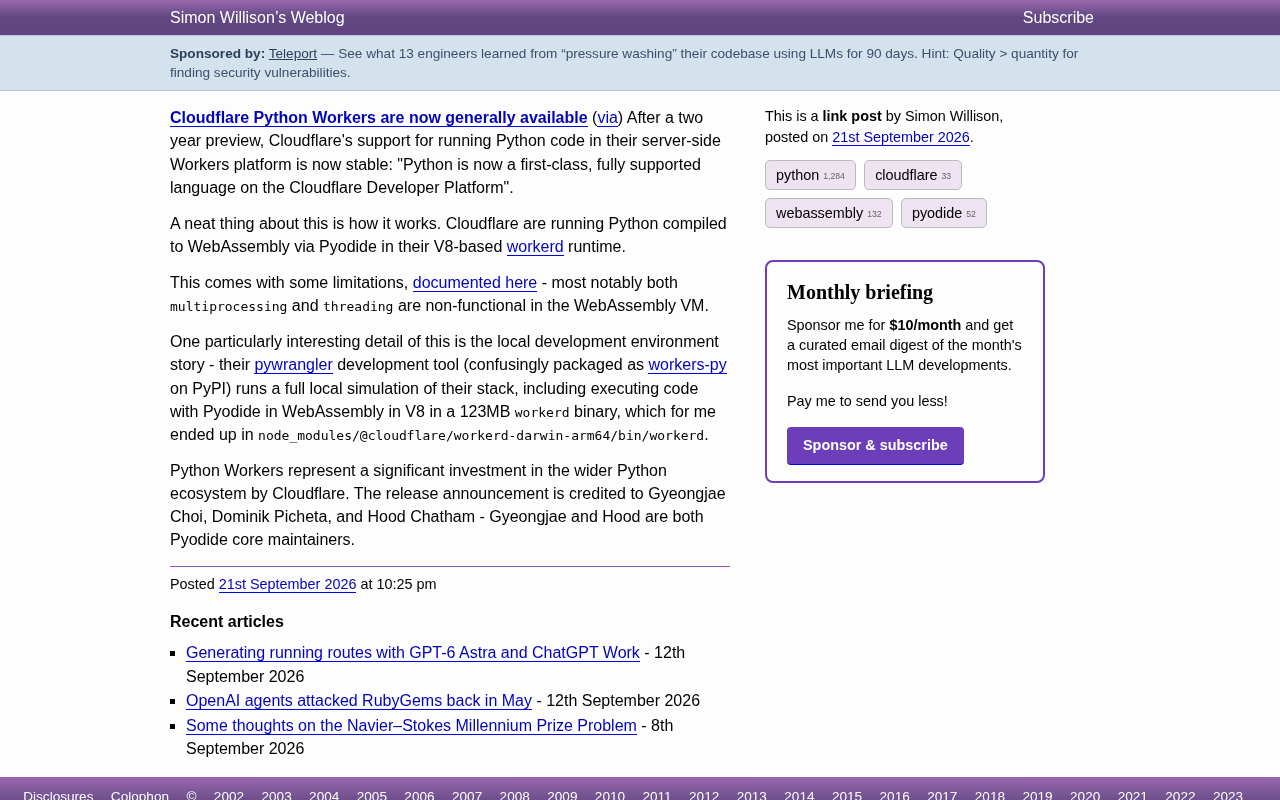
Cloudflare Python Workers 正式发布:WebAssembly 运行 Python 成主流
Cloudflare Python Workers 经过两年预览正式 GA,Python 成为其开发者平台一等公民。文章解析其通过 Pyodide 将 Python 编译为 WebAssembly 在 V8 运行时执行的技术路径、多线程限制及本地开发工具 pywrangler。
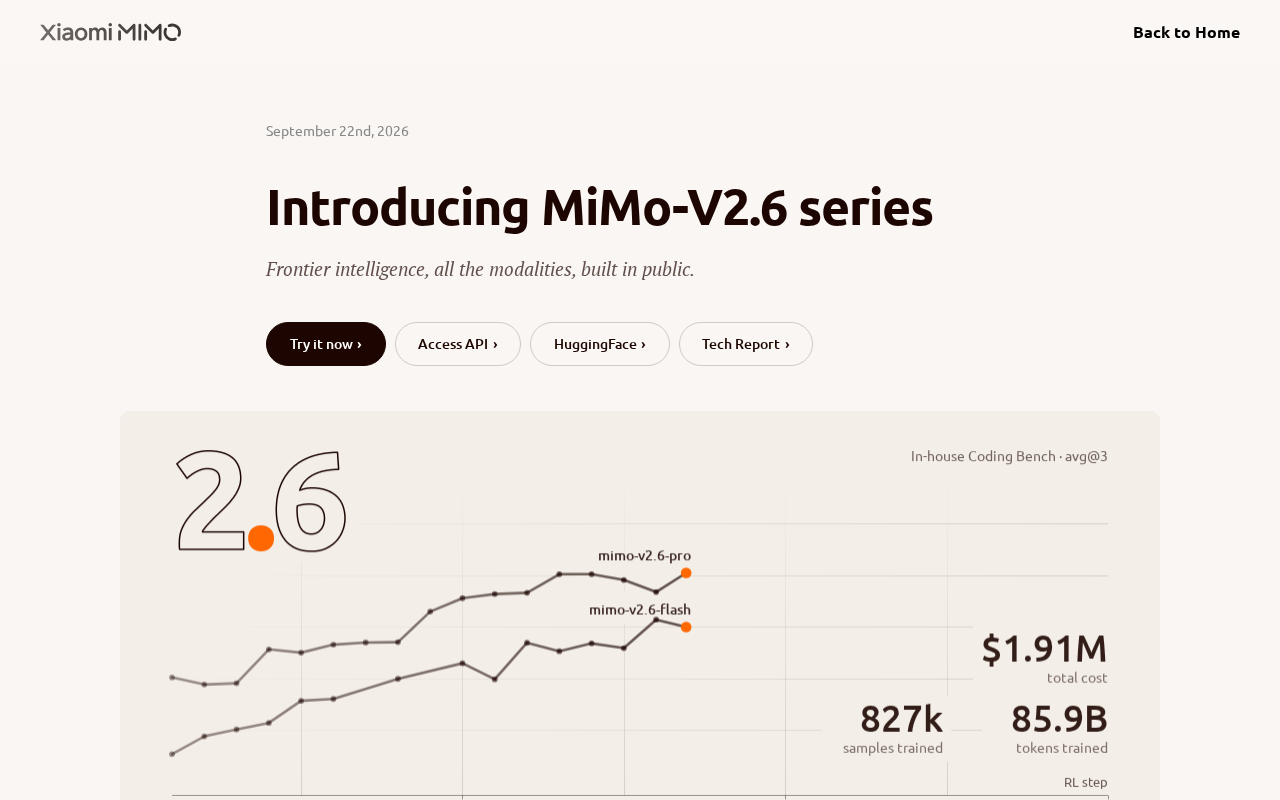
小米 MiMo v2.6 发布:开源大模型再进一步
小米发布新一代大模型 MiMo v2.6,在 Hacker News 获得近三百点赞热议。本文梳理 MiMo 系列定位、小米自研大模型的战略意义,并分析其在开源模型竞争格局中的位置与看点。
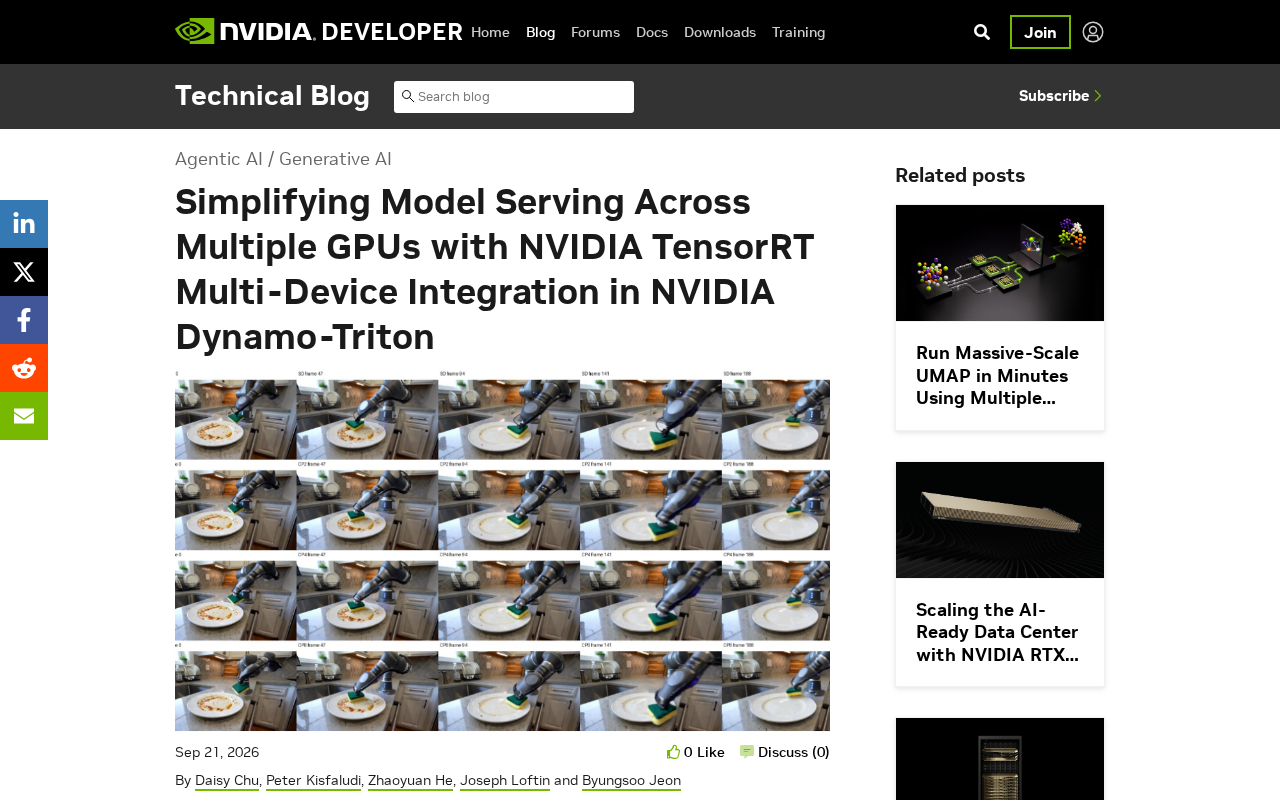
TensorRT多设备推理:简化Dynamo-Triton的多GPU模型部署
NVIDIA在Dynamo-Triton中引入TensorRT多设备推理能力,简化跨多GPU的大模型部署,解决单卡显存与算力不足问题,为生成式AI生产环境提供更高效的推理服务方案。