小米 MiMo v2.6 发布:开源大模型再进一步
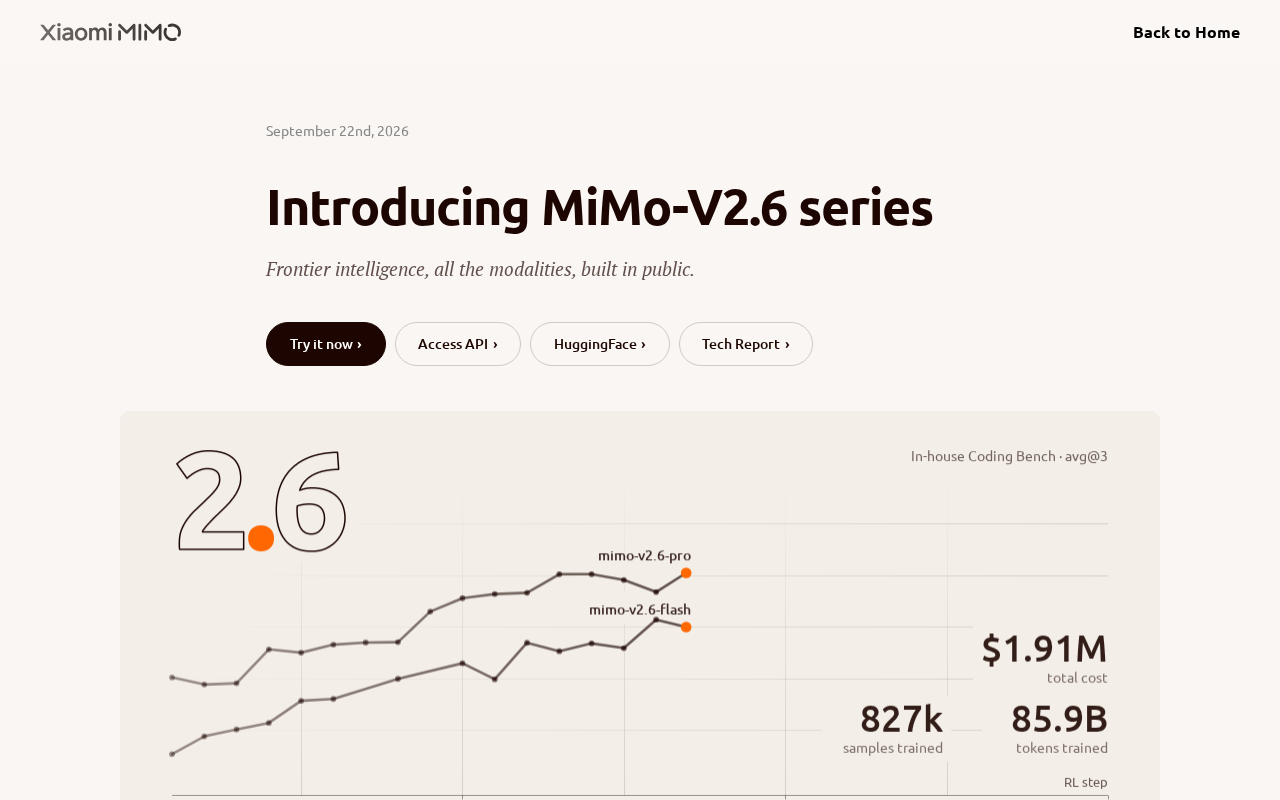
小米发布大模型MiMo v2.6,在Hacker News引发海外技术社区关注,但技术细节尚待披露。
小米推出大语言模型MiMo v2.6,在国际技术社区Hacker News上获得近300点赞和百余条讨论,反映出海外开发者对中国厂商AI动作的持续兴趣。MiMo系列对小米而言具有清晰的战略价值:凭借手机、IoT、汽车构成的庞大硬件生态,小米有真实场景和用户反馈闭环,也有明确的端侧部署落地需求。当前,阿里、深度求索、月之暗面等中国团队的模型已在开源榜单上形成激烈竞争,MiMo v2.6是这一格局中的又一新入局者。然而,目前技术白皮书和完整基准测试数据尚未公开,参数规模、开放许可等关键信息仍待披露,因此尚不宜对其能力作出最终评判。
小米推出了新一代大模型 MiMo v2.6,并在 Hacker News 上引发了不小的关注——发布后短时间内获得 293 个点赞和超过 133 条评论。这一热度反映出海外技术社区对中国厂商在大模型领域动作的持续兴趣。
需要说明的是,目前公开可获取的信息主要来自小米官方页面与社区讨论,具体的技术白皮书、完整基准测试数据尚待进一步披露。本文基于现有信息对 MiMo v2.6 做一个初步梳理,并结合行业背景进行分析。
MiMo 系列的定位
MiMo 是小米推出的大语言模型系列,从命名来看,v2.6 是在 v2 系列基础上的一次迭代升级,而非大版本的重构。小版本号(2.6)通常意味着这是一次以能力增强、性能优化或问题修复为主的更新,而非架构层面的颠覆。
对小米而言,自研大模型有着清晰的战略意义。作为一家同时布局手机、IoT、汽车的硬件巨头,小米需要一套可控的 AI 能力底座,来支撑其庞大的终端生态——从手机上的语音助手、影像处理,到智能家居的自然语言交互,再到智能座舱场景。拥有自主可控的模型,意味着在成本、隐私和产品整合上都有更大的主动权。
为何登上 Hacker News 热榜
这条发布能在 Hacker News 获得近三百点赞,本身就值得关注。Hacker News 的读者群体以工程师和技术创业者为主,他们对模型的实用性、开放程度和技术细节格外敏感。
中国厂商的大模型近来在国际社区频繁获得讨论,一方面是因为部分模型选择了开源或开放权重的路线,降低了海外开发者的尝试门槛;另一方面,这些模型在特定基准测试上的表现,往往能与主流开源模型(如 Llama、Qwen、DeepSeek广告 等)形成直接对比,激发社区的评测和讨论热情。
MiMo v2.6 能进入热榜,说明它至少在某些维度上提供了值得社区一试的价值——无论是性能、开放性还是应用场景的契合度。
开源模型竞争格局中的一环
把 MiMo v2.6 放到当下的大模型生态中看,它是中国厂商密集发布的又一个案例。过去一段时间里,来自阿里、深度求索、月之暗面等团队的模型持续刷新开源榜单,形成了相当激烈的竞争态势。
在这样的背景下,小米的入局有几个看点:
硬件生态的天然优势
与纯软件或纯研究导向的团队不同,小米有海量的真实设备和用户场景。这意味着模型可以在实际使用中获得反馈闭环,同时也有明确的落地出口——不必担心"模型做出来没地方用"的问题。
端侧部署的想象空间
对小米这类硬件厂商而言,如何让模型在手机、车机等资源受限的终端上高效运行,是核心命题之一。如果 MiMo 系列在轻量化、推理效率上有所侧重,将直接服务于其端侧 AI 战略。不过这一点目前尚需官方的技术细节来验证。
端侧部署(On-device inference)是指将模型运行在手机、平板、车机等本地设备上,而非依赖云端服务器。这一方向的核心挑战在于:主流旗舰手机的内存通常为12-16GB,远低于运行大参数模型所需;同时移动端的算力(NPU/GPU)与数据中心GPU之间存在数量级差距。为此,业界普遍采用量化(Quantization,将模型权重从FP16压缩至INT8甚至INT4)、知识蒸馏(用大模型训练小模型)和结构剪枝等技术来压缩模型体积并提升推理速度。苹果、高通、联发科等芯片厂商也在其最新SoC中专门针对LLM推理加入了优化。对小米而言,澎湃芯片与自研大模型的协同调优,是其端侧AI战略潜在的差异化方向。
开放程度决定影响力
一个模型能在开发者社区扩散多远,很大程度上取决于它的开放策略——是提供开放权重、允许商用,还是仅限 API 调用。这也是社区评价此类发布时最关心的问题之一。
当前中国厂商主导的开源大模型竞争格局,主要围绕几个维度展开:模型参数规模(从7B到数百B不等)、推理能力(数学、代码、逻辑)、多语言支持,以及开放许可证的宽松程度。阿里的Qwen系列以多模态和长上下文见长,深度求索(DeepSeek)则因在数学推理和代码能力上对齐甚至超越GPT-4而引发国际社区广泛关注,月之暗面的Kimi系列侧重超长上下文窗口。这一赛道的激烈程度,使得任何新发布的模型都必须在某个细分能力上有明显亮点,否则难以在信息密度极高的开发者社区中脱颖而出。Hugging Face的Open LLM Leaderboard等第三方评测榜单,已成为这些模型争夺影响力的重要战场。
理性看待:等待更多数据
在缺乏完整基准测试和技术报告的情况下,对 MiMo v2.6 的能力下结论为时尚早。社区讨论的热度可以说明关注度,但不能等同于模型质量的最终评判。
对开发者和关注者来说,几个值得继续追踪的问题包括:模型的参数规模与架构、在主流评测集上的具体成绩、是否开放权重及许可条款、以及针对端侧场景的优化程度。这些信息将决定 MiMo v2.6 究竟是一次常规的版本迭代,还是小米在 AI 竞赛中的一次有分量的落子。
随着官方进一步披露细节和社区评测陆续出炉,我们会对这款模型有更清晰的判断。在此之前,将它视为中国大模型军团中又一个值得留意的名字,或许是最恰当的姿态。
相关推荐

Claude Code + Skills 一键生成测试用例实战全解析
本文详解如何用 Claude Code + Skills 一键从需求文档生成落地级别测试用例。通过拆分需求、提取测试点、生成用例三阶段流水线,配合 AI 自动评审,把测试用例编写从数天压缩到十分钟内,效率提升数倍。

Claude Code与Codex的Agent Skill实战:从入门到企业级AI研发
深入解析Claude Code与Codex的Agent Skill实战方法,涵盖Skill技能架构、三款主流AI编程工具选型、大模型搭配及企业级代码质量提升,助你实现团队级AI研发提效。

8万条文生图提示词数据集:测试模型与角色LoRA的实用方案
一款包含超8万条文生图提示词的开源数据集在HuggingFace发布,配套ComfyUI工作流可直接对接云端数据,为测试AI模型和角色LoRA提供批量化解决方案。文章解析其技术思路与对模型评估工作流的启示。