AI Agent总用旧决策?问题不在检索,而在记忆冲突
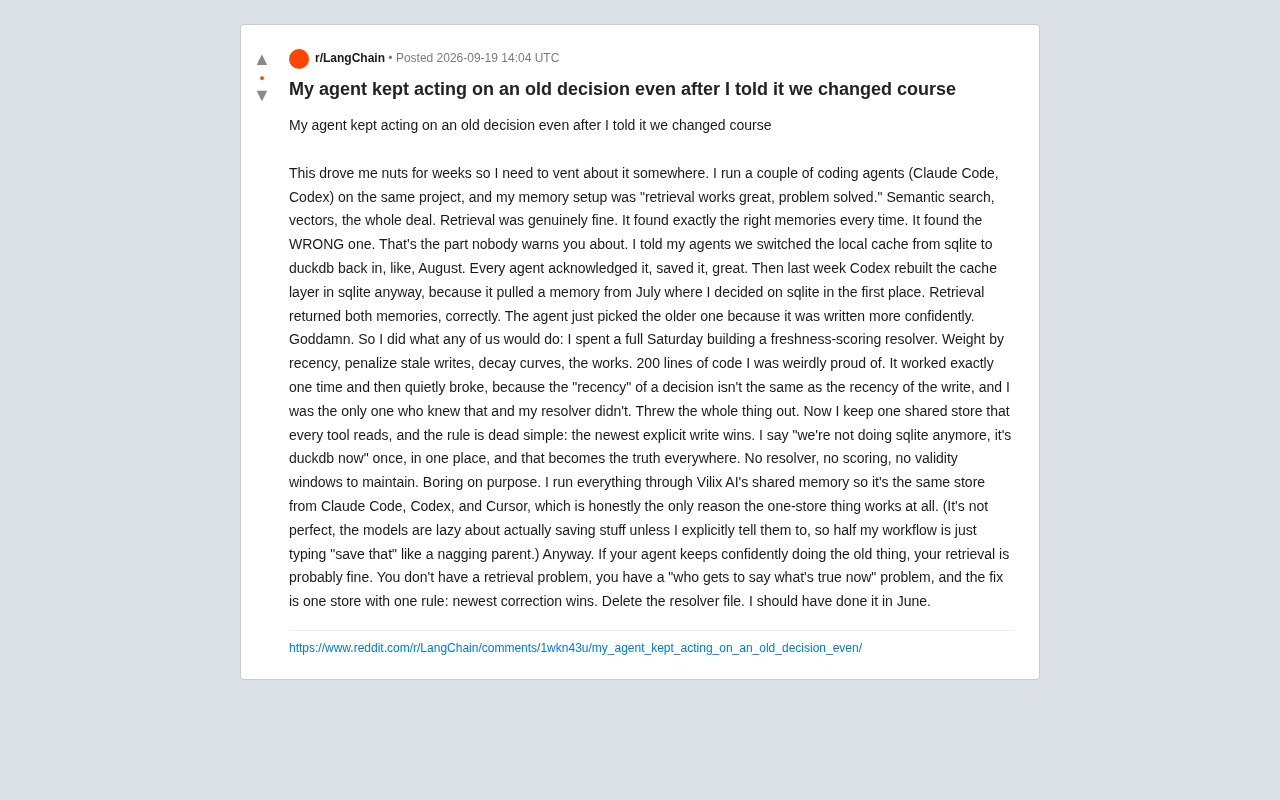
多AI智能体按旧决策行事,根因是记忆冲突裁决失败,而非检索精度不足。
一位同时使用Claude Code、Codex和Cursor的开发者分享了一次典型踩坑经历:他在八月明确告知所有智能体将本地缓存从SQLite切换到DuckDB,但Codex随后仍基于七月的旧记忆重建了SQLite缓存层——原因是检索系统同时返回了新旧两条记忆,而智能体选择了"写得更自信"的旧版本。为修复此问题,他构建了一套200行的新鲜度评分解析器,结果因无法区分"决策时间"与"写入时间"而迅速失效。最终他删除全部解析器代码,改用极简方案:所有工具共享同一个存储,规则只有一条——最新的明确写入胜出。这次经历揭示出多智能体系统的深层挑战:问题本质不是检索精度,而是"谁有权定义当前真相"的归属问题,单一可信源加上简单裁决规则,往往比精巧算法更可靠。
有个问题困扰了很多同时使用多个编码智能体(Coding Agent)的开发者:明明已经告诉AI改变了技术方案,它却依然按照过时的旧决策行事。一位Reddit开发者最近分享的踩坑经历,精准戳中了这个被大多数人忽视的痛点——问题往往不出在检索环节,而是出在"谁说了算"的记忆冲突上。
检索没问题,选错了才是灾难
这位开发者在同一个项目上同时跑着 Claude Code 和 Codex 两个智能体,他的记忆方案是典型的"语义搜索 + 向量库"组合,检索能力本身相当可靠。用他的原话说:"检索确实没毛病,每次都能找到完全正确的记忆。它找到了错误的那一条——这才是没人提醒你的部分。"
具体的故事是这样的:他在八月份告诉所有智能体,本地缓存已经从 SQLite 切换到了 DuckDB。每个智能体都确认收到并保存了这条信息。结果上周,Codex 却重新用 SQLite 重建了整个缓存层,因为它翻出了一条七月份的记忆——那时他最初决定采用 SQLite。
关键在于:检索系统正确地返回了新旧两条记忆,但智能体选择了较旧的那一条,仅仅因为它"写得更自信"。这暴露出一个反直觉的事实——检索的准确性和决策的正确性完全是两回事。当记忆库里同时存在相互矛盾的信息时,检索得再准也没用,真正的难题是如何裁决哪条才代表当前的"真相"。
语义搜索与向量库的组合是目前AI记忆系统的主流架构。向量库(如Pinecone、Chroma、Weaviate等)将文本片段转化为高维数值向量并存储,查询时通过计算向量相似度(余弦相似度或欧氏距离)来找到语义上最相关的记忆条目,而非依赖关键词精确匹配。这种方式非常擅长处理模糊查询——即使问法不同,只要语义接近就能命中。然而,向量相似度本质上衡量的是"内容有多像",而非"哪条更权威"或"哪条更新"。在同一主题下存在多条相互矛盾的记录时,检索系统可能同时召回所有版本,却没有内置机制判断哪条代表当前决策。这正是这位开发者遭遇的核心困境:检索系统完美完成了自己的工作,失败出现在检索之后的裁决环节。
200行"新鲜度评分器"的失败
面对这个问题,这位开发者做了大多数工程师会做的事:花了整整一个周六,构建了一套"新鲜度评分解析器"(freshness-scoring resolver)。按时间近远加权、惩罚陈旧写入、加入衰减曲线,一整套复杂机制,足足 200 行代码,他一度对此颇为得意。
然而这套系统只正常工作了一次,随后就悄悄失灵了。原因很微妙:一个决策的"新鲜度",和这条记忆被"写入"的时间,根本不是一回事。 只有他自己清楚这一点,而他写的解析器并不理解。
这个失败案例很有代表性。当我们试图用算法自动裁决记忆的有效性时,往往陷入了过度工程化的陷阱——试图让系统"猜测"哪条信息更该被信任,却忽略了决策的真实语境远比时间戳复杂。最终,他把整套解析器代码全部删掉了。
一个存储,一条规则:最新的明确修正胜出
推倒重来之后,他采用的方案朴素到近乎无聊:维护一个所有工具共享的存储,规则只有一条——最新的明确写入胜出(the newest explicit write wins)。
他只需要在一个地方说一次"我们不再用 SQLite 了,现在是 DuckDB",这就成为所有工具眼中的唯一真相。没有解析器,没有评分机制,也不用维护什么有效期窗口。这套"故意做得很无聊"的设计,反而稳定可靠。
他通过 Vilix AI 的共享记忆功能来实现这一点,让 Claude Code、Codex 和 Cursor 三个工具读写同一个存储——他坦言这也是"单一存储"方案能跑通的唯一前提。当然方案并不完美:"模型很懒,除非我明确要求,否则它们不会主动保存东西,所以我一半的工作流就是像唠叨的家长一样不停打字说'把这个存下来'。"
"单一可信源"(Single Source of Truth,SSOT)是软件工程中的经典架构原则,指系统中任何一项数据都只有一个权威来源,所有其他模块需要时直接读取该来源,而非各自维护副本。这一原则在多系统协作场景下尤为重要——当多个工具或服务各自缓存同一份数据时,副本之间的不一致几乎是必然的。将该原则应用到多智能体记忆系统,意味着放弃让每个AI工具维护独立记忆库的做法,转而让所有工具读写同一个共享存储。写入冲突的裁决规则越简单越好:时间戳最新的显式覆盖指令获胜,无需评分、无需投票、无需语义推断。这种"刻意无聊"的设计牺牲了灵活性,换来的是可预测性——对于需要多个AI协同工作的长期项目,可预测性的价值远超聪明的算法。
核心启示:你面对的是"真相归属"问题
这篇分享最有价值的洞察,是对问题本质的重新定义。开发者总结道:"如果你的智能体总是自信地干着旧的事情,你的检索大概率没问题。你面对的不是检索问题,而是'现在谁有权定义什么是真的'的问题。"
这个视角对于构建多智能体系统的开发者极具参考意义。随着一个项目中并行运行的 AI 工具越来越多,记忆的一致性和冲突裁决会成为比检索精度更棘手的挑战。与其投入精力打造复杂的自动裁决算法,不如建立一个单一可信源(single source of truth),用最简单的规则维持一致性。
他最后的建议直白而带着几分自嘲:"删掉那个解析器文件。我早在六月就该这么做了。"
对于正在搭建 AI 记忆系统的团队来说,这条经验或许值得记在心里:当多个智能体共享记忆时,简单明确的"最新修正优先"规则,往往胜过精巧却脆弱的评分机制。有时候,工程上最好的答案就是刻意保持无聊。
相关推荐

AI编程为何离不开Git?从版本回退到AI辅助命令全解析
Git是AI编程的必备工具。本文解析Git分布式版本控制在AI编程中的价值,包括应对AI幻觉的版本回退、分支管理等核心操作,以及如何用豆包、AI输入法等工具快速生成Git命令,帮助新手零基础入门。

拒绝AI胡编:一款"说不了谎"的求职信生成器是如何炼成的
一位开发者因AI求职信工具凭空捏造其Kubernetes经验和管理经历而屡遭拒信,于是打造了CoverCraft——通过代码计算评分、GitHub提交记录背书、对抗性审查与人工审批四重机制,构建一款"无法说谎"的AI求职信生成器。本文解析其对抗AI幻觉的工程设计。
Perplexity携手美国运通:为小企业主打造即用型AI技能库
Perplexity携手美国运通:为小企业主打造即用型AI技能库
Perplexity 联合美国运通推出面向小企业卡会员的即用型 AI 技能库,内置现金流预测、营销活动生成等预构建工作流,用户无需编写提示词即可让 AI 处理日常业务任务。