AI Gateway推出虚拟模型:模型切换无需改代码
Vercel AI Gateway 推出虚拟模型,将模型选择与配置从代码迁移到网关层集中治理。
Vercel AI Gateway 推出 Virtual Models 功能,把「模型字符串 + 配置」抽象为一个可复用 ID,使模型切换从改代码发版变为在网关侧编辑配置,几分钟内所有调用方自动生效。文章指出该设计对 Agent 团队尤其有价值:每个任务可绑定专属模型配置,fallback、Zero Data Retention、tags 等设置随虚拟模型切换而保留,但 provider 专属选项需在换供应商时重新复查。虚拟模型同时是治理单元,其设置优先级高于请求中的同名配置,调用方无法覆盖平台与安全团队设定的故障转移策略和数据保留要求。面对 90 天内 125 个新模型上线的迭代节奏,虚拟模型把模型选择变成了一项可集中运维的工作,并建议通过候选虚拟模型跑评测、保留回滚路径。
Vercel AI Gateway 近日推出了 Virtual Models(虚拟模型) 功能。它把「模型字符串 + 配置」抽象成一个可复用的 ID,让模型切换从代码层迁移到网关层。对正在构建 Agent 应用的团队来说,这是一个值得关注的工程实践。
虚拟模型解决了什么问题
AI Gateway 本身已经让模型调用变得简单:传入任意模型 ID,网关会路由到健康的 provider,失败时自动回退。但这行模型字符串仍然写在代码里,每次更换模型通常意味着重新部署。
虚拟模型改变了这一点。你为某个任务创建一个 ID,例如 vmc/coding-agent,然后在 AI Gateway 中配置它背后使用哪个模型、使用什么参数:
vercel ai-gateway virtual-models create coding-agent \
  --model anthropic/claude-opus-5.5 \
  --config '{"speed":"fast","zeroDataRetention":true}'
之后在代码里把这个 ID 当模型字符串使用即可:
import { streamText } from 'ai';

const result = streamText({
  model: 'vmc/coding-agent',
  prompt: 'Remove the deprecated API calls from this module.',
});
需要换模型时,编辑虚拟模型指向新的模型。所有调用该 ID 的应用和 Agent 会在几分钟内自动采用新配置,无需改动代码或重新部署。
AI Gateway 是 Vercel 提供的一层模型路由中间件,位于应用代码与各模型供应商(Anthropic、OpenAI、Google 等)之间。应用只需向网关传入一个模型标识字符串,网关负责选择健康的 provider 端点、在超时或报错时自动回退到备用模型,并统一处理计费、可观测性与数据保留策略。由于其接口兼容 AI SDK 以及 OpenAI、Anthropic 兼容 API,团队可以在不重写调用代码的前提下更换底层供应商。虚拟模型正是建立在这层路由能力之上:网关原本已能解析『模型字符串 → 真实模型』的映射,虚拟模型只是把这个映射变成了可在控制台编辑、可版本化管理的配置对象。
一个任务一个模型
原文给出了一个有说服力的场景:客服工单分诊这类 Agent 任务每小时可能运行数百次,成本敏感;而法律合同审查可能一天只跑几次,但需要高推理能力。
虚拟模型让每个任务拥有专属的模型配置,并且可以随时间演进。你可能没注意到,fallback、Zero Data Retention、tags 等设置会跟随虚拟模型一起切换;但 provider 专属选项按 provider 生效——当虚拟模型从 Anthropic 模型切换到 OpenAI 模型时,Anthropic 特有的设置不再适用。原文明确提醒:每次切换 provider 时都应复查 provider options。
对于承载生产流量的虚拟模型,原文建议先建一个候选虚拟模型(如 vmc/coding-agent-candidate)指向新模型,跑完评测后再切换;如果质量下降,把原虚拟模型指回旧模型即可。
Zero Data Retention(零数据保留) 指供应商承诺不将请求与响应内容持久化存储,处理完成后即丢弃,通常用于涉及合同、医疗记录、内部代码等敏感内容的场景。disallowPromptTraining 则是禁止供应商将请求数据用于模型训练。这两项都属于数据治理层面的开关,在 AI Gateway 中既可写在请求里,也可固化在虚拟模型配置上。与之相对,fallback 是故障转移机制:当首选模型返回错误、限流或超时时,网关自动改用列表中的下一个模型。tags 是附加在请求上的标签,用于把花费和调用量归集到具体任务或团队,是成本分摊与账单分析的基础。原文强调这些设置会随虚拟模型一起切换,原因在于它们属于网关统一管理的横切配置,而非某个供应商特有的参数。
集中治理:谁能改、改了算什么
虚拟模型同时是一个治理单元。团队成员都可以调用虚拟模型,但角色权限控制谁可以修改它。平台和安全团队可以集中治理和测试模型与设置,同时让各团队在模型发布后快速获得访问权限。
一个关键设计是:虚拟模型上的设置优先于请求中的同名设置。调用方无法覆盖你设定的 provider 顺序、fallback 或服务层级。例如 vmc/storefront-assistant 的 fallback 模型集中配置后,所有使用该 ID 的应用都会采用同一套故障转移配置,即使请求里指定了不同的 fallback。
安全策略同样被强制执行:如果虚拟模型要求 Zero Data Retention 或不允许使用会训练请求数据的 provider,即使请求显式把 zeroDataRetention 或 disallowPromptTraining 设为 false,这些配置依然生效。虚拟模型上的 tags 也会替换请求中携带的 tags,从而让花费准确归集到任务上。Virtual Models 页面会展示每个任务的请求数、花费和成功率。
provider options 指各模型供应商特有的请求参数,例如 Anthropic 的 extended thinking 预算、OpenAI 的 reasoning effort 或特定缓存控制字段。它们在 AI SDK 中通过独立的 providerOptions 字段传入,语义与网关级的 fallback、tags 等通用配置不同,无法跨供应商通用。因此当虚拟模型从 Anthropic 模型切换到 OpenAI 模型时,原先针对 Anthropic 写入的 provider options 会被忽略或报错,必须逐项核对并替换为新供应商支持的等价参数。这也是原文建议为生产流量先建立候选虚拟模型、跑完评测再切换的工程原因之一:provider options 的不兼容往往不会在类型检查阶段暴露,只能在真实调用中体现。
模型更新速度倒逼架构调整
原文提供了一个直观的数据:过去 90 天里,来自 10 多个实验室的 125 个新模型在 AI Gateway 上线,平均每周约 10 个。在这样的迭代节奏下,模型选择本身正在变成一项需要持续调整的运维工作。
虚拟模型把这项工作的执行位置从代码仓库移到了网关配置,减少了「换模型 = 发版」的摩擦。它还兼容 AI Gateway 上的所有模型类型,包括图像、视频、语音、嵌入和实时模型,并支持 AI SDK 以及 OpenAI、Anthropic 兼容 API。
对于使用 Claude Code、Codex 等编码 Agent 的团队,可以通过 vercel ai-gateway setup 连接,然后在各 harness 的模型选择器或配置中选择虚拟模型。
一些实践建议
虚拟模型的命名最好体现任务语义而非模型名,比如按 coding-agent、support-triage 这类用途命名,避免出现 claude-opus-agent 这种绑定具体模型的 ID。
切换模型前跑评测、保留回滚路径,是把模型更新纳入常规工程流程的关键。集中治理带来的约束也意味着安全团队可以用统一策略覆盖所有调用方,这在多团队共享网关时尤其有价值。
相关推荐
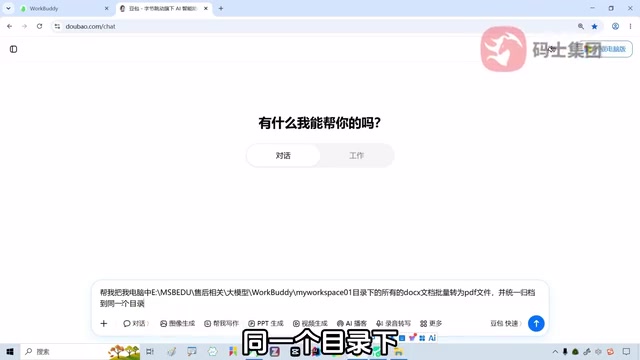
WorkBuddy AI智能体实战:从大模型到Agent的落地差异
通过批量转PDF实战对比,解析WorkBuddy AI智能体与大模型产品的本质差异,涵盖授权执行、积分消耗、场景适配与落地认知,帮你判断Agent工具是否适合当前工作流。
GrokBot之父:月合千个PR,智能体自动合并的工程心法
SpaceX背景AI工程师分享GrokBot工作流:一个月合入约千个PR,智能体自动合并20个。核心方法论围绕验证技能、EVAL测试、Dune架构与硬性CI约束,揭示如何从本地信任走向云端代理自动化。
Bright Data评测:免费额度、AI智能体MCP服务器与定价
Bright Data 提供免费 5000 额度、开源 MCP 服务器及代理/抓取 API。了解其定价模式、AI 助手集成方式和合规注意事项。