AI MAX+ 395部署Qwen3大模型:GFX1151引擎实测优化解析
UP主为AMD AI MAX+ 395平台深度优化推理引擎,Qwen3大模型预填充提升15%并统一双格式支持。
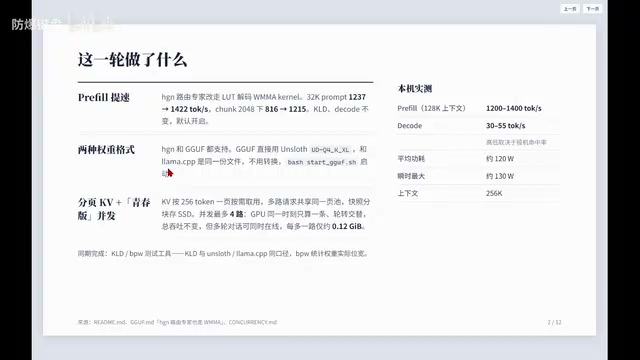
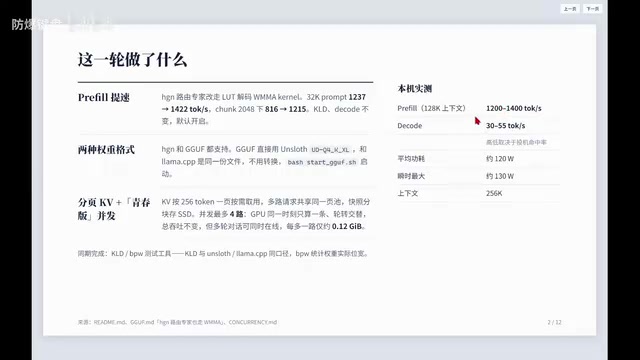
B站UP主「防暴键盘」为自研开源推理引擎 GFX1151 engine 发布重要更新,专门针对 AMD AI MAX+ 395 统一内存平台运行 Qwen3 系列 MOE 大模型(约235B参数)进行深度优化。核心改动包括:重写 MOE 内核将预填充性能从约1200 PP提升至1400 PP(约15%),但该优化高度依赖 Qwen3 的特殊模型结构,无法通用化;统一支持 HGN(FP8量化,约47.7GB,性能优先)和 GGUF(Q4量化,约26.8GB,质量优先但多占10GB显存且Windows不可用)两种权重格式;新增分页 KV 缓存与多请求并发能力。低功耗实机(约120W)测试下,Windows 平台128K上下文预填充约1000 PP,显存占用约94.9GB,在96GB可用显存的硬件上保留约1GB余量,是针对性工程优化的典型案例。
B站UP主「防暴键盘」近期更新了自研开源推理引擎 GFX1151 engine 的部署方案,专门针对 AMD AI MAX+ 395 平台上运行 Qwen3 系列大模型(视频中称为 Qwen3-Flash-Next)进行了深度优化。相比上一次的更新,这次改动幅度较大,作者甚至专门制作了PPT来讲解。本文梳理其中的核心技术要点与实测数据,供有兴趣在移动/桌面平台本地部署超大模型的读者参考。
MOE 内核优化:预填充性能大幅提升
本次更新最核心的改动是对 MOE(混合专家)内核 的重写。作者提到,之前的 MOE 内核存在已知的性能缺陷,预填充(Prefill)性能大约停留在 1200 PP 左右,但一直无法解决——即使用 Kimi 等模型辅助也搞不定。这次改用 GPT-OSS 5.5(原文提及的"OPAS 5.5")才最终攻克,将预填充性能从 1200 优化到了 1400 左右。
作者特别强调,这样的性能提升具有一定的特殊性:"这个模型的结构比较特殊,所以它才能够做到这样一个还算可得以的速度。"换句话说,同样的优化手段并不能直接迁移到其他模型上——这已经不是单纯优化内核就能解决的问题,而是依赖于该模型独特的结构特性。
MOE(Mixture of Experts,混合专家模型)是一种稀疏激活的神经网络架构:模型内部有大量"专家"子网络,但每次推理只激活其中一小部分。Qwen3 系列采用这一架构,使得参数量庞大(总参数约 235B)但实际激活参数远少于此,从而在速度和质量之间取得平衡。预填充(Prefill)阶段是指模型在生成回复之前,一次性处理输入提示词(prompt)的过程;而 TG(Token Generation)阶段则是逐 token 生成输出的过程。PP 是 Prefill Performance 的缩写,通常以每秒处理的 token 数衡量。由于 MOE 结构中专家路由的稀疏性,内核的计算访存模式与稠密模型差异显著,对底层推理引擎的向量化和内存调度提出了特殊要求,这也是通用优化难以直接套用的根本原因。
两种权重格式:HGN 与 GGUF 的统一支持
这次更新引入了对 两种权重格式的统一支持,这一点被作者反复强调其重要性。问题的根源在于:这类 B 级大模型体积巨大(约 120GB),而 HGN(HuggingFace 原生格式)与 GGUF 两种权重格式互不通用,llama.cpp、Hologen Flash Silver 等各类框架也各行其是。为解决这一碎片化问题,作者决定在自己的引擎中做统一支持。
两种格式各有取舍:
- HGN 格式:其中的 PLE(额外外挂模块)采用 FP8 量化,约 47.7GB,追求性能和更低显存占用时首选。
- GGUF 格式:借助"树懒兄弟"(unsloth)的高质量量化版本,PLE 部分量化到 Q4 仅 26.8GB,但整体文件体积更大,会额外多占用约 10GB 显存。
作者给出的选择建议很直接:追求预填充速度和 TG(生成)速度就用 HGN;追求质量、或电脑上已有 GGUF 文件的就继续用 GGUF。毕竟为了换格式重新下载 100 多 GB 的文件确实很麻烦。需要特别注意的是,GGUF 格式在 Windows 上无法使用。
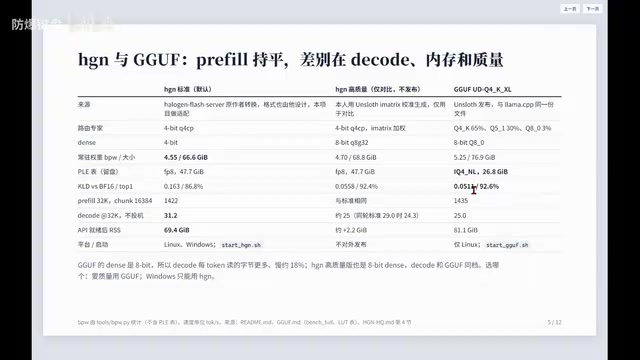
GGUF 是由 llama.cpp 项目定义的一种模型权重文件格式,将模型结构元数据与量化后的权重打包进单一文件,便于跨平台分发,社区中大量量化模型都以此格式流通。HuggingFace 原生格式(文中简称 HGN)则沿用 PyTorch 的 safetensors 分片存储,更贴近训练侧的数据布局,理论上对推理引擎的亲和性更高。量化(Quantization)是将模型权重从高精度浮点数(如 BF16)压缩为低比特整数(如 Q4、FP8)的技术,可大幅降低存储与显存占用,但可能轻微损失生成质量。FP8 是 8 位浮点量化,精度损失极小;Q4 则是 4 位整数量化,压缩率更高但精度略低。Unsloth(文中称"树懒兄弟")是一个专注于高质量低损失量化的开源项目,其 GGUF 量化版本在社区中以精度保持好著称。
分页 KV 与并发:面向生产力的能力
除了性能优化,本次更新还加入了两项面向生产力场景的能力:
分页 KV 缓存(Paged KV):有了分页 KV 之后,缓存利用率更高,无需每次都进行全量预填充,对多轮对话和长上下文场景更友好。
"青春版"并发:支持多请求并发处理,多个请求会平均分摊生成速度。作者举例说明——假设单请求速度是每秒 40 token,那么 4 个并发下每个请求大约就是每秒 10 token,速度被平均分摊,所以调侃为"非常青春"。这种设计适合需要同时服务多个请求的轻量生产环境。
KV 缓存(Key-Value Cache)是 Transformer 推理中的核心优化机制:模型在生成每个新 token 时,需要参考此前所有 token 的注意力键值对,将这些中间结果缓存起来可避免重复计算。分页 KV(Paged KV Cache)借鉴操作系统虚拟内存的分页思想,将 KV 缓存切分为固定大小的内存块按需分配,而非为每条对话预先分配连续的最大长度内存。这样做的好处是:多轮对话中已计算的上下文不必重新填充,显存利用率更高,也能同时容纳更多并发请求而不浪费内存。该技术最早由 vLLM 项目提出并推广,目前已成为生产级推理服务的标配能力。
本机实测:低功耗下的稳定表现
作者使用一台"吉摩克"(GMKtec)的机器进行实测,该机性能相对较低,平均功率仅约 120 瓦,峰值顶天 130 瓦且持续不到 10 秒。在这样的低功耗条件下,模型的生成速度依然保持稳定,长上下文场景下速度衰减非常缓慢且稳定。
在 Windows 平台下,128K 上下文的预填充性能平均约 1000 PP,TG 性能与 Linux 保持一致。Linux 平台下,HGN 与 GGUF 的预填充速度基本持平,HGN 的 TG 性能略高一点点,但在 MTP 投机解码下这种差距并不会带来明显的质变。
显存占用方面,优化后约占用 94.9GB,对于 Windows 平台仅有 96GB 可用显存的情况尤为关键——留出的约 1GB 余量还能拿去"打小游戏"。这也解释了为何 GGUF 在 Windows 上吃不下:它占用的显存更多,96GB 有点勉强。
控制面板与项目致谢
本次更新还附带了一个可视化控制面板,可以查看内存开销、设置思考强度、思考开关等参数,虽然作者自嘲"没什么大用""花里胡哨",但对普通用户调整推理行为仍有一定便利。
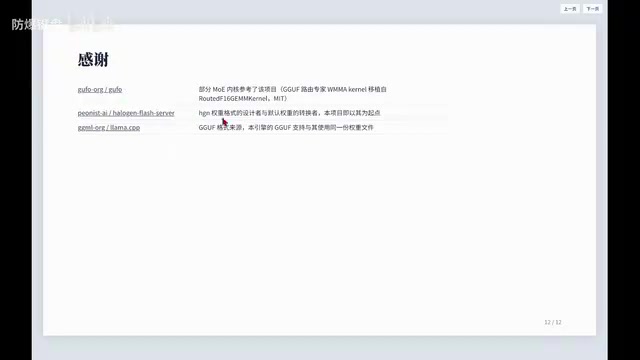
作者也特别致谢了几个启发性的开源项目:Hologen Flash Silver("梦开始的地方",让作者意识到这种性能是可以达到的)、以及让他学到如何优化 MOE 内核的相关项目。这也侧面反映出本地大模型推理优化是一个高度依赖社区协作与经验共享的领域。
小结
对于关注 AMD AI MAX+ 395 这类统一内存平台本地跑超大模型的用户来说,GFX1151 engine 的这次更新提供了实用的思路:通过 MOE 内核优化拿到约 15% 的预填充性能提升、统一 HGN 与 GGUF 两种权重格式、并补齐分页 KV 与并发能力。需要清醒认识的是,这些优化高度依赖 Qwen3 这类特定模型的结构特性,并非通用方案。选择 HGN 还是 GGUF、Linux 还是 Windows,最终取决于你的硬件条件和对速度/质量的权衡。
相关推荐

Devin年收入逼近10亿美元:AI编程热潮背后的真实账本
Cognition旗下Devin AI编程智能体年化收入逼近10亿美元,四个月翻倍,估值达480亿美元。本文解析AI编程热潮背后的真实收入、53倍估值倍数、8亿美元现金消耗与企业客户版图。
n8n实战:从零搭建你的第一个AI Agent工作流
基于n8n in 100 days系列第14集实操,详解如何用n8n搭建第一个AI Agent:从When chat message received触发节点、AI Agent与Chat Model,到Memory记忆模块的作用与设计逻辑。

Aleph Alpha开放Kolibri 78B在线免费试用
Aleph Alpha旗下780亿参数大模型Kolibri 78B现已开放免费在线试用,用户无需部署即可通过网页体验这款欧洲本土AI模型的对话能力。