AI SRE Arena:为Kubernetes智能运维Agent打造的开源评测基准
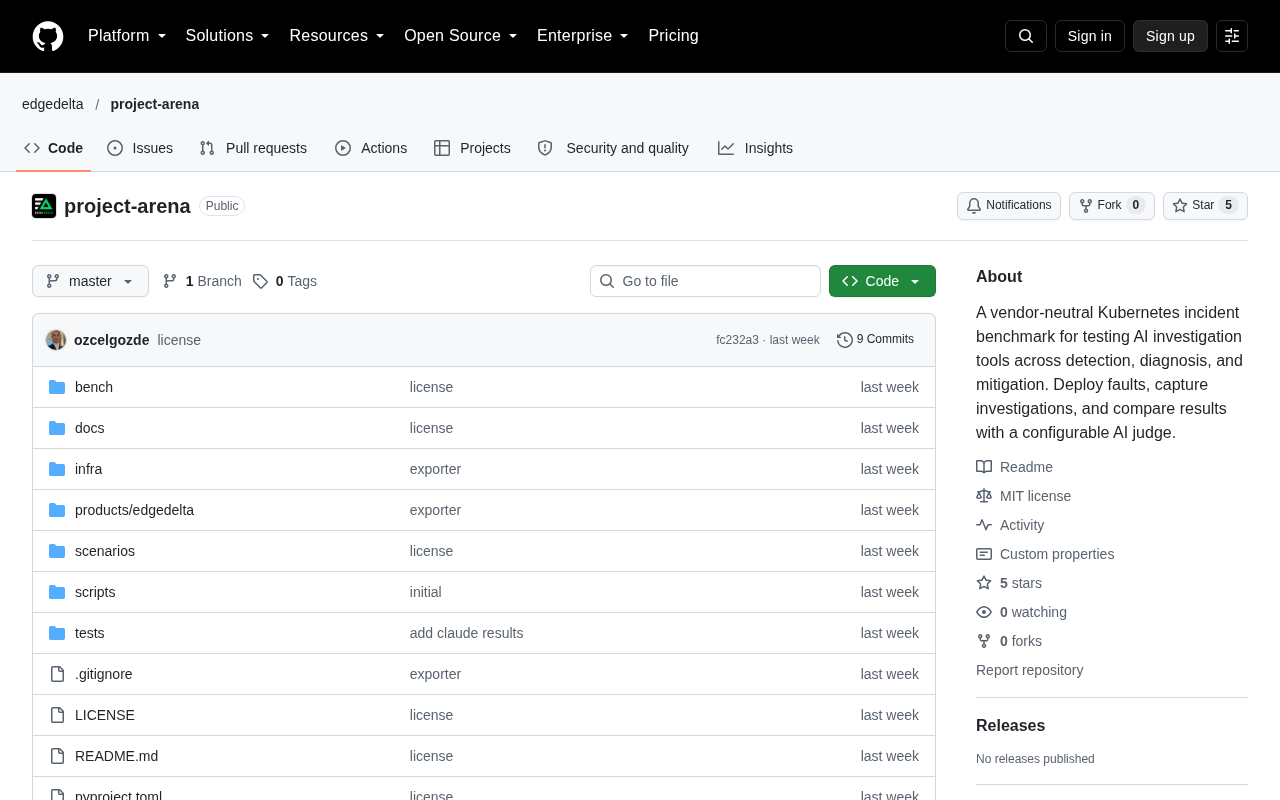
AI SRE Arena:首个面向Kubernetes故障诊断的开源AI Agent评测基准
AI SRE Arena 是一个新兴的开源评测基准,专门用于衡量AI Agent在Kubernetes环境下的故障诊断与修复能力。它的出现填补了AIOps领域缺乏统一评测标准的空白——现有基准多集中于编程或问答等通用任务,无法反映SRE工作所特有的"观测-假设-验证-修复"闭环特征。该基准通过真实故障注入场景,考察Agent在信息过载、级联故障因果推理、操作安全边界等多维度上的表现,而非仅判断最终答案是否正确。项目以Show HN形式登陆Hacker News,虽处于早期阶段,但其方向切中了AI运维从"能否落地"向"如何量化可靠性"演进的核心需求,被视为SRE领域的"SWE-bench"尝试。
当AI开始接管运维:一个新的评测标准出现了
随着大语言模型能力的持续增强,越来越多的工程团队开始尝试将AI Agent引入站点可靠性工程(SRE)领域——让AI在凌晨三点替你排查Kubernetes集群的故障。但一个关键问题随之浮现:这些AI SRE Agent到底靠不靠谱?它们在真实的故障场景下表现如何?
近日,一个名为 AI SRE Arena 的项目登陆 Hacker News 的 Show HN 版块,试图回答这个问题。它定位为一个面向 Kubernetes 环境的开源评测基准(Open Benchmark),专门用来衡量AI SRE Agent的实际故障诊断与修复能力。
为什么需要一个专门的SRE评测基准
当前AI Agent的评测大多集中在编程、问答、推理等通用任务上,针对运维场景的专门基准相对稀缺。而SRE工作有其独特性:它不是一次性的代码生成,而是一个涉及观测、假设、验证、修复的闭环过程。
Kubernetes 作为云原生时代的事实标准,其故障形态极其复杂——从 Pod 崩溃循环(CrashLoopBackOff)、资源配额耗尽,到服务间网络策略冲突、配置错误,每一类问题都考验Agent对分布式系统的理解深度。
一个合格的评测基准需要能够复现这些真实的故障注入场景,并以可量化的方式判断Agent是否真正定位了根因、是否采取了正确的修复动作。这正是 AI SRE Arena 想要填补的空白。
开源与可复现的意义
将评测基准开源,意味着任何团队都可以在相同的标准下测试自己的Agent方案,横向对比不同模型、不同Prompt策略、不同工具链组合的效果。这对于一个仍处于早期、缺乏统一衡量尺度的领域来说,价值尤为突出。可复现的测试环境也让社区能够共同演进测试用例,避免各家闭门造车、自说自话的局面。
Kubernetes场景下AI Agent面临的挑战
AI SRE Agent在真实K8s环境中要跑通一套完整的诊断流程,难度远超想象。它需要调用 kubectl、读取日志、解析监控指标,在海量信息中锁定异常信号,再推断出故障链路。
这个过程中存在几个典型难点:
- 信息过载:集群产生的日志、事件、指标数据量庞大,Agent需要有效过滤噪音。
- 因果推理:很多故障是级联效应,表层现象与根本原因可能相隔甚远。
- 操作安全:Agent的修复动作若判断失误,可能造成更大范围的服务中断,评测必须考量操作的安全边界。
- 时效性:真实SRE场景对响应速度有要求,诊断效率也是重要维度。
一个好的Arena式评测,理应把这些维度都纳入打分体系,而不仅仅看Agent最终是否"猜中"了答案。
CrashLoopBackOff 是 Kubernetes 中最常见的 Pod 异常状态之一,指容器反复启动后立即崩溃,kubelet 随即按指数退避策略重启,由此形成循环。触发原因涵盖应用启动报错、配置文件缺失、依赖服务不可达、OOM(内存溢出)等多种情形,单凭状态标识本身无法判断根因,必须结合容器日志、事件流(Events)和资源使用曲线才能定位。这一特点使其成为评测 AI Agent 综合诊断能力的典型用例——Agent 既要知道"看哪里",又要能够从非结构化日志中提取关键错误信息,最终给出可执行的修复建议,而非泛泛的方向性回答。Arena 类评测若能包含此类多步推理场景,其区分度将远高于单轮问答式测试。
社区反响与早期观察
该项目在 Hacker News 上获得了初步关注,目前积累了13个赞和少量讨论。作为一个Show HN项目,它尚处于早期阶段,社区讨论规模有限,但其切入的方向切中了当下AIOps落地的真实痛点。
对于正在评估AI运维工具的工程团队而言,这类开源基准提供了一个相对客观的参考坐标。与其听信厂商的营销话术,不如用统一的测试集跑一遍,让数据说话。
小结:AIOps走向可量化评估
AI SRE Arena 的出现,反映出AI运维正从"能不能用"向"好不好用、靠不靠谱"的阶段演进。评测基准是任何技术走向成熟的必经之路——就像编程领域有了 SWE-bench,SRE领域也需要属于自己的标尺。
当然,单一项目的早期尝试还需要时间验证其测试用例的覆盖度、评分机制的合理性以及社区的持续投入。但这一方向本身,为AI Agent在生产级基础设施中的落地提供了值得关注的评估框架。感兴趣的团队不妨关注其开源进展,甚至参与贡献自己遇到的真实故障场景。
SWE-bench 是斯坦福等机构于2023年发布的软件工程基准,通过让 AI Agent 在真实 GitHub Issue 和对应代码库上完成 Bug 修复,以测试用例通过率作为客观评分标准。它的出现将"AI 能否写代码"这一模糊问题转化为可量化、可复现的工程指标,推动了代码智能体领域的快速迭代,并成为各大模型厂商对比能力的公认尺度。AI SRE Arena 对 SWE-bench 的借鉴逻辑在于:同样将开放性任务(故障诊断)转化为有真实环境、有客观验收标准的闭合测试,从而避免依赖主观打分或模型自评。两者的主要差异在于 SRE 评测需要与活跃的运行时环境交互,状态管理和副作用控制的复杂度更高。
背景补充
SRE(Site Reliability Engineering,站点可靠性工程)起源于Google,是一套将软件工程方法论应用于运维的实践体系。其核心理念是用代码和自动化手段管理系统可靠性,并通过SLO(服务等级目标)、错误预算等量化指标约束工程决策。与传统运维不同,SRE强调故障复盘(Post-mortem)文化和可观测性(Observability)建设,即通过日志、指标(Metrics)、链路追踪(Tracing)三大支柱来理解系统内部状态。正是这种高度依赖多源数据综合判断的工作性质,使得SRE场景成为测试AI Agent推理与工具调用能力的理想压力测试场。通用基准如MMLU、HumanEval无法捕捉这类"在真实环境中采取正确行动"的能力,因此垂直领域专用评测基准的价值不可替代。
相关推荐

@ai-sdk/workflow-harness 1.0.146 发布说明
@ai-sdk/workflow-harness 1.0.146 为补丁级别更新,依赖 @ai-sdk/harness 同步升级至 1.0.146,由 GitHub Actions 自动发布并经验证签名。

ICANN新顶级域名争夺战:Meta与OpenAI抢注.agent和.agi
ICANN放出1600份新顶级域名申请,Meta与OpenAI争夺.agent和.agi后缀;同时GTA VI发售倒计时泄露不断,Joe Rogan与Spotify达成约2.5亿美元续约。一文看懂科技圈头部资产争夺战。

MCP协议详解:20行代码搭建你的AI工具服务器
MCP(模型上下文协议)是连接 AI 应用与外部工具的通用标准,被称为「AI 界的 USB-C」。本文详解 MCP 的架构原理、无状态协议升级,并手把手教你用不到 20 行代码搭建自己的 MCP 服务器,附安全实践建议。