#Kubernetes
共 22 篇相关文章

为 NVIDIA Dynamo 构建经过验证的 Kubernetes 运行时
介绍如何为 NVIDIA Dynamo 分布式推理框架构建经过验证的 Kubernetes 运行时,涵盖驱动与容器运行时、调度配置、Dynamo 应用配置以及自动化验证等关键层次,帮助团队建立可重复的推理部署基线。
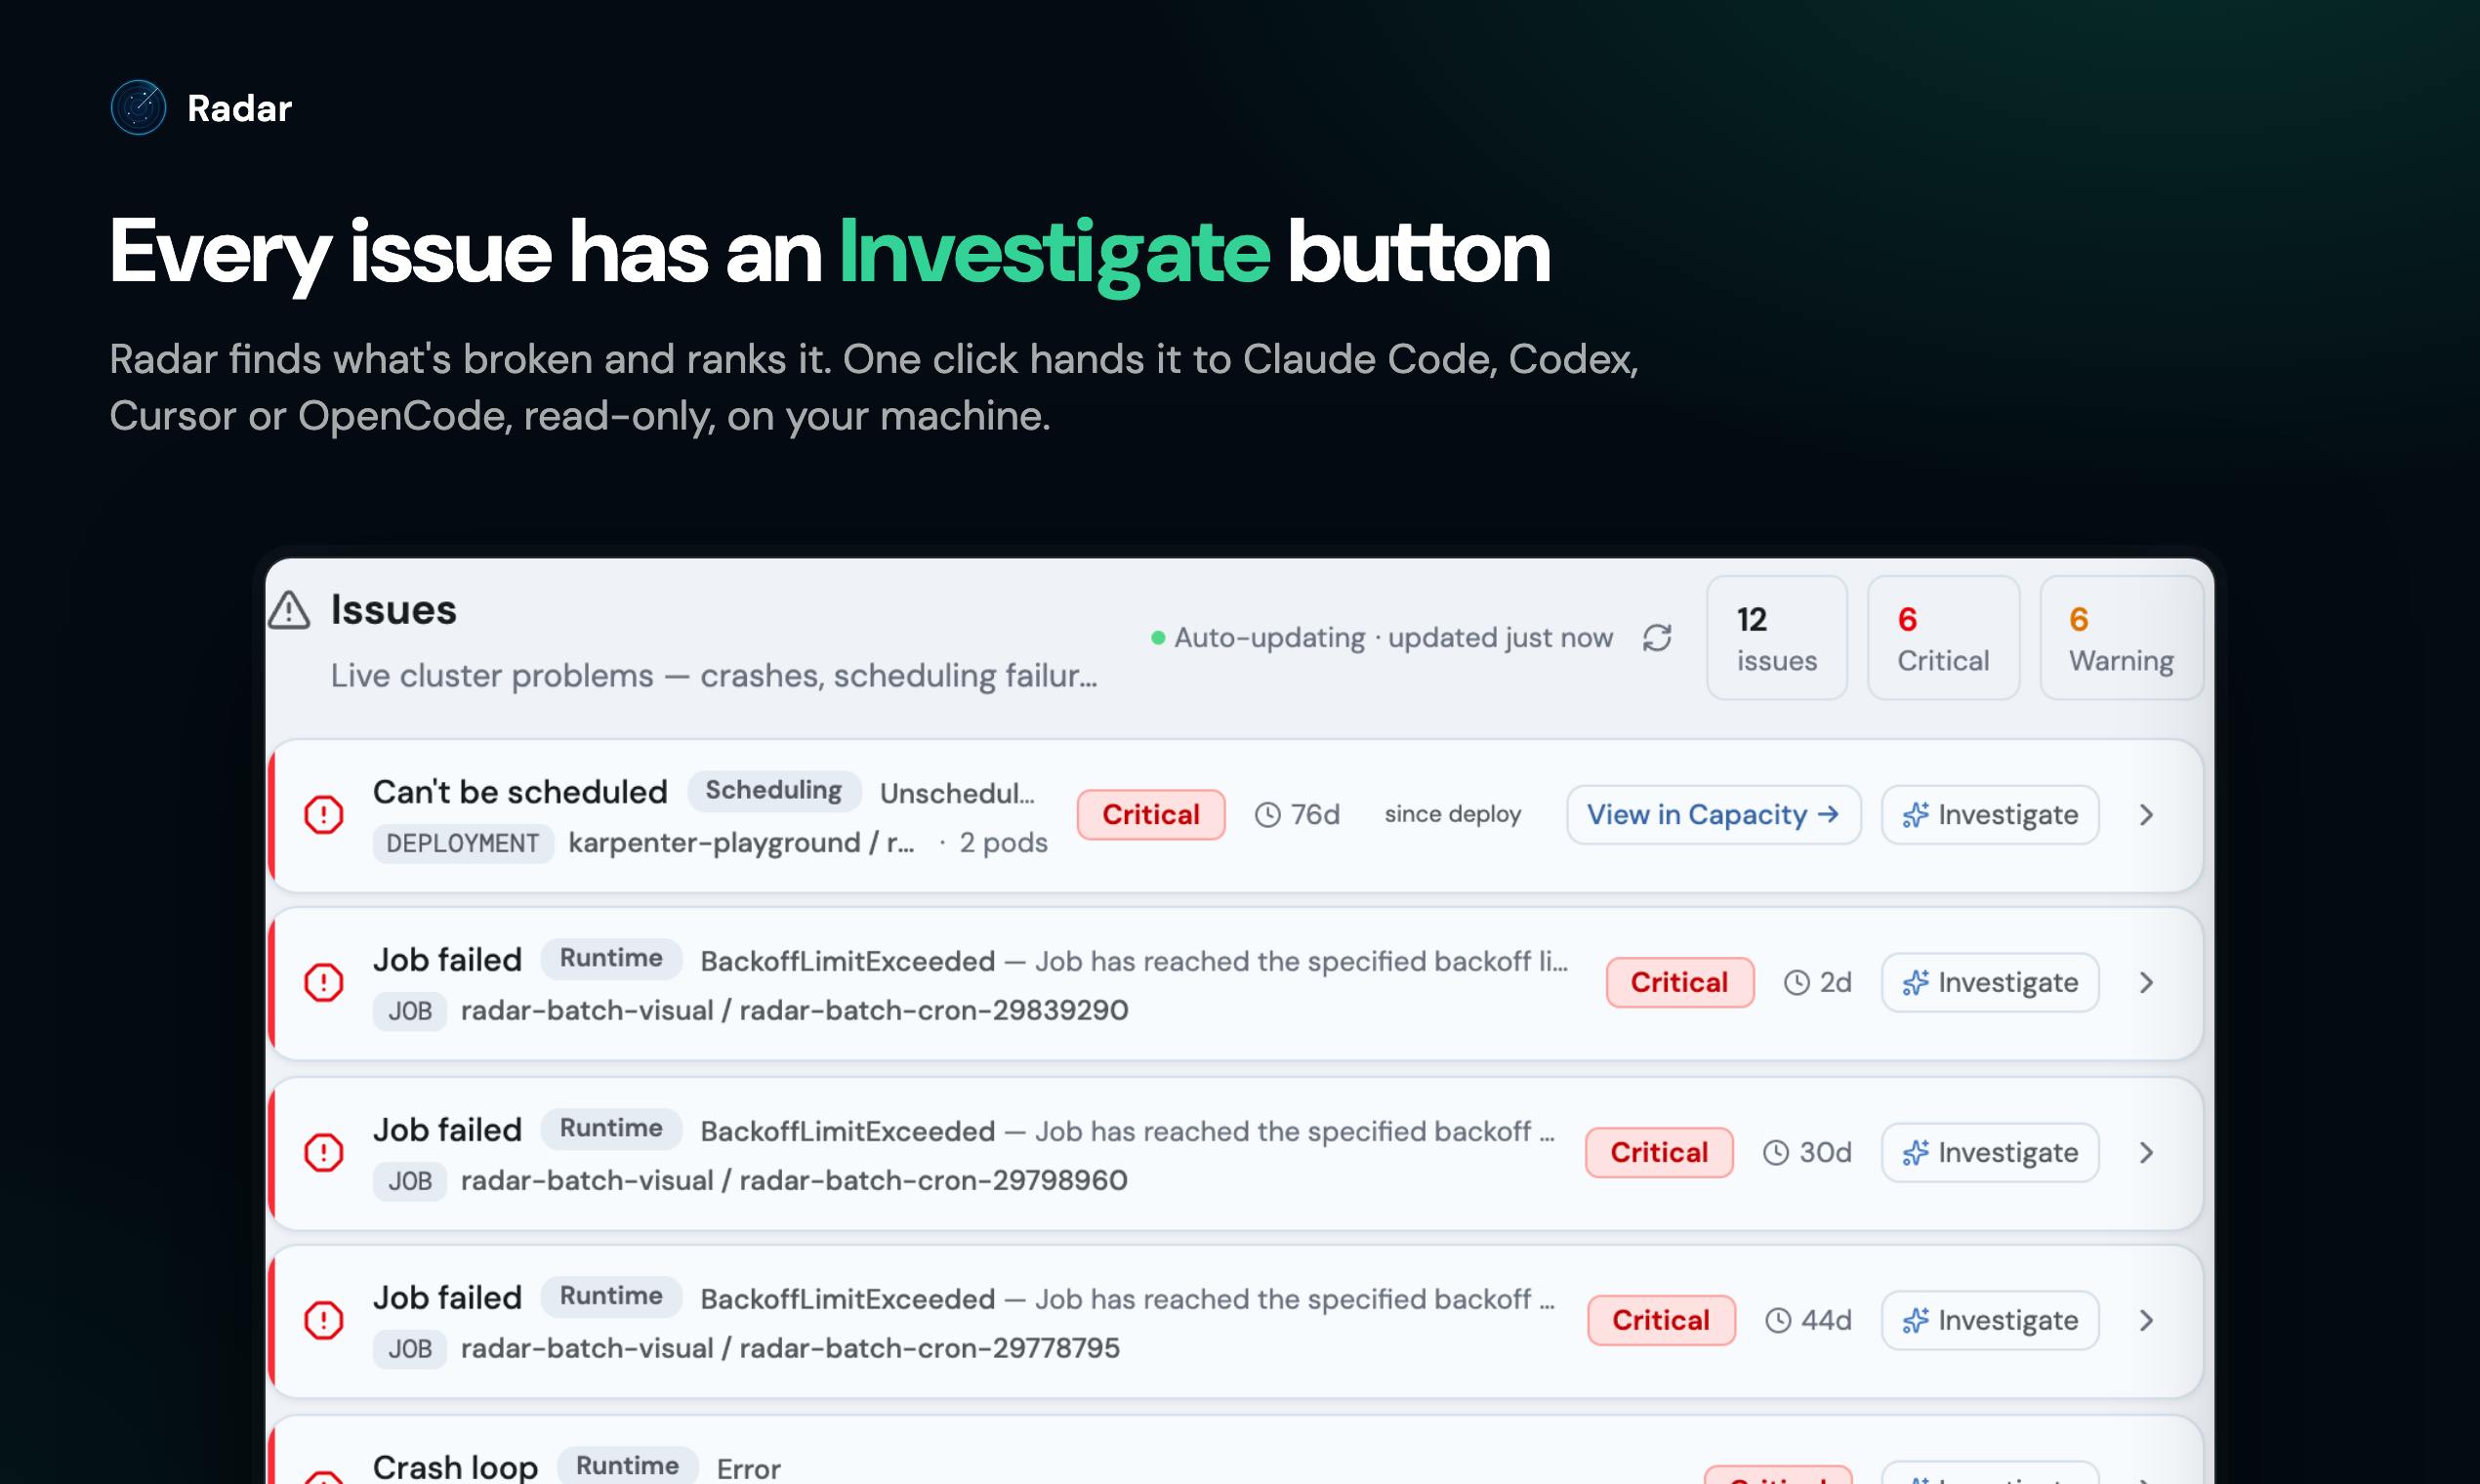
Radar: 给AI Agent装上Kubernetes集群雷达
Radar 是一款开源工具,通过 MCP 为 Claude Code、Codex、Cursor 等 AI Agent 提供 Kubernetes 集群上下文,包括排序后的问题、变更时间线、日志与归属信息,支持只读根因排查。

CUDA 13.4 内存强制隔离:Kubernetes GPU 共享新解
NVIDIA CUDA 13.4 引入内存强制隔离机制,让 Kubernetes 上的 GPU 共享从调度约定走向运行时硬约束。本文解析其与 K8s 资源模型的配合方式、适用场景及落地时的配额粒度与算力争抢问题。

英伟达 Mission Control 2.5:Kubernetes 自治恢复新进展
英伟达 Mission Control 2.5 面向大规模 GPU 训练集群,在 Kubernetes 上引入自治恢复能力,把故障发现、诊断与处置交给平台自动完成,降低人工运维负担。

llm-d 1.0 发布:缓存感知路由统一 TPU 与 GPU 推理
Google、Red Hat 与 IBM 联合发布 llm-d 1.0,Kubernetes 原生分布式 LLM 推理栈新增缓存感知路由、多租户流控、零停机升级与 Agent 感知路由,统一支持 vLLM、SGLang 及 TPU/GPU 异构集群。

英伟达开源Run:ai:Kubernetes GPU调度进入Apache 2.0时代
英伟达以Apache 2.0协议开源完整Run:ai GPU编排平台,包含KAI Scheduler、CUDA 13.4 GPU fractioning、配额管理与本地Kind开发环境。本文解析这次开源对Kubernetes GPU调度、资源利用率和企业采用的实际影响。

NVIDIA Dynamo on Kubernetes:5分钟搞懂AI推理部署
NVIDIA Dynamo如何在Kubernetes上部署AI推理?本文拆解Dynamo Operator模式、DGDR与DGD两条部署路径、OpenAI兼容请求链路及五步实战流程,帮助团队从单模型服务器平滑迁移到Kubernetes原生推理。

AI Agent编排竞赛:Kubernetes构建爆炸半径感知代码审查
多Agent编排正成为AI代码审查的主流架构,但失控循环、依赖劫持等爆炸半径风险随之而来。本文拆解基于Kubernetes的爆炸半径感知架构:三层编排模型、ResourceQuota与SecurityContext沙箱、自定义Operator实战,以及多Agent协作与人类在环护栏。
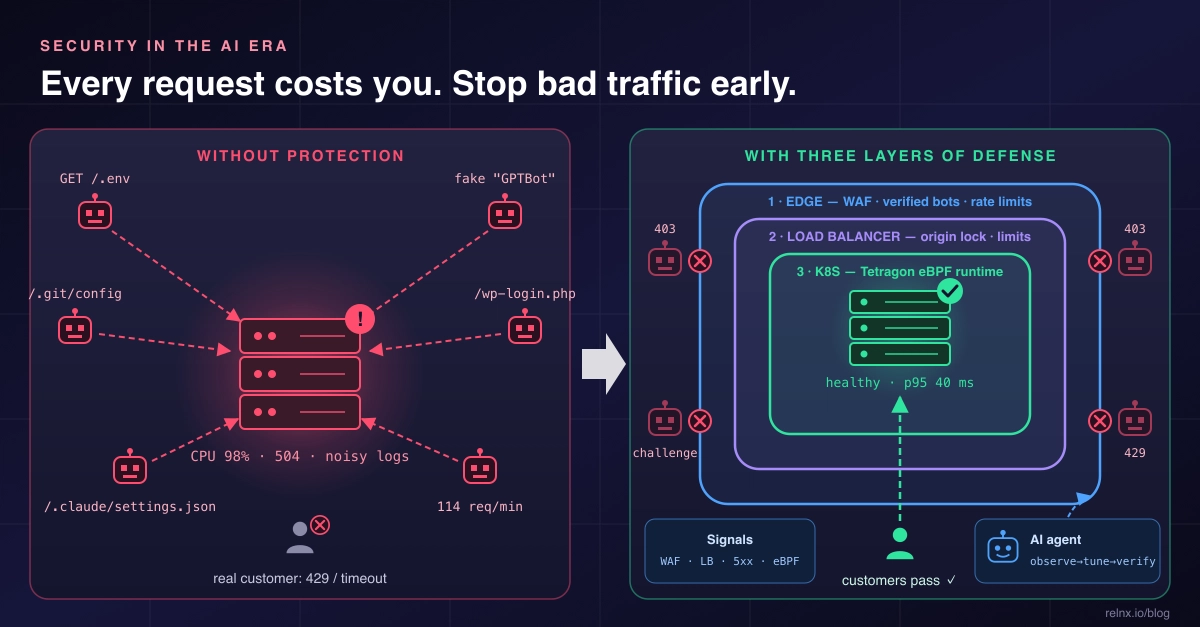
AI时代应用安全:每请求皆有成本,三层防御实战
AI时代应用安全面临新挑战:约八分之一边缘请求为恶意扫描或机器人。本文基于真实流量数据,详解边缘WAF、负载均衡器、Kubernetes Tetragon三层防御及AI代理调优方案。

Ray LLM容器:EKS跨GPU节点部署大模型实战
介绍如何在 Amazon EKS 上使用 Ray LLM Deep Learning Containers 跨两个 GPU 节点部署大语言模型,通过 prefill 与 decode 节点分离架构,对外提供单一 OpenAI 兼容端点,降低多节点推理部署复杂度。
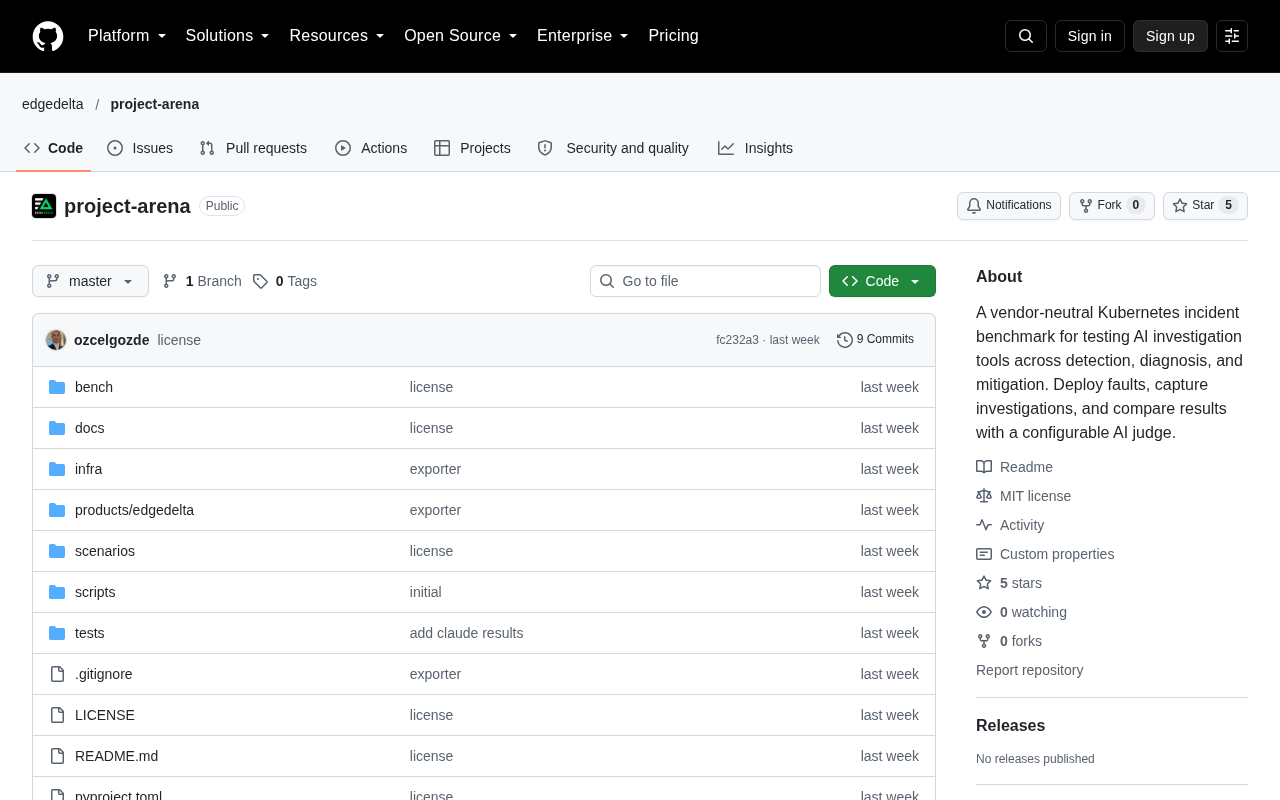
AI SRE Arena:为Kubernetes智能运维Agent打造的开源评测基准
AI SRE Arena 是一个面向Kubernetes的开源AI运维Agent评测基准,专门衡量AI在故障诊断与修复中的真实表现。本文解析其设计初衷、K8s场景挑战与AIOps可量化评估的意义。

从Ollama到vLLM:在Kubernetes上部署生产级AI Agent
如何把本地AI Agent部署到生产环境?本文拆解从Ollama切换到vLLM、并容器化部署到OpenShift/Kubernetes的完整流程,包括模型服务、配置改动、工具调用验证,以及生产就绪前必须解决的安全与治理问题。

AICR v1.0发布:开放可验证的GPU集群配置方案
NVIDIA推出AICR v1.0,为GPU加速的Kubernetes集群提供开放、稳定、可验证的配置方案,解决内核、驱动、CUDA等数十个组件的版本兼容难题,提升AI基础设施的可靠性与可审计性。
MCP从0到1:搭建生产级MCP服务器实战全攻略
从本地测试脚本到生产级MCP服务器的完整实战攻略:涵盖MCP核心概念、传输协议对比、无状态架构四大支柱、Docker容器化、Nginx负载均衡与Kubernetes弹性集群部署,助你打造坚不可摧的AI工具服务。

当AI Agent真正掌控你的Homelab:K3s实验的经验与风险
开发者将本地Qwen Agent通过MCP接入K3s homelab并开放写操作权限,这篇实验记录揭示了AI Agent获得真实系统访问权限后的能力边界、潜在风险与实践启示。

3D打印机架+3节点Proxmox:一套二手Homelab的深度拆解
一位 Reddit 用户分享其两年打造的二手 Homelab:3D 打印机架、三节点 Proxmox 集群、UniFi 网络分段,以及基于 Talos、Terraform 和 ArgoCD 的全 GitOps Kubernetes 软件栈,是家庭实验室进阶的完整参考。

Google 开源 AX:为 AI Agent 打造的 Kubernetes
Google 开源 AI Agent 运行时 AX(Agent Executor),号称面向十亿级并发会话,可从内核快照亚秒级恢复崩溃的 Agent。本文解析其四大声明式原语、Agent Substrate 架构,以及它为何被称为 Agent 版 Kubernetes。

NodeWright:破解 Kubernetes 节点集群运维难题
NVIDIA 推出 NodeWright,将 Kubernetes 节点集群的内核配置、软件包、存储与安全管理纳入声明式框架,破解大规模 GPU 集群的节点运维难题。
 行业洞察
NVIDIA Dynamo Snapshot:GPU推理冷启动问题的快照恢复方案
深入解析NVIDIA Dynamo Snapshot如何通过GPU状态快照与恢复机制,将大模型推理服务的冷启动时间从分钟级降至秒级,涵盖Kubernetes集成、技术实现挑战及弹性推理等实际应用场景。
 教程攻略
ACPX实战:用Kubernetes规模化部署AI Agent自动处理PR
详解如何利用ACP协议、ACPX工作流引擎和Kubernetes构建自动化PR处理系统。从OpenCLO项目6万+PR的真实场景出发,介绍多Agent并行编排、按需可销毁Agent架构及企业级部署方案。