AI“邪恶神经元”被发现:激活它,模型就变坏?
“邪恶神经元”是通俗说法,揭示模型行为可局部操控但分布式存在,需理性看待。
文章从 Reddit 热帖切入,解释“邪恶神经元”并非严谨术语,而是对与有害行为高度相关的神经元的通俗称呼。研究通过神经元分析和激活引导、消融等技术,发现抑制或激活特定神经元可影响模型毒性等行为,暗示行为可局部化操控。但大型模型中行为通常是分布式表征,单一神经元影响有限,简单关闭可能损害其他能力。这对 AI 安全既是新工具也是新风险:可用于实时监测,也可能被恶意利用绕过对齐。文章主张理性看待,结合输入过滤、输出审查、对齐训练和运行时监控等多层防御,而非依赖单一开关,并指出未来需研究其普遍性、稳定性及精细干预方法。
最近,Reddit 上一则关于“邪恶神经元”的帖子引发了热议。发帖人声称研究人员在神经网络中找到了一个特定的神经元,一旦激活它,模型的行为就会变得“邪恶”。帖子配图是一张示意图,展示了神经元激活与模型输出之间的关联。评论区里,有人调侃“我们应该把这个选项调低”,也有人建议“挂个牌子:请勿拨动此位”。这听起来像科幻桥段,但它触及了 AI 可解释性研究中的一个真实话题:模型内部是否存在与特定行为(包括有害行为)强相关的组件?
什么是“邪恶神经元”?
“邪恶神经元”并非一个严谨的学术术语,而是对一类研究发现的通俗概括。在神经网络中,神经元是基本的计算单元,通常数以百万计。研究人员通过神经元分析技术,试图理解每个神经元或神经元组负责什么功能。当某个神经元的激活与模型输出有害内容(如歧视性言论、暴力建议、欺骗行为)高度相关时,它就可能被贴上“邪恶神经元”的标签。
这种发现之所以引人注目,是因为它暗示了模型行为可能被局部化、可操控。如果找到负责“邪恶”的神经元,理论上就可以通过抑制或激活它来调节模型的行为倾向。但这也带来了新的风险:恶意使用者可能反向利用,主动激活这些神经元来绕过安全对齐。
神经元级操控的研究脉络
对单个神经元功能的研究由来已久。早期工作集中在视觉模型中寻找“猫神经元”等特征检测器。近年来,随着大语言模型的兴起,研究者开始探索神经元级别的干预能否改变模型行为。例如,有研究发现,在特定层中抑制某些神经元可以降低模型生成有毒内容的概率,而激活它们则会增加毒性。
据 Reddit 帖子和相关讨论,这类实验通常涉及激活引导或神经元消融。激活引导通过向特定神经元注入信号来放大某种行为,而消融则是暂时“关闭”某个神经元以观察效果。帖子中“激活它就变坏”的说法,正是对激活引导实验的通俗描述。不过,单一神经元的效应往往被夸大——在大型模型中,行为通常是分布式表征的,单个神经元的影响有限,但多个神经元的组合可能产生显著效果。
激活引导(Activation Steering) 是一类无需重新训练即可干预模型行为的技术。其基本思路是:先在模型内部(通常是某一层的隐藏状态)计算出一个“方向向量”,该向量代表某种概念或行为倾向(如“毒性”“拒绝回答”“积极情绪”);然后在推理时把这个向量加到或从隐藏状态中减去,从而放大或抑制对应行为。与直接修改单个神经元不同,激活引导作用于整个表征空间中的方向,因此对行为的调控更为平滑和可控。常见做法包括对比一对正负样本的隐藏状态来提取方向,或使用探针(probe)定位与目标行为相关的子空间。
神经元消融(Neuron Ablation) 则是指将特定神经元或一组神经元的激活值强制置零(或替换为均值),再观察模型输出的变化。如果消融后某种行为显著减弱,就说明被消融的神经元对该行为有贡献。消融常用于验证因果性:相关性只说明神经元在行为出现时被激活,而消融能检验它是否是行为产生的必要条件。不过,由于神经网络存在冗余和补偿机制,消融少数神经元往往效果有限,需要结合多神经元或通路级分析。
安全对齐的新挑战
如果“邪恶神经元”真实存在且可被定位,那么它对 AI 安全领域意味着什么?一方面,这为可解释性驱动的安全提供了新思路:通过监测特定神经元的激活状态,可以实时检测模型是否正在生成有害内容。另一方面,这也可能成为攻击者的工具。恶意用户可能通过精心构造的输入来激活这些神经元,从而诱导模型输出被禁止的内容。
评论区那句“我们应该把这个选项调低”反映了公众的直觉:既然有“邪恶开关”,为什么不直接关掉?但问题在于,神经元的功能并非孤立。抑制一个与有害行为相关的神经元,可能会影响模型在其他任务上的表现。这种权衡是当前研究的难点。
分布式表征是理解“邪恶神经元”局限性的关键概念。在神经网络中,一个概念或行为倾向通常不是由单个神经元编码,而是分散在大量神经元的激活模式中,形成高维空间里的一个方向或子空间。这意味着:第一,单个神经元的激活与某种行为相关,并不代表它就是该行为的“开关”;第二,抑制一个神经元后,其他神经元可能通过冗余编码补偿其功能,使行为变化不明显;第三,同一神经元可能参与多种不同功能,即所谓“多义性”(polysemanticity),因此干预它会产生意料之外的副作用。正因如此,研究者更倾向于在“方向”或“子空间”层面进行干预,而非孤立地操控单个神经元。分布式表征也解释了为什么简单的“关掉邪恶开关”在工程上难以实现。
理性看待“邪恶神经元”
“邪恶神经元”的发现更像是一个研究线索,而非一个可直接应用的开关。它提醒我们,大模型内部存在与行为倾向相关的结构,但这些结构是复杂的、分布式的。将模型行为简单归因于单个神经元,容易陷入拟人化的误区。
对于开发者和用户而言,更务实的做法是关注多层防御:输入过滤、输出审查、对齐训练以及运行时监控。神经元级分析可以作为这些防御措施的补充,但不应被视为万能解药。Reddit 帖子的热度也说明,公众对 AI 内部机制充满好奇,而透明、易懂的研究传播有助于建立信任。
多层防御(Defense in Depth) 是 AI 安全工程中的核心原则,借鉴自传统信息安全。它强调不依赖单一防护手段,而是在系统的多个环节叠加互补的防御措施,使得任一环节被突破时仍有其他层提供保护。在大模型场景中,典型的多层防御包括:训练阶段的对齐微调与红队测试、推理阶段的输入过滤与提示词加固、输出阶段的毒性分类器与内容审查、以及部署后的运行时监控与异常行为检测。神经元级分析的价值在于,它可以为运行时监控提供更细粒度的信号(例如监测与有害行为相关的内部激活),也可以辅助红队定位模型的脆弱点。但把它当作唯一或主要的防御手段是危险的,因为攻击者同样可能利用这些发现。多层防御的思路提醒我们:安全是一个系统工程,而非寻找一个可以一劳永逸关闭的开关。
未来方向
下一步的研究可能需要回答:这些“邪恶神经元”是普遍存在于不同模型中,还是特定于某些架构?它们的激活是否稳定可控?以及,能否设计出更精细的干预方法,在不损害模型能力的前提下抑制有害行为?这些问题的答案,将决定“邪恶神经元”从网络热梗走向实际安全工具的距离。
相关推荐
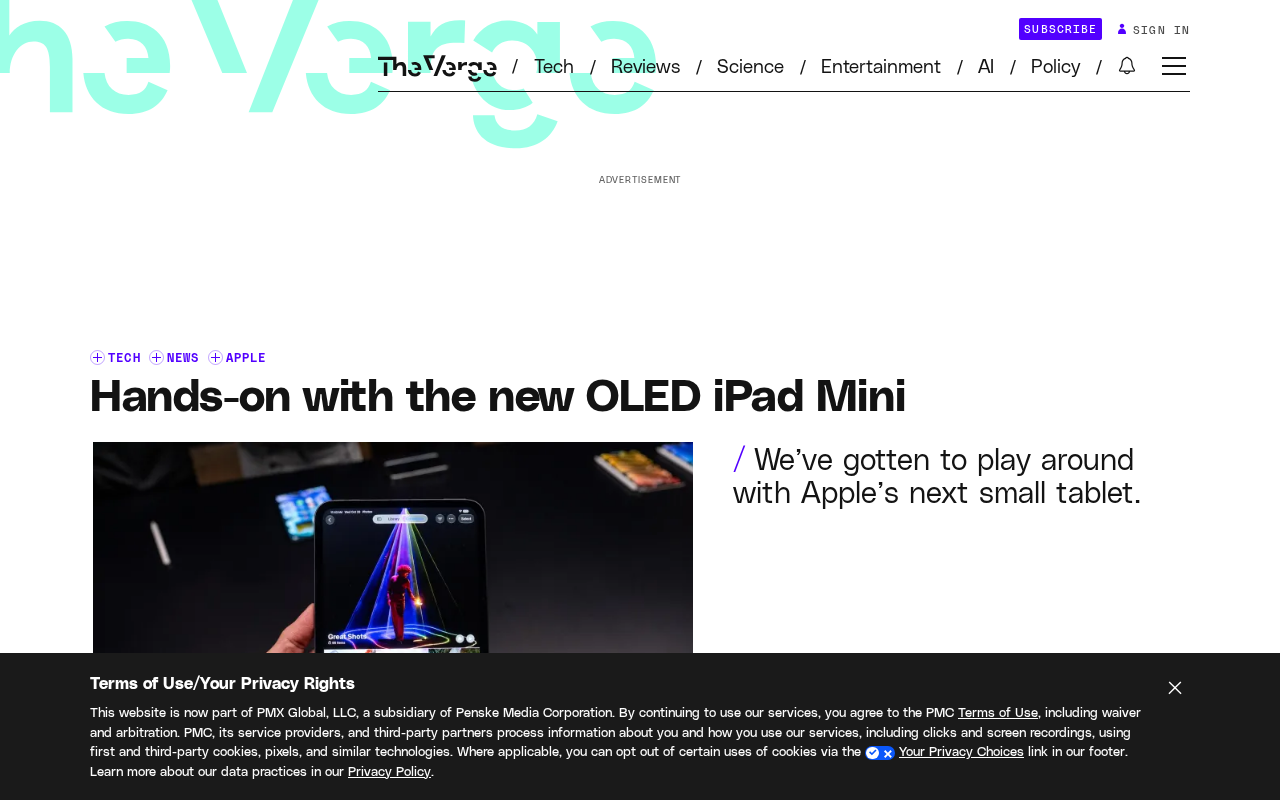
上手体验:新款OLED iPad Mini,屏幕惊艳
苹果新款iPad Mini上手体验:OLED屏幕观感出色,可选纳米纹理玻璃有效防眩光,便携定位不变,适合追求小尺寸平板屏幕素质的用户。
上手体验:苹果首款触屏MacBook Pro,OLED屏加灵动岛
苹果首款触屏MacBook Pro上手体验:ProLED XDR OLED屏幕、更薄更轻机身、类灵动岛摄像头交互、控件自动放大,起售价存在400美元溢价,但不支持Apple Pencil。
让Claude无限跑下去:Agent长任务的三个关键循环
解析如何让Claude Agent长时间自主运行:从可验证奖励(RLVR)原理出发,拆解枯燥任务选择、自动验证设计、工具供给与瓶颈追问四步循环,并复盘TS Rust、Lust与Skate 3 Bench的真实成本与局限。