让Claude无限跑下去:Agent长任务的三个关键循环
给Claude可验证目标与算力,让它自治数千小时重写编译器。
文章介绍了Theo利用Claude进行长时间自治编程的极端工作流:通过选择足够枯燥的任务、设计可程序化验证的成功判据、供给工具与算力,并反复追问agent当前瓶颈,形成自我循环的hill climbing闭环。TS Rust项目通过逐字比对编译输出获得验证,产生约1800次修订和7884次提交;Skate 3 Bench则用LLM评审团对比截图打分。作者强调该方法与RLVR训练环境同构,但成本高昂、多数项目无实用产出,订阅制补贴掩盖了真实开销。真正稀缺的是设计验证机制和发现瓶颈的能力。
当Agent开始替你重写编译器
大多数人用Claude是问一句答一句,顶多写个函数、改个bug。但有一类用法正在把这个边界推得很远:给模型一个足够难、足够枯燥的目标,再给它一套能自动判断成败的验证机制,然后让它跑上几天几周。
YouTube创作者Theo最近分享了一套极端工作流,用他的话说,这不是实用指南,反而是在展示"我不该做的事"。他基于Claude构建了几个项目:用Rust重写TypeScript(TS Rust)、做一个能百倍加速Rust编译的替代编译器(Lust),以及一个完全由Claude从零生成的滑板游戏Skate 3 Bench。这些项目累计让Claude运行了接近4000小时。
支撑这一切的并不是某个神奇提示词,而是一套可以复用的方法论。
核心原理:Hill Climbing与可验证奖励
要理解为什么模型能长时间自我推进,得先回到它的训练方式。
模型的能力大致分两块:知识来自预训练数据,行为来自强化学习。现代模型在训练中大量使用一种叫RLVR的机制——reinforcement learning with verifiable rewards,即带可验证奖励的强化学习。训练时给模型一个能程序化判定成败的环境,比如"把A文件转成B文件并输出指定错误",成功就奖励,失败就调整。模型因此被塑造成会主动测试、写代码验证、失败后换方案的行为模式。
这解释了一个关键现象:当你的任务长得像模型的训练环境时,它表现会好得多。TypeScript移植之所以能做,正是因为编译器的输入输出天然可验证——拿真实项目、固定版本编译、逐字比对结果和错误信息,agent就知道自己有没有做对。
Theo的原话是:先让TS Rust达到和官方编译器完全一致的输出,再说"不要停,直到比官方快两倍"。第一个版本其实比官方慢,但因为有明确的成功判据,它自己一路优化到了目标。TS Rust最终产生了约1800次修订、7884次提交。
RLVR(Reinforcement Learning with Verifiable Rewards) 是近年大模型训练中的关键范式。传统RLHF依赖人类偏好打分,成本高且噪声大;RLVR则把奖励信号交给可程序化判定的环境——例如单元测试是否通过、编译输出是否逐字匹配、数学答案是否正确。模型在大量此类环境中采样、试错,成功轨迹被强化,失败轨迹被抑制。其结果是模型习得一套“假设—验证—修正”的行为策略,而非单纯记忆知识。当部署任务与训练环境同构时(如代码移植、编译器优化),模型能自发地测试、回滚、换方案,从而支撑长时间自治。
四步循环:从目标到算力供给
Theo把整个过程拆成一个会自我循环的闭环。
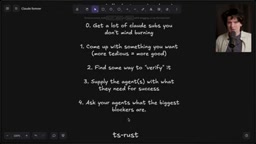
第一步:找一件足够枯燥的事
开发者的本能是逃避重复劳动,但这里要反过来。越枯燥、越不可能有人手动完成的任务,越适合交给agent。把十万文件规模的代码库从一种语言重写到另一种语言,对人来说是折磨,对agent来说只是时间长一点。
第二步:设计验证方式
这是整个方法的命门。验证必须能由代码判定pass/fail,或者至少能让另一个agent看着结果做判断。如果需要人盯着屏幕说"这个好那个不好",进度会慢到没有意义。
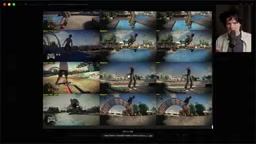
Skate 3 Bench的做法更取巧:让模型在满意一个版本后自动截图,再把截图和原版Skate的相似画面一起丢给另一个LLM评审团打分,根据反馈继续迭代。Theo坦言这个方案并不优雅,他自己都惊讶居然奏效了。代价是模型曾花了相当多token死磕天空盒,只为了让画面更像原作。
LLM-as-a-judge(LLM评审团) 指用另一个大模型对生成结果进行打分或排序,替代难以量化的主观评估。在Skate 3 Bench中,agent截图后与原始游戏画面一同送入评审模型,由后者判断相似度并给出反馈。这种方法灵活但存在已知偏差:评审模型可能偏好特定风格、对细节不敏感,甚至被“刷分”。因此实践中常采用多模型投票、成对比较、引入参考锚点等策略降低噪声。它适合作为缺乏硬性判据时的折中方案,但不应替代可程序化验证的pass/fail标准。
第三步:给足工具
模型知道要做什么、知道什么叫成功,还需要能实际动手的环境。做游戏就需要能跑Blender、能启动浏览器、能截图的机器。Theo为此在本地网络堆了多台机器,后来又转向云端方案,因为串行排队会成为最大瓶颈。
第四步:反复问agent"什么在卡你"
Theo维护了两条线程:一条无限推进TypeScript重写,另一条专门用来定期询问当前瓶颈。通过这种"经理式"对话,他发现Claude曾自己搭了一个队列来避免并发过多导致内存耗尽,也发现算力不足是主要拖累。补上机器、接上云端后,等待时间从每轮十几小时降到小时级。
这个循环的关键在于它不会终止——解决一个瓶颈后,往往会暴露出下一层瓶颈,而下一层本身又可能成为一个新的可hill climb项目。Lust就是这么诞生的:因为Rust编译太慢拖累了TS Rust,于是干脆让模型去重写编译器。
多源视角与需要警惕的地方
Theo特别强调了几点现实约束。成本方面,这些项目的API等价开销极其夸张——TS Rust按API价格折算约3.8万美元,Skate 3 Bench的推理成本接近5000美元、消耗超过120亿token。但订阅制大幅补贴了这部分,实际支出远低于标价。他明确反对用API价格去做这类实验。
他也承认这类项目只有在极少数情况下才产出实用价值。TS Rust因为能显著缩短真实项目的构建时间,被他认为是划算的;其余项目他自己形容为"胡闹"。
你可能没注意到,这条路线并非孤例。Theo提到社区里还有Skate 3 Rust Engine项目,尝试从反编译代码逐行重写Skate 3的物理系统。区别在于:复刻已有项目的成功判据清晰、易于hill climb;而从零创造不存在的东西,验证设计才是真正的难点。
订阅制与API计价的错位 是理解这类实验成本的关键。Claude等产品的订阅套餐通常按固定月费提供远高于API单价折算的用量,实质是厂商对重度用户的补贴。Theo提到的3.8万美元是按API token单价折算的“影子成本”,实际支出可能仅数千美元。这种补贴不可持续,也不应作为生产级项目的成本依据;一旦转向API按量计费,长时间自治循环的经济性会迅速恶化。因此评估此类工作流时,需区分“实验性补贴价”与“真实边际成本”。
这套方法适合谁
Theo自己的结论很直接:现在不该这么干。过程痛苦、坑多,而且会让人上瘾到只想继续拆掉下一个瓶颈。
但如果把它当作一种思维练习,价值在于三点:第一,识别哪些任务具备可验证性,这是agent能长时间自治的前提;第二,把"管理agent"理解为供给算力和清除阻塞,而不是逐行审查产出;第三,意识到工具链本身也是可被优化的对象——当你不断追问什么在拖慢agent,答案往往会指向下一个值得重写的组件。
随着推理成本持续下降,今天看起来奢侈的循环,明天可能只是常规操作。真正稀缺的不是token,而是设计验证机制和发现瓶颈的能力。
相关推荐
DeepSeek V5代码泄露?实为兼容性测试
AI晚报速览:DeepSeek Harness代码出现V5模型名被指兼容性测试,Artificial Analysis V5榜单发布、DeepSeek并列开源模型第一,Codex重置完成预告明日消息,编程Agent安全风险与OpenAI采购TPU传闻同步解读。
专为DeepSeek打造的AI编程终端:38K星开源项目深度解析
深入解析专为DeepSeek打造的开源AI编程终端:38K星标项目支持20个代理并行、三种安全模式与OS级沙箱隔离,一句话需求自动完成读文件、改代码、跑命令全流程。
乌镇大会信号:开源成中国AI换道超车关键牌
乌镇互联网大会将开源开放顶到C位,华为、Kimi、MiniMax、DeepSeek等国产开源模型集中亮相。本文深度解析开源为何成为中国AI换道超车的关键牌,以及开源背后的生态标准之争、安全治理与商业化难题。