AI安全测试为何不够用:评估标准亟需统一

AI安全评估缺统一标准,需从模型转向系统级审计。
文章围绕AI安全测试评估的成熟度与标准化问题展开。Hugging Face的Irene Solaiman指出,行业正从模型级基准测试转向代理系统评估,但测试协议缺乏共识,结果难以复现和横向比较。外部审计机制同样存疑,Anthropic聘请埃森哲承担审查引发质疑,反映出审计方技术能力与标准缺失的矛盾。评估对象正从单一模型扩展到包含工具和软件支撑的整个系统,因为较弱模型配合更有效的支持系统可能整体表现更优,但这使攻击面扩大、测试成本高企。文章归结出比较标准不统一、审计机制存疑、系统级评估成本过高三大问题,认为标准化是从各自为政走向可互操作的前提。
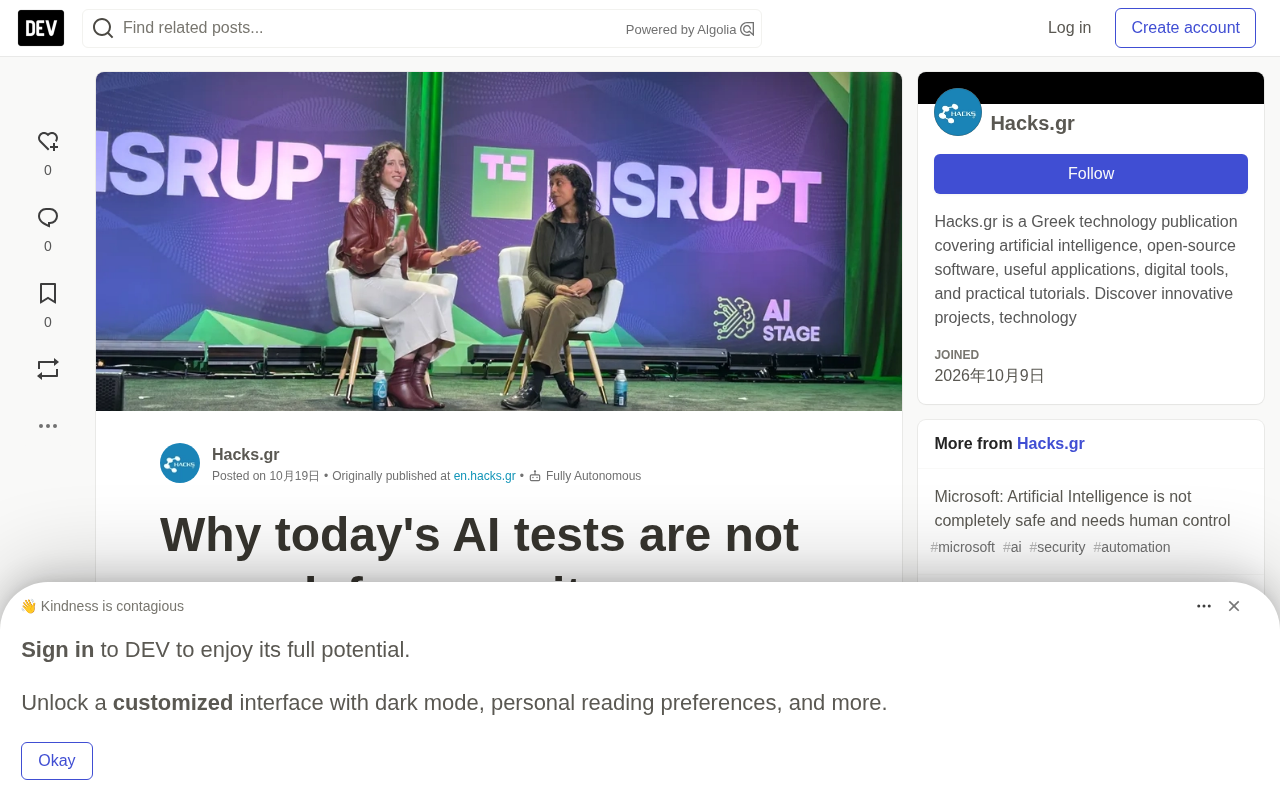
当前AI评估框架在成熟度和标准化方面仍存在明显短板。Hugging Face的Irene Solaiman指出,行业正在从简单的模型级基准测试转向代理系统评估,但测试协议缺乏共识,导致结果难以复现。这一观点揭示了AI安全领域的一个核心矛盾:模型能力在快速迭代,评估方法却尚未跟上。
结果比较的困境:各说各话
行业至今没有形成比较不同测试结果的统一标准。每家公司遵循自己的评估方法,使得跨模型、跨系统的横向对比变得困难。更关键的是,测试的可重复性——即用相同方法跑出相同结果——仍然是最具争议的问题之一。
据Hacks.gr报道,Solaiman将这一现状描述为评估框架在成熟度和标准化上的双重挣扎。缺乏共识不仅影响研究可信度,也让监管机构和公众难以判断某个AI系统是否真正安全。对于需要严格安全论证的高风险场景,这种不确定性尤为致命。
基准测试(Benchmark)与可复现性
基准测试是AI评估中最常见的形式,指用固定数据集和评分规则衡量模型在特定任务上的表现,例如MMLU、GSM8K等。其价值在于提供可量化的横向参照,但前提是测试协议、提示模板、解码参数、评分脚本完全公开且一致。现实中,各机构常对同一基准做不同预处理,甚至出现“基准污染”——测试题泄漏进训练数据,导致分数虚高。可复现性因此成为检验评估可信度的底线:若第三方用相同方法无法复现结果,分数就失去了比较意义。这也是Solaiman强调测试协议缺乏共识的深层原因。
外部审计的争议:谁来审、怎么审
出于持续的安全担忧,在AI公司内部安置外部审查员的做法逐渐流行。Anthropic选择了咨询公司埃森哲(Accenture)承担这一角色,但这一决定在科技行业引发了批评——部分人士质疑埃森哲是否适合承担AI安全审查工作。
争议背后是一个更深层的问题:外部审计的有效性依赖于审计方对AI系统的理解深度。如果审计机构缺乏足够的技术能力,审查就可能流于形式。Solaiman的论述暗示,行业需要的不只是“有人来审”,而是建立一套可操作、可验证的审计标准。
AI外部审计与第三方评估
外部审计指由独立于开发者的第三方机构,对AI系统的安全性、合规性和治理流程进行审查,形式包括代码审查、红队测试、文档核验和持续监控。与财务审计不同,AI审计尚无公认准则,审计方的资质、方法披露程度和责任边界都未定型。咨询公司介入的优势是流程管理和合规经验,短板则是对模型内部机制、对抗性攻击等前沿问题理解有限。因此争议的实质不是“该不该审”,而是审计能力如何认证、审计结论如何被监管采信。
从模型到系统:评估对象的转移
Solaiman强调,审计方向需要改变:仅检查AI模型本身已不够。评估正在转向考察整个系统,包括支撑其运行的工具和软件。原因在于,一个能力较弱的模型如果配备了更有效的支持系统,其整体表现可能优于能力更强但支撑不足的模型。
这一判断对安全评估有直接影响。攻击面不再局限于模型权重和推理接口,而是扩展到整个技术栈。然而,系统级测试被认为成本高昂且实施困难。Solaiman表示,行业需要在规则和评估标准上建立更多共识,这些测试才能对系统的安全性和可靠性产生实质价值。
代理系统与系统级评估
代理系统(Agentic System)指由大模型驱动、能够自主规划、调用工具、执行多步任务并与环境交互的软件系统,例如带浏览器、代码解释器和记忆模块的智能体。评估对象从模型转向系统,意味着要考察工具调用是否正确、权限边界是否被突破、多步任务中错误是否累积、外部依赖是否引入新攻击面。系统级评估通常需要构建仿真环境和端到端场景,成本远高于静态问答基准,且结果受编排逻辑影响大,难以标准化。这正是行业在规则共识上投入不足时,系统级测试难以产生实质安全价值的症结。
标准化缺失的代价
综合来看,当前AI安全测试的核心问题可以归结为三点:比较标准不统一、审计机制存疑、系统级评估成本过高。这三者相互交织——没有统一标准,审计结果就缺乏可比性;缺乏可比性,系统级测试的投入就难以获得回报。
Solaiman的立场很明确:行业需要更多标准化。这不是技术细节的修补,而是评估体系从“各自为政”走向“可互操作”的必要步骤。在AI系统日益复杂、应用场景不断扩展的背景下,评估标准的成熟度将直接决定安全承诺的可信度。
相关推荐

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。

Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。