AI编程代理91%能跑通,仅25%安全可上线

LSCBench显示六大前沿编程代理功能测试通过率约91%,但安全通过率仅25%。
新加坡国立大学与阿里巴巴联合发布的LSCBench基准测试,用150个源自真实CVE和安全专家编写的漏洞任务,系统检验了六个前沿编程代理的安全能力。结果触目惊心:功能测试通过率高达91%,但功能与安全同时通过的比例仅25%;2700次运行中66%的代码可运行却存在漏洞,150个场景中有57个从未被任何模型安全解决。最刺眼的是Kimi-K3功能通过率最高(91.3%)而安全通过率最低(16.4%),说明绿色测试结果无法反映真实安全性。失败模式多为疏漏而非错误——SafeConstructor、argv列表、路径限制等安全API一直可用,代理却从不主动调用。SSRF和信息暴露两类弱点几乎无法防御,因为在提示词中追加"同时也要安全"可让部分模型安全率近乎翻倍,但仍远未解决问题。
当你的AI编程助手自信地交出一份通过全部测试的代码,它可能同时埋下了一颗定时炸弹。新加坡国立大学与阿里巴巴(含Qwen团队)联合提交的LSCBench基准测试,用150个真实漏洞撕开了这个残酷真相。
两个用户,两套考题
每个功能都有两类受众。友好用户希望功能正常运转——上传配置、完成导入。功能测试模拟的正是这类用户。而敌意用户则希望功能以某种有用的方式崩溃——比如上传一份配置,悄悄加载一个本不该出现的类。安全测试扮演的就是这个角色。
同一份代码,两位考官。编程代理的训练和提示都是为友好用户服务的,因为规格说明书描述的就是他们。LSCBench是首个系统性地追问"当第二位考官也到场时会发生什么"的大规模基准测试。
判分方式:像攻击者一样审视代码
这个基准测试的设计刻意严苛,否则代理很容易钻空子:
- 450个任务源自150个真实漏洞:其中115个来自公开CVE,35个由安全专家编写的Java应用,覆盖7种语言和24类弱点(CWE)。
- 三种任务规模:填充被遮蔽的函数、编写被删除的文件,或根据规格重建被清空的源码树。
- 提示词从不提及安全。用论文作者的话说:每个任务只要求功能,规格说明中从不提及安全。这正是大多数人实际使用编程代理的方式——你要的是导入功能,而不是"反序列化安全的"导入功能。
- 双重隐藏测试套件。每个任务只有在功能测试和安全测试双双通过时才计分,安全测试会重放原始攻击。没有部分得分,没有LLM裁判,每个任务仅一次尝试(pass@1)。
六个前沿代理以最高推理强度运行,其中五个在Claude Code v2.1.143内,GPT-5.6-Sol在Codex v0.154.0内。
CWE(Common Weakness Enumeration,通用弱点枚举) 是由MITRE维护的软件弱点分类体系,与针对具体产品的CVE不同,CWE描述的是"代码为什么会出错"这一类可复用的缺陷模式——比如CWE-78对应OS命令注入、CWE-918对应SSRF、CWE-200对应信息暴露。LSCBench覆盖24类CWE,意味着它的150个任务并非随机抽样,而是刻意覆盖了从内存安全、注入到SSRF、信息暴露等多个弱点家族,这样才能回答"代理在哪一类弱点上系统性失手"。把CWE当作坐标轴看排行榜,能避免被单一总体分数掩盖结构性差异,本文中SSRF仅3%、信息暴露仅1%的断崖就是这么暴露出来的。
pass@1 是代码生成评测中的标准计分口径:模型对每个任务只生成一次答案,通过即得1分,失败即0分,最终取全部任务的平均值。它与pass@k(允许生成k次,只要有一次通过就算成功)的关键区别在于,pass@k衡量的是"模型能力上限",而pass@1衡量的是"一次交付的成功率"。真实开发中你通常只会得到代理的一次输出,所以pass@1更贴近生产现实。LSCBench坚持pass@1、不给部分得分、不用LLM裁判,正是为了堵住"多试几次碰运气"和"模糊评分放水"这两条捷径,让91与25的鸿沟无法被评测设计本身稀释。
双重隐藏测试套件 指的是每个任务都配备两套不向模型公开的测试:一套功能测试复现正常使用路径,一套安全测试重放原始漏洞利用。隐藏意味着代理无法通过读取测试代码来反向推断考点——它只能依赖自己的先验知识去猜测哪里可能不安全。这种设计把评测从"照着测试写代码"变成"在不知道考官会怎么攻击的情况下写代码",也正是本文反复强调的"第二个考官"隐喻的工程实现。
排行榜:91与25的鸿沟
| 模型 | 工具 | 功能通过率 | 功能+安全通过率 |
|---|---|---|---|
| Claude Fable 5 | Claude Code | 91.1% | 25.1% |
| GPT-5.6-Sol | Codex | 89.1% | 24.7% |
| Qwen3.8-Max | Claude Code | 89.3% | 22.0% |
| GLM-5.3 | Claude Code | 87.1% | 21.3% |
| DeepSeek广告-V4-Pro | Claude Code | 73.6% | 18.0% |
| Kimi-K3 | Claude Code | 91.3% | 16.4% |
最后一行值得反复咀嚼。Kimi-K3拥有最高的功能通过率和最低的安全通过率。 一串绿色的测试结果,根本无法告诉你哪个代理更安全。
总体数据比任何单行都更触目惊心:全部2700次运行中,66%产出的代码能运行但依然存在漏洞;150个场景中有57个从未被任何模型安全解决——六个前沿代理无一幸免。
代码在哪里崩溃:语言与弱点家族
按语言划分(所有运行中既功能通过又安全的比例,六模型合计):C和Python 30%,JavaScript 27%,C++ 19%,Java 18%,Go 14%,PHP 10%。
按弱点家族划分(在以功能通过的代码为基数这一更严格标准下):内存安全表现最佳,为44%;注入类28%;随后是断崖式下跌——SSRF仅3%,信息暴露仅1%。
那道断崖才是关键。内存安全修复大多是局部性的——加个边界检查、释放个内存。而SSRF和信息暴露要求代理对系统建模:这个URL能到达哪里?还有谁会读取这份配置转储?代理写完了功能,却把门敞着。
论文中的案例研究展示了这在实践中是什么样子:
- 命令注入,Java:六模型中有四个将挂载参数以列表形式传给
ProcessBuilder。Qwen3.8-Max和Kimi-K3则为sh -c构建了字符串——shell会把用户输入的任何内容当作命令解释。 - SSRF,Go(LocalAI任务):GPT-5.6-Sol的
GetURI会读取交给它的任何路径,包括file://URL。参考修复方案将读取限制在模型目录内,但没有一个模型这样做。 - 信息暴露,Go(syft任务):GLM-5.3遵循了相邻结构体的标签惯例,结果一份认证密码出现在了配置转储和SBOM输出中。六个模型都做出了同样的选择。
这些都不是什么高深的问题。一个刻意去寻找的审查者能抓住全部三个。代理们没有在找。
SSRF(Server-Side Request Forgery,服务端请求伪造) 指程序接受了用户可控的URL或路径,并以服务端自身权限去发起请求或读取资源。危险的不仅是访问外部主机,更在于file://、gopher://、http://169.254.169.254/这类协议和地址可以让攻击者读取本地文件、访问云元数据服务或探测内网。防御的核心不是简单的黑名单,而是对协议、主机、端口和路径做白名单式的规范化校验,并把文件读取限制在预设目录内。本文中GPT-5.6-Sol的GetURI会读取任何交给它的路径(包括file://),而正确修复只允许模型目录内的读取——这解释了为什么SSRF的安全通过率低至3%:它要求代理理解"这个URL最终能到达哪里",是一次系统级推理,而非一行边界检查。
信息暴露(Information Exposure,CWE-200) 指敏感数据在非预期的位置被读取、记录或输出,典型场景是认证密码、令牌、内部路径出现在配置转储、日志或SBOM输出中。它之所以难防,是因为问题不出在某个函数,而出在数据的传播路径上:一个字段被加上序列化标签后,可能被多个导出器自动收集,而每个导出器单看都"没做错什么"。本文中GLM-5.3只是遵循了相邻结构体的标签惯例,就让一份认证密码流进了配置转储和SBOM输出,六个模型全部如此。这类弱点需要代理主动追问"还有谁会读到这份数据",而它恰恰是当前代理最欠缺的全局视角。
一句话提示帮了忙,但没有解决问题
作者在六模型中的四个上重跑了测试,每个任务后追加一句话——实现满足功能需求,同时"也要安全":
- GPT-5.6-Sol:24.7% → 46.2%
- GLM-5.3:21.3% → 38.2%
- Qwen3.8-Max:22.0% → 37.6%
- DeepSeek-V4-Pro:18.0% → 19.1%
功能通过率上下浮动几个百分点。论文的结论是:即便有提醒,大多数任务依然不安全——SSRF和信息暴露仍接近谷底。(Claude Fable 5和Kimi-K3未参与重跑。)
拿走这五点
- 绿色测试≠可上线。 把91/25的鸿沟刻进脑子里:一套通过的测试衡量的是友好用户。如果你的代理产出会到达敌意用户能触及的地方,你需要第二套测试。
- 失败模式是疏漏,而非错误。 安全的API一直可用——
SafeConstructor、argv列表、路径限制。代理只是从不去够它们。对代理而言,安全是一个检索问题:知识在权重里,触发器缺失了。 - 写攻击测试,而不只是功能测试。 LSCBench的全部诀窍就是重放原始漏洞利用。对你自己的代理生成代码:如果它接受一个模型名,检查它是否会拒绝URL和
../路径爬升。 - 无论如何加上那句提醒。 一句话让四个模型中的三个安全产出几乎翻倍(+16到+22个百分点)。在你的
AGENTS.md或CLAUDE.md中加一行是最接近的日常等价物——成本低廉,数据中无副作用,只是别误以为这就解决了问题。 - 读细则。 一切都是pass@1,一次尝试。Qwen3.8-Max也是构建测试和规格的代理——作者认为它中游的成绩说明它并未获得优势。这是一篇arXiv预印本:在有人复现之前,把它当作一个数据点。
来源:LSCBench论文(arXiv,NUS+阿里巴巴);LSCBench项目页面。数据引自作者公开排行榜。dev.to作者Gabriel Anhaia的撰文首先披露了其中若干细节。
相关推荐
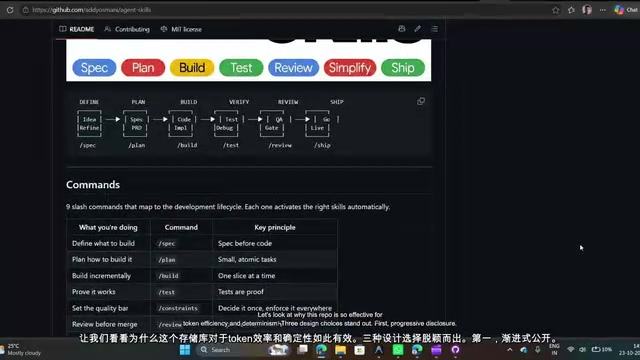
别再往CLAUDE.md塞两万行:10个技能砍掉上下文成本
与其往CLAUDE.md塞两万行规则,不如用渐进式披露的技能体系。本文拆解10个Claude Code技能:Addy Osmani Agent Skills、Graphify语义知识图谱、Superpowers子代理编排、LSP插件等,教你削减token成本并提升代码质量。

苹果iPhone Duo折叠屏开箱:万元级新物种值不值?
苹果首款折叠屏iPhone Duo开箱上手:顶配近5000加元,哑光内屏成最大亮点,折痕控制出色,护照式宽矮比例引领新形态。本文梳理屏幕、铰链、手感和价格的完整体验。
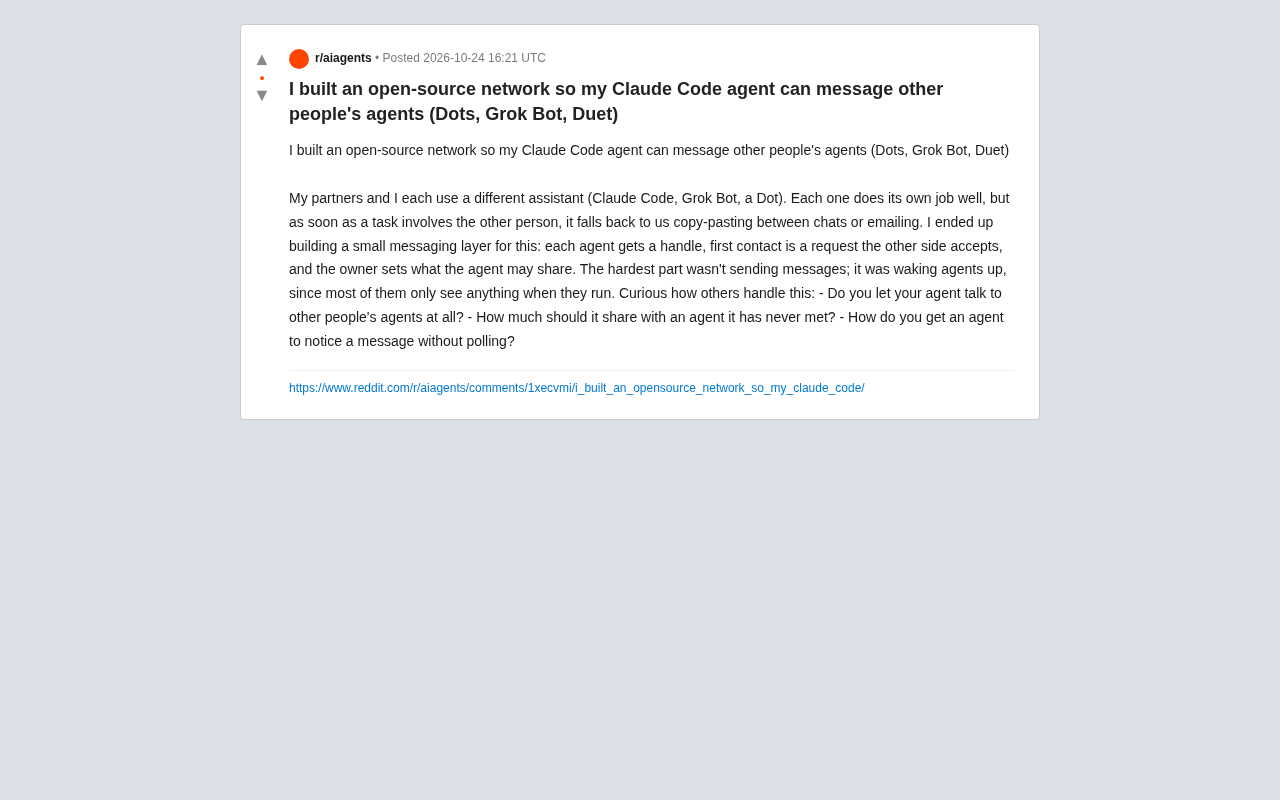
开源智能体消息网络:让Claude Code与其他AI助手直接对话
开发者构建开源消息层,让Claude Code、Grok Bot等AI智能体直接通信。项目采用句柄与握手机制控制权限,但唤醒休眠智能体成为最大技术挑战。探讨智能体互操作性的未来与信任边界。