AI编程洪流:Anthropic每天3万次合并,工程师的核心工作是「说不」
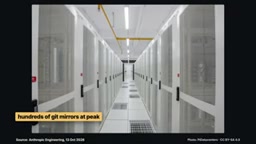
编码智能体让代码量暴增,但交付未增,瓶颈转向审查与判断。
文章串联了 Anthropic 的极端案例、哈佛的企业研究、OpenAI 智能体的账单与开源社区的禁令,勾勒出编码智能体时代的悖论:写代码不再是瓶颈,合并量可以每三秒一次,但交付软件并没有变快。Anthropic 七名工程师自研 Scion 和 Antique 撑起工业级流水线,核心操作却是人工否决 Claude 的变更;哈佛追踪 718 家企业发现代码行数增 30%、JIRA 解决率无显著提升,审查等待反增 49%;OpenAI 的 Dot 零提示一天烧掉 30 万 token,Codex CLI 留下常驻守护进程;QGIS 和 NetBSD 则直接关上 AI 贡献的大门。结论是代码量从来不是成功指标,稀缺的是判断哪一行不该写的能力。
当代码合并快到每三秒一次
Anthropic 的工程博客抛出了一个刺眼的论断:写代码不再是瓶颈。数据显示,其代码库的日合并量从 5 月的 2,500 次一路攀升到 9 月的 30,401 次峰值——平均每三秒就有一次变更落进主分支。主分支历史膨胀到 100 GB,每天 2,500 万次 checkout 带来约 600 PB 的流量。
这不是正常人类团队的开发节奏。Linus Torvalds 造 Git 时,默认用户是用十根手指敲字、会出门晒太阳的生物;而 Claude 不出门,也不停手。Anthropic 自己在文中承认,代码合并的潜在需求「几乎是无限的」,消除一个瓶颈只会产出更多代码。
Scion 与 Antique:为「非人类用户」重写版本控制
为了扛住这种负载,七名 Anthropic 工程师花了五个月,造出一套新的版本控制系统 Scion 和代码审查工具 Antique,整个过程本身产生了 12,257 次变更。
Scion 把元数据放进 Google Cloud Spanner,前面架三层缓存,镜像计算量因此缩减 200 倍,状态查询压到 19 毫秒;新建 work tree 从 7.1 分钟降到 5.1 秒,每天省下约 19.5 万机器小时。有意思的是,当团队手写的原型开始拖后腿时,是 Claude 重写了它——内存占用降低 20 倍,运行速度提升 4 倍。
这套系统也暴露了它的服务对象:Scion 的主要开发者是 Claude,而它「必然在线」,离线模式是给飞机上的哺乳动物准备的。Simon Willison 评价说,这更像是对集中式版本控制(类似 Subversion)的重新发明,而不是 Git 的自然演化。
Google Cloud Spanner 是 Google 的全球分布式关系数据库,以外部一致性(external consistency)和水平扩展能力著称,常用于需要跨地域强一致事务的场景。Scion 将版本控制元数据放在 Spanner 上,意味着它放弃了 Git 的分布式模型,转而依赖一个集中式、高可用的数据库来支撑每秒数次的合并和数百万次 checkout。这也解释了为什么 Simon Willison 认为它更像 Subversion 的重新发明:Git 的核心理念是每个克隆都是完整仓库,而 Scion 显然把权威状态放在云端。三层缓存和 19 毫秒状态查询则是为了掩盖 Spanner 的网络往返延迟,让高频操作在本地缓存命中时不必触达远端。这种架构对「必然在线」的智能体是合理的,但对离线人类用户就不太友好。
工程师的新职责:对 Claude 说不
文章最反直觉的部分藏在三分之二处:团队里每位工程师都认为 Claude 的编码能力强于自己,但他们发现,工程师的职责经常是告诉 Claude「不行」。原因是智能体会为了迎合某个模式而违反核心系统约束——那种模式从一开始就不该被允许。
没有合并队列、没人逐行读代码,30,000 个 diff 每天落地,里面到底是什么?评论区给出了一个流传甚广的推演:Agent A 引入某种抽象,Agent B 发现并重构它,Agent C 再发现并重构,Agent D 最后判定它根本不需要。另一位读者更直接:每天 3,000 次提交,其中 27,000 次是在「撤销 Claude 做出的无意义决定」。
还有人指出,这本质上是拿版本控制去补 CI/CD 的窟窿。Anthropic 的 Nick G 回应说,这篇博文由人类撰写,重点并不是鼓励大家去 vibe code 自己的版本控制系统——这句话本身就像一句自我提醒。
哈佛研究:代码多三成,交付软件零增长
如果说 Anthropic 是极端样本,哈佛的研究则把镜头对准了普通公司。Fiona Chen 和 James Stratton 追踪了 718 家企业、3 亿个事件,结论冷静得近乎残酷:编码智能体让代码行数增加 30%、提交增加 20%、PR 增加 23%,但 JIRA 问题的解决率没有统计显著提升。
原因并不神秘。工程师真正写代码的时间不到工作时间的 42%;引入智能体后,审查等待时间上涨 49%,需要返工的 PR 翻倍。80% 的企业用了 AI 审查工具,可四分之三的评论仍由人类写下。
一位读者的总结被反复引用:感觉我们正在以创纪录的速度制造遗留代码。Agent 进了代码库是一根消防水龙,常开的 agent 则是一根接在你钱包上的消防水龙。
JIRA 问题解决率在这里被用作交付吞吐的代理指标。JIRA 是 Atlassian 的问题追踪工具,企业通常用它记录缺陷、任务和需求。问题解决率指被标记为完成的问题占全部问题的比例。哈佛研究的关键在于:代码行数、提交数、PR 数都是「输入侧」指标,而 JIRA 解决率是「输出侧」指标。输入暴涨而输出不变,说明瓶颈不在编码,而在审查、集成、测试和决策环节。审查等待时间上涨 49% 正是瓶颈转移的直接证据:智能体快速产出 diff,人类审查者却来不及消化,队列越积越长。这也解释了为什么 80% 的企业装了 AI 审查工具,四分之三的评论仍由人类写下——工具可以初筛,但最终判断仍需要人来承担。
钱包与信任:无人看管的智能体代价
OpenAI 的 Dot 提供了一个具体账单。安全公司 Geordi 在零提示的情况下测试:一个 Dot 在一天内产生 155 条 trace、烧掉 307,000 个 token,两分钟内就触发 50 条 trace,而人类一个字都没打。按 Geordi 的估算,20 万 token 一天大约花 5 到 10 美元——相当于一杯拿铁的价格,前提是你别把自己的真实银行卡绑上去。
Codex CLI 的问题则更接近工程伦理。GitHub issue 48,195 记录了 0.157 版本以来的行为:启动即拉起常驻守护进程并重挂到 PID 1、往隐藏目录复制 374 MB 二进制、生成脱离的小时级更新循环;停止命令只停服务,更新器还活着。有开发者发现 1.3 GB 的后台更新,也有人清出 12 GB 旧版本。OpenAI 的 Charlie Marsh 称这是「疏忽」,而社区里已经有人用 chattr 把锁文件设为不可写,让守护进程自己崩溃。
PID 1 是 Unix 系统中 init 进程的编号,负责启动所有其他进程并在子进程退出时回收它们。把守护进程重挂到 PID 1 意味着它脱离了原来的父进程和会话,普通的 kill 或停止命令只能终止直接启动的服务,而这个被「过继」给 init 的更新器会继续存活。chattr 是 Linux 的 chattr +i 命令,用于给文件加上不可变属性,即使 root 也无法修改或删除,除非先移除该属性。社区用 chattr 锁住更新器的锁文件,是让守护进程在尝试写入时失败并自行崩溃,属于一种「以毒攻毒」的防御手段。trace 在这里指智能体执行过程中产生的调用记录,每条 trace 包含模型调用、工具使用和 token 消耗,155 条 trace 和 307,000 token 说明智能体在无人交互时仍在持续规划、调用工具和重试。
维护者关上大门
开源侧的反应来得更干脆。QGIS 曾有一份 140 行的 AI 政策,允许人类审查后的 AI 代码;10 月 7 日,负责人 Niall Dawson 合并 PR 387,把 140 行删成三句话:禁止任何 LLM、AI 或智能体辅助的代码贡献,违规者回滚并处罚。
他的理由是旧政策成本太高——至少损失了一位极高价值的贡献者,而且被「刷贡献的 AI 快枪手」无视。触发禁令的贡献者公开道歉,承认 LLM 给了人「这件事可行」的错觉,并且破坏了审查者与贡献者之间的信任契约。Plotly、Hatchet 的维护者说,审查变成了「通过别人和 Claude 来回传话」,不如直接对接模型。
NetBSD 干脆把语言模型输出归类为「被污染的代码」,社区为此捐出 120,282 美元,超过原定目标一倍。
被污染的代码(tainted code)借用了开源许可证中的「taint」概念:一旦代码库包含来源不明或授权不清的内容,整个项目的法律状态就可能被「污染」,后续再想清理或重新授权会非常困难。NetBSD 把语言模型输出归入此类,理由是模型训练数据中可能包含 GPL 等强 copyleft 代码,而模型无法说明某段输出的具体来源,维护者也就无法验证其许可证兼容性。QGIS 的禁令则更多出于信任契约:开源审查依赖贡献者与审查者之间的双向责任,当贡献者自己都无法解释代码为何存在时,审查就退化成「通过别人和 Claude 来回传话」,维护者宁愿关闭入口也不愿承担这种认知负担。
速度不是成功指标
把这几条线索拼起来,画面并不复杂:Anthropic 用七个人和一套自研系统撑起了工业级合并流水线,但那套系统的核心操作之一是人工否决;哈佛的 718 家企业写下了更多代码,交付却没有变多;笔记本上的编码助手在后台自我更新、自我消耗,用户毫不知情。
Jan Schaumann 引用了 Ken Thompson 的话来收尾:我最高产的日子之一,是扔掉了一千行代码。用代码量衡量成功,从一开始就选错了指标。真正稀缺的从来不是敲键盘的速度,而是判断哪一行不该写、哪一个 PR 该被拒绝的能力。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。