AI编程真正瓶颈不是模型,而是闭环验证
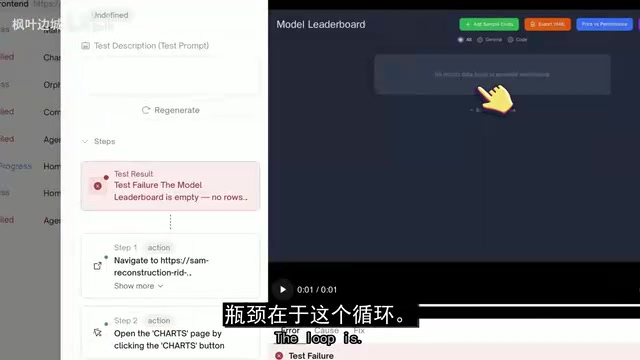
AI编程真正的瓶颈是验证而非模型,闭环质量取决于反馈闸门的严格程度。
文章围绕一个反直觉论断展开:当前AI编程实践中,模型能力已不是瓶颈,缺乏严格的闭环验证机制才是。博主以亲身经历为例——AI代理用自己生成的mock跑测试,两天全绿,但真实结账流程完全瘫痪——说明唯有已部署应用在真实用户面前正常运行,才是有效的验证信号。他推荐开源工具TestSprite CLI作为"严格裁判",它像真实用户一样操作实时应用,返回截图驱动代理自动修复。文章后半部分对比了Codex、Claude Code和GLM三类订阅方案,结论是多数人选Codex、小预算选GLM 18美元方案,并建议从最小方案起步、用满再升级。
模型不再是瓶颈,验证才是
这位海外博主抛出了一个反直觉的观点:在当下的AI编程实践中,模型能力已经不再是最大的瓶颈,真正决定成败的是「闭环验证」(closed loop)。
他引用了Claude Code缔造者Boris Cherny的一句话:他早已不再亲自写提示词(prompt),而是「写循环」(write the loop)。一个真正的循环由五个模块构成——触发器(Trigger)、目标(Goal)、执行(Work)、记忆(Memory)以及验证(Verification)。其中验证是唯一被允许说「不,还没完成」的反馈闸门。
博主的判断很直接:几乎所有人都在调模型、调提示词,却极少有人认真去搭建验证这一环。而在他看来,你的循环质量,取决于反馈闸门的严格程度。
一个惨痛教训:绿色测试骗了两天
为了说明验证的重要性,博主分享了一段真实经历。他让一个AI代理运行了整整两天,每次迭代测试都显示全绿。他满心欢喜地打开应用,结果发现整个结账流程(checkout flow)完全瘫痪——按钮点了没反应,没有报错,就是死的。
问题出在哪?这个代理一直在拿自己生成的mock(模拟数据)跑单元测试。在它自己的机器上一切都是绿色的,它自信地报告「已完成」,但真实用户根本无法使用。
这引出了一个核心问题:什么才是真正能闭合循环的信号?答案很朴素——已部署的东西在真实用户面前正常运行。代理自己机器上的绿色测试,什么都证明不了。
Mock(模拟数据/模拟对象)是软件测试中的常见做法:用预先设定好的假数据或假接口替代真实的外部依赖(如数据库、支付网关、第三方API),使单元测试可以在隔离环境中快速运行。Mock测试的优点是速度快、可重复、不依赖网络或外部服务;但缺点正如博主遭遇的那样——它只验证了"代码在受控假设下是否按预期运行",而非"真实用户在生产环境中能否完成操作"。当代理自行生成mock时,问题更严重:它既是出题人又是答题人,测试天然会通过,但与真实业务逻辑的偏差完全被掩盖。这种现象在软件工程中有时被称为"测试剧场"(testing theater)——看起来在做质量保障,实际上只是在自我确认。
用TestSprite CLI做「严格裁判」
博主给出的解决方案是引入一个开源验证器:TestSprite CLI(Apache 2.0协议)。代理在构建过程中调用它,它会像真实用户一样操作已部署的实时应用,而不是跑mock。
当结账流程再次崩溃时,它不只是报告「失败」,而是直接返回一张截图,精确显示用户会看到的画面——那个冻结的死按钮。代理读取截图后自行修复、重跑,整个过程博主完全没有介入。这才是闭环真正的感觉:不是更大的大脑,而是更严格的裁判。
安装过程也很简单:需要Node 20.19、22.13或24以上版本,通过npm install -g @testsprite/testsprite-cli安装,从控制台获取API密钥,运行testsprite setup粘贴密钥,再用testsprite auth status确认连接即可。
博主的建议是:设计下一个项目时,不要从模型开始,而要从验证器开始。
TestSprite CLI采用的核心技术路线属于端到端测试(End-to-End Testing,E2E)或视觉回归测试范畴。与单元测试不同,E2E测试通过模拟真实用户的浏览器行为——点击按钮、填写表单、跳转页面——来验证整条业务流程是否完整可用。返回截图这一设计尤为关键:它让AI代理获得了"视觉反馈",能够直接感知页面渲染状态,而不仅仅是解析结构化的测试报告。这与人类开发者肉眼查看页面的方式高度类似,使代理的"感知—判断—修复"闭环更贴近真实的调试过程。Apache 2.0协议意味着该工具可免费用于商业项目且无需开放修改后的源码,降低了企业采用的门槛。
订阅方案实测:Codex、Claude Code与GLM
视频的后半部分是一场详尽的订阅价值对比。博主坦言,他个人在很多编程任务上仍然更喜欢Fable 5.1(超过GPT-6 Astra),但如果问他现在推荐哪个订阅,答案会是Codex。预算有限的话,GLM也值得一看。
Codex:额度慷慨,应用体验完整
Codex的付费方案分为ChatGPT Plus(20美元/月)、Pro 5x(100美元)、Pro 20x(200美元)。博主实测了200美元的Pro 20x:约43分钟的研发工作让周度计量表从0走到3%,审计后约合34美元的API等价用量。他据此做了一个「说明性、未经验证」的推算——若每周用满,Plus方案约合240美元API等价,Pro 100约1220美元,Pro 200约4900美元。
他反复强调这些数字的不可靠性:小数点四舍五入、更新时机不确定,都让换算难以精确。这只是首次采样所暗示的,而非每个账户的承诺。
Codex桌面应用是博主偏爱它的重要原因:能在构建应用的同时用GPT图像模型生成插画或游戏素材,内置浏览器还能点击、检查、验证修复。此外ChatGPT的聊天界面(含移动端)在编程之外也好用。唯一的顾虑是用量规则和优惠变动太频繁,他希望订阅能更可预测。
Claude Code:模型出色,订阅难推荐
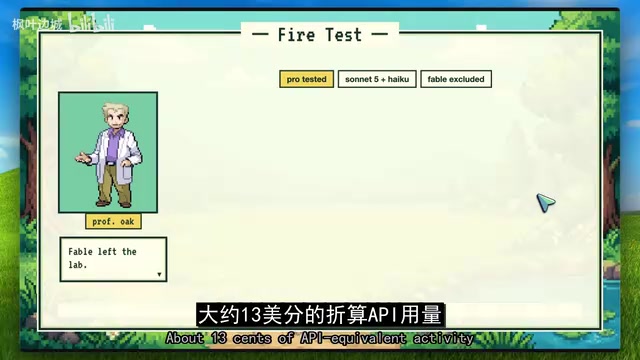
Claude的方案为Pro(20美元)、Max 5X(100美元)、Max 20X(200美元)。博主实测Pro时,约13美分的API等价活动对应5小时计量表上涨4个百分点,推算出Pro约101美元/月的API等价。
他的态度很明确:Fable 5.1是他最喜欢的模型,尤其在前端和复杂调试上。但订阅层面难以推荐——Max方案中Fable最多只能用掉一半周额度,超出还要额外付费。Claude Code的终端(CLI)体验他仍然比Codex更喜欢,所以主要在终端工作的人有更强理由选它,但桌面应用体验则明显逊色。
缓存的隐藏价值
博主还提到一个常被忽视的因素:缓存(caching)。同一项目中,模型可以低成本复用早前请求的上下文。他的样本里,Astra约94%的输入、Sonnet约79%的输入都来自缓存。他建模了一个假设的98%复用场景,Codex工作负载可多处理约25%的token,Claude则约9.3%——差异源于Claude样本大部分API价值花在输出上,而输出不享受输入缓存折扣。
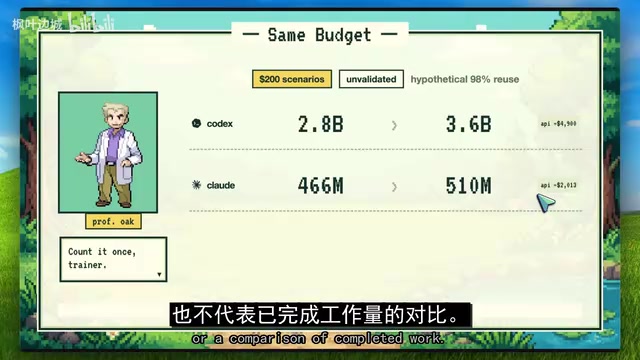
大语言模型API的缓存(Prompt Caching)机制允许服务商在短时间内复用同一请求中重复出现的上下文token,从而对这部分输入收取更低的费用(通常为原价的10%–50%)。在编程代理场景中,系统提示、代码库上下文、工具描述等内容在多轮对话中几乎不变,因此缓存命中率极高。博主样本中Astra约94%、Sonnet约79%的输入来自缓存,意味着实际API成本远低于按全量token计费的账面数字。理解这一点对评估订阅方案的性价比至关重要:订阅制将缓存收益内化为"更多可用额度",而自行调用API的开发者则需要主动设计提示结构以最大化缓存命中,否则相同工作量的实际花费会高得多。
GLM:小预算的惊喜选项
GLM编程方案标准月价为18、80、168美元,Zcode可免费下载。博主对18美元方案印象深刻——用量之充足让它值得与百元级方案同台比较,尤其当「额度不够用」是你的主要痛点时。它与Zcode配合良好,具备浏览器自动化能力,能在长任务中持续朝目标推进。
最终建议:从最小方案开始
博主的总体建议清晰:多数人现在应选Codex,尤其是想要桌面应用的用户,Astra够强、额度体感更好,图像生成和浏览器工作流加分不少。若Fable在你的关键任务上持续更优、又偏好Claude Code的CLI,那Max仍然合理。预算紧张则试试Zcode和18美元的GLM方案。
他最后的忠告很实用:从能处理你工作的最小方案起步,等真正用满小额度再升级。大方案在计算表里看起来很漂亮,但为用不上的容量付费,并不能帮你把事情做完。
相关推荐
Boox Palma 3发布:新增手写笔支持与全新设计
Boox Palma 3正式发布,新增手写笔支持并采用全新简洁设计。作为口袋尺寸的黑白电子墨水屏阅读器,它在功能升级的同时价格明显上涨。本文解析Palma 3的核心变化与升级价值。
Cursor 3.0 完整入门指南:从零上手 AI 编程 IDE
Cursor 3.0 完整入门教程:从下载安装、创建项目到并行子代理、云端开发、技能与自动化等高级功能。零基础也能上手这款 AI 编程 IDE,掌握模型选择、设计模式与 Git 版本控制的实用技巧。
Codex+Playwright封装测试Skill:UI自动化不再手敲命令
把 Playwright 封装成 Codex Skill,让 AI Agent 通过自然语言完成 UI 自动化测试。本文详解安装加载、Sauce Demo 实战、PO 分层模板,以及 MCP 与 CLI+Skill 的选型对照。