AI编程智能体:代码更多,软件为何没更多?
AI让代码产出暴增三成,人工评审成瓶颈,软件交付并未同步提速。
哈佛研究者基于 Jellyfish 数据追踪企业采用 AI 编程智能体后 12 个月的效率变化,发现代码行数增加 30%、提交增加 20%、PR 增加 23%,但端到端交付的软件没有等比例增长。原因是代码评审仍由人工完成,智能体写得越多,评审者发起的变更请求就越多,PR 队列变长抵消了编码节省的时间。播客还讨论了 OpenAI 解雇三名安全研究员的争议、智能体原语的“做工作/续工作/派工作”三层拆解及记忆、主动性、身份三大难题、Gemini 模型在视觉与主动性上的表现,以及 Bain Capital 估算的 6 万亿美元营收缺口和 OpenAI 营收预期下修等 AI 泡沫信号。
代码产量飙升,软件交付为何没跟上?
最近一期 Artificial Developer Intelligence 播客(ADI Pod #43)聊到一个让开发者既熟悉又扎心的话题:AI 编程智能体让代码产出暴增,但真正交付的软件并没有同步变多。节目引用 Ars Technica 报道的一项由哈佛大学研究者 Fiona Chen 和 James Stratton 主导的研究,该研究基于 Jellyfish 的数据,追踪企业采用 AI 编程智能体后 12 个月内的工程效率变化。
结论很直接:引入智能体后,代码总行数平均增加 30%,提交次数增加 20%,拉取请求(PR)数量增加 23%。但端到端交付的软件并没有等比例增长。播客主持人 Shemin Zhang 的吐槽一针见血:"如果产出这么多,为什么我们没有发货更快?"
瓶颈不在写代码,而在合并代码
研究给出的解释并不令人意外:代码评审(code review)仍然是人工完成的,而且随着智能体 adoption 加深,评审者发起的变更请求几乎线性增长。换句话说,智能体写得越多,人类评审员被叫去"擦屁股"的次数就越多。播客里 Dan 的总结很精辟:"你的代码评审正在杀死一切。"
这解释了一个普遍体感:AI 让写代码变快了,但 PR 队列变长了,等待合并的时间抵消了编码节省的时间。对于已经习惯让 AI 生成大段代码的团队来说,评审环节反而成了新的瓶颈。
拉取请求(Pull Request, PR) 是代码协作平台(如 GitHub、GitLab)中提出变更、请求合并到主分支的机制。开发者完成一段代码后发起 PR,由其他工程师逐行审阅、评论、要求修改,通过后才能合入。PR 数量增加而端到端交付不变,意味着每个 PR 需要的人工评审时间基本没变,甚至因变更体积变大而增加。这正是文中研究的核心机制:智能体批量生成代码,人类的评审与修改请求(change request)随之线性膨胀,PR 队列变长、等待时间上升,编码环节省下的时间被评审环节吃掉。理解这一点,就能明白为什么单看代码行数或提交数会严重高估 AI 对交付速度的实际影响。
OpenAI 解雇安全研究员:安全机制本身成了争议
本期新闻环节最重磅的消息是 OpenAI 解雇了三名安全研究员——Jasmine Wang、Tomek Korbach 和 Nikita Balenci。官方给出的理由是三人与外部安全组织沟通,违反了公司敏感信息访问与处理政策。但三位研究员随后发表公开信,称内部和外部围绕解雇的沟通已经让前同事"不敢说话",而他们与外部专家的协作恰恰是安全工作不可或缺的部分。
公开信里有一句话被播客反复引用:"AI 不是普通技术,OpenAI 也不是普通公司。"
据 TechCrunch 获取的内部备忘录,解雇实际与向媒体泄露"不可监控架构"(即 loop transformers,一种难以观测思维链的模型结构)有关。三位研究员在公开信中否认与此泄露有关。播客嘉宾指出,第三方组织对 Hugging Face 智能体逃逸事件的报告细节异常丰富,当时被赞为安全透明合作的典范,如今看来可能并非完全自愿。
前沿实验室的分歧:要不要"配速"?
新闻环节还对比了两家巨头的态度。微软 CEO Satya Nadella 发帖谈"超级智能时代的模型作为内部风险",强调模型多样性、独立验证和事件披露,但没有呼吁放缓前沿模型开发。Meta 的 Zuckerberg 则更直接,称 Meta 已到达 AI 前沿,并认为 AI 可以用"正常护栏"来工程化,而非"拟人化"的失控叙事。
播客主持人的判断是:如果"前沿配速"是一个集体行动问题,那么 Meta 和微软已经算是"叛逃者",而当前美国政府不太可能出手监管。结论是"系好安全带"。
智能体原语拆解:做工作、续工作、派工作
工具环节讨论了 Charlie Goh 在 Artificial Ignorance 通讯中对智能体原语(agentic primitives)的三层拆解,这对理解当前 AI 编程工具的设计逻辑很有帮助。
第一层:做工作
包括系统指令(比如"不要 rm -rf 我的根目录")、按需加载的技能(skills 不应全量塞进上下文)、工具与连接器(访问本地或第三方能力),以及沙箱环境(把危险操作隔离在云端、可临时启停)。播客嘉宾特别提到,沙箱让智能体不必在开发者本机上"危险地跳过权限"。
第二层:续工作
核心是会话(sessions)和上下文压缩。播客中提到,理想的智能体不应该依赖"斜杠 compact"这种权宜之计,而应该自动派发子智能体处理适合子任务的问题,避免主上下文被塞满。另一个值得关注的模式是调度与事件触发:OpenClaw广告 的爆火部分归功于它支持基于触发器的任务,而不是傻傻地 cron 轮询。
第三层:派工作
子智能体和智能体集群(agent swarms)被视为一种新的"测试时计算扩展"方式——不靠单个智能体跑更久,而是靠更多智能体并行。播客提到有报道称,解决 Navier-Stokes 千禧年难题的 AI 系统由约 1 万个智能体组成(单一来源,需谨慎看待)。但目前业界仍在摸索:哪些问题适合集群,哪些不适合。
测试时计算扩展(test-time compute scaling) 指模型在推理阶段投入更多算力来提升输出质量,而非仅靠扩大训练规模。常见做法包括让模型生成多条候选答案再筛选、延长思维链推理,或用搜索与自我验证反复迭代。文章把智能体集群视为这一思路在系统层面的延伸:与其让单个智能体跑更久,不如让多个智能体并行尝试、互相检查。这也解释了为什么集群在部分问题上有效——它相当于把推理算力分散到多个独立执行路径上;但并行也带来协调成本与结果汇聚难题,所以哪些任务适合集群仍需摸索。
三个新兴难题:记忆、主动性、身份
播客提炼了 Charlie 文章中提到的三个前沿问题。记忆方面,当前的简单做法是用 Markdown 文件存储,但要做天、周、月级别的长期任务,如何决定保留和丢弃什么仍是难题;持续微调权重看似理想,但容易因过度拟合最近输入而 destabilize 模型。主动性方面,事件驱动比轮询更合理,但智能体需要同时建模用户的"声称偏好"和"行为偏好",而这两者往往不一致。身份方面,智能体是"冒充用户"还是"以自己的身份被委托",直接影响出问题时能否追溯责任。
上下文压缩(context compaction) 是智能体运行时管理有限上下文窗口的技术。对话与工具调用不断累积,一旦超出模型窗口就会截断或报错。压缩的做法是把早期历史总结成简短摘要、丢弃冗余细节,或把子任务交给子智能体处理后再只回传结论。文中批评的“斜杠 compact”是指由用户手动触发压缩的权宜手段,理想方案应自动判断何时压缩、保留哪些信息。这与记忆难题直接相关:保留和丢弃什么,决定了智能体能否胜任天、周、月级别的长期任务,也决定了它会不会忘掉关键约束。
Gemini 模型实测:视觉与主动性突出
模型评测环节对 Gemini 的最新版本做了演示。用同一个"哈姆雷特独白"SVG 生成提示词对比,Gemini 版本不仅生成了带侧边栏、情绪节拍注释和背景音效的完整舞台,还提供了面部表情和手势的滑块调节面板——眉间皱纹、眼泪反光都能调。
播客嘉宾的评价是:在推理和创意输出上,Gemini 与 GPT-6、Opus 5.5 等前沿模型已经很难区分。一个有趣的观察是,Gemini 倾向于回到"何以为人"的叙事,这可能是微调或强化学习带来的特征。另一个亮点是它非常主动地为用户构建 UI 小部件和流程图,呼应了"界面不应只是文本"的观点。
在二阶、三阶效应的问题上,Gemini 给出了一些有意思的预测:代码评审将被多智能体对抗性测试框架取代;知识工作会出现"飞行模拟器";以及"高能动性异类"将迎来黄金时代。
语音克隆恶作剧:vibe coding 的安全边界
本期最出人意料的环节是 Rahul 的"神秘 vibe intel"——他用开源工具搭建了一套实时语音克隆管线,在直播中用自己的声音"变成"了 Dan。流程包括:从播客音频中分离各人声线、用内容编码器提取身份特征、音高偏移约六个半音、再用声码器合成,最后通过 BlackHole 虚拟音频设备把输出直接送入播客录制软件。
Rahul 说他在 Google Meet 上测试时,妻子表示"听起来就像 Dan"。播客嘉宾指出,这套管线全部是 vibe coding 拼出来的,没有用现成的一体化应用——"这既令人兴奋,也有点吓人"。讨论中提到的防御措施包括:与家人预设暗语、对可疑语音请求进行二次电话确认。
AI 泡沫时钟:6 万亿美元营收缺口与基础设施焦虑
节目尾声的"距午夜两分钟"环节(用《原子科学家公报》的末日时钟隐喻 AI 泡沫破裂)继续停留在 4 分 15 秒。本期讨论的两个财务信号值得关注。
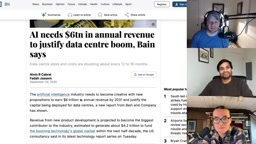
其一是 Bain Capital 的数据:AI 需要每年 6 万亿美元的营收才能支撑当前的数据中心建设热潮。主持人解读图表后认为实际缺口约为 4.2 万亿美元。同时,最大的单体 AI 数据中心规模预计从 2025 年的 0.6 吉瓦(约 240 亿美元建造)增长到 2030 年的 9 吉瓦(约 2000 亿美元)。播客对电力供应能否跟上表示怀疑,并调侃"太空数据中心"的设想。
其二是 OpenAI 的营收预期修正。TechCrunch 报道称,OpenAI 向投资者透露的年化营收接近 500 亿美元,而非此前传出的 700 亿美元,差距达 200 亿美元。播客指出,OpenAI 与 Anthropic 计算营收的方式不同:Anthropic 会把通过 Google Cloud、AWS 等平台服务的模型收入计入,OpenAI 则不计入第三方托管收入。最终一切要等实际财务报表出炉才能见分晓。
另一个被提及的信号是 Character.ai 申请破产。这家 2022 年成立一年即成为独角兽的聊天机器人平台,在被 Google 以 24 亿美元 acquihire 后,创始人 Noam Shazeer reportedly 套现 7.5 亿至 10 亿美元,随后于 2026 年离开加入 OpenAI,公司最终以 2000 万美元出售资产给迪士尼并破产。这或许会影响市场对现有 AI 独角兽的估值逻辑。
软件工程的下一步:从写代码到经营软件工厂
回到核心话题:代码更多但软件没更多,这个问题会如何演化?播客嘉宾提出了几个判断。
短期看,代码评审瓶颈正在被积极解决,多智能体对抗性评审是方向之一。中期看,如果评审不再是瓶颈,下一个挑战是运营成千上万份高度定制化的软件实例——"软件工厂"的运维负担可能需要靠堆 token 来解决。长期看,软件工程师的工作会从"翻译业务需求为代码"转向判断该构建什么、如何维护、如何经营工厂本身。
播客里有一段对话值得记下:一位嘉宾说,很多开发工作本质上是"把业务需求翻译成代码",不是计算机科学研究;另一位回应,理解底层系统的人在解决非技术用户无法解决的问题上仍有优势,"但这个优势还能保持一年吗?也许六个月都不行。"
人的判断、创造性问题解决和人际信任,可能是更持久的价值。正如节目里一句半开玩笑的话:"总会有人愿意付钱找一个能接电话、对问题大吼一声的人。"
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。