AI编程总在猜?先定位原因再写代码

AI反复修复失败源于盲目猜测,应先诊断后治疗。
文章指出,AI写代码时反复修复失败的根本原因,是它在不知道错误根因的情况下不断猜测补丁,导致第九次尝试仍出现同样报错。视频给出的核心建议是:连续两次修复失败就停止让AI直接改代码,转而要求它粘贴完整错误信息后列出三种可能原因,并明确禁止写代码。这一提示词强制AI进入推理诊断模式,把软件调试中“先诊断后治疗”的原则迁移到人机协作中。作者称改用该方法后第十次尝试即修复成功,说明改变提问结构比更换模型更有效。
为什么AI总在“猜”修复?
让AI写代码时,你可能遇到过这样的场景:AI自信地说“这次应该可以了”,但运行后还是同样的报错。一次、两次、直到第九次,错误纹丝未动。YouTube上一条热门短视频用一个精辟的观察点破了这个问题:AI在不知道根本原因的情况下,一直在猜测修复方案。
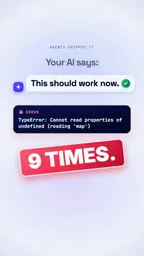
视频里展示了这样的画面:第一次尝试,同样的错误;第五次尝试,同样的错误;第九次尝试,同样的错误。这不是AI不够聪明,而是工作方式出了偏差。当模型缺乏对错误的深层理解时,它只能基于表面模式生成“看起来合理”的修改,而这些修改往往治标不治本。
LLM 的自回归生成机制是理解“猜测修复”现象的底层线索。大语言模型本质上是在给定上下文后,逐 token 预测最可能出现的下一个词。它并没有一个独立的“执行—观察—验证”回路,无法像人类工程师那样在脑中真正运行代码并观察运行结果。因此,当错误信息不充分或上下文缺失时,模型只能依据训练数据中见过的模式,生成统计上“看起来像修复”的代码片段。这种生成方式天然倾向于表面相似性,而非因果推理。要求模型“列出原因”之所以有效,是因为它把生成目标从“下一个补丁 token”转移到了“可能原因列表”,从而改变了模型内部的注意力分配和推理路径。
根因分析(Root Cause Analysis) 是软件工程中定位故障根本原因的系统化方法,常见手段包括阅读堆栈跟踪、二分排查、复现最小案例等。它与“猜测修复”的根本区别在于:前者先建立对故障机制的因果模型,再据此设计修改;后者则基于症状相似性直接生成补丁。AI 默认的交互模式容易滑向后者,因为生成补丁的反馈回路短、看起来进展快,但实际上可能在错误方向上反复迭代。视频建议的“先列三种原因”本质上是在对话层面强制插入一个根因分析阶段,弥补模型缺乏自主诊断习惯的缺陷。
停止无效循环:两次失败就改变策略
视频给出的建议非常直接:如果连续两次修复都失败,就停下来。
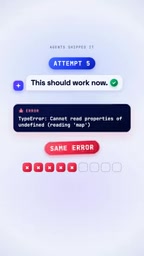
继续让AI盲目试错只会消耗时间和token,而且可能引入新的无关改动。此时应该切换模式——从“让AI直接改代码”转向“让AI先分析原因”。这个转折点是整条建议的核心:把AI从执行者变成诊断者。
一个关键提示词:先列原因,再写代码
具体怎么做?视频中给出的提示词是:
粘贴完整错误信息,然后要求:“列出三种可能的原因。暂时不要写任何代码。”
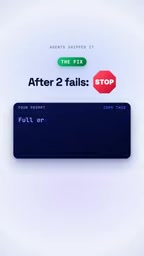
这个提示词的作用在于强制AI进入推理模式,而不是条件反射式地输出补丁。当模型被要求枚举原因时,它会把注意力集中在错误本身,分析堆栈、上下文和触发条件,从而更有可能触及真正的故障点。
视频作者表示,用这个方式后,第十次尝试就修好了。从“第九次还在猜”到“第十次解决”,差别不在于模型能力,而在于对话结构。
提示词工程中的“约束输出格式”技巧在这里起到了关键作用。明确要求“暂时不要写任何代码”,实际上是在抑制模型最擅长的补丁生成行为,迫使它把推理预算花在错误分析上。类似地,“列出三种可能原因”给出了一个具体的输出结构,避免模型泛泛而谈。这种做法的有效性来自一个事实:LLM 对指令中的否定约束和枚举要求相当敏感,输出格式的约束会显著改变其内部推理路径。实践中还可以进一步细化,例如要求按可能性排序、为每种原因附上验证方法,从而让诊断结果更具可操作性。
背后的工程思维
这个方法之所以有效,是因为它把软件调试中的经典原则迁移到了AI协作中:先诊断,后治疗。传统开发中,工程师看到报错会先读日志、定位根因,再动手修改;而AI的默认交互模式容易跳过这一步,直接生成代码。通过提示词强制“先列原因”,相当于给AI加了一道诊断工序。
另一个隐含的好处是:当AI列出三种可能原因后,你可以基于自己的领域知识快速判断哪一条最可信,再让AI针对那个方向深入。这比在九个错误补丁里大海捞针高效得多。
日常使用建议
- 连续两次修复失败后,立即停止让AI改代码
- 粘贴完整错误信息(包括堆栈和上下文),不要只给一句概括
- 要求AI先列出可能原因,明确说“不要写代码”
- 从原因列表中选定方向后,再让AI生成针对性修复
- 保留每次尝试的对话记录,便于回溯判断
这个方法不需要更换模型或工具,改变的是提问方式。对于日常用AI辅助编程的开发者来说,是一笔低成本、高回报的调整。
相关推荐

手机本地运行无审查AI:LFM3模型实测与指南
介绍如何在iPhone和Android手机上本地运行Liquid AI的LFM3 1.7B无审查模型,无需GPU和网络,包含On Device LLM与Layla应用的操作步骤、实测速度与隐私优势分析。

Claude上线协作表格与白板,Anthropic硬刚微软谷歌
Anthropic向付费用户推送Claude Sheets和Claude Whiteboards测试版,支持一句话生成带公式的表格、将口头计划整理成带时间线的协作白板。文章分析其能力边界、编辑可见设计,以及与微软谷歌的正面竞争。

一句话生成表格?Claude Sheets深度体验与避坑指南
Claude Sheets 测试版上手解析:一句话生成带公式和下拉菜单的协作表格,但 100,000 单元格上限与套餐用量限制可能比你想的更早成为瓶颈。附三个业务场景、合规限制与五步避坑清单。