AI编码代理的盲区:PR合并后为何失明?
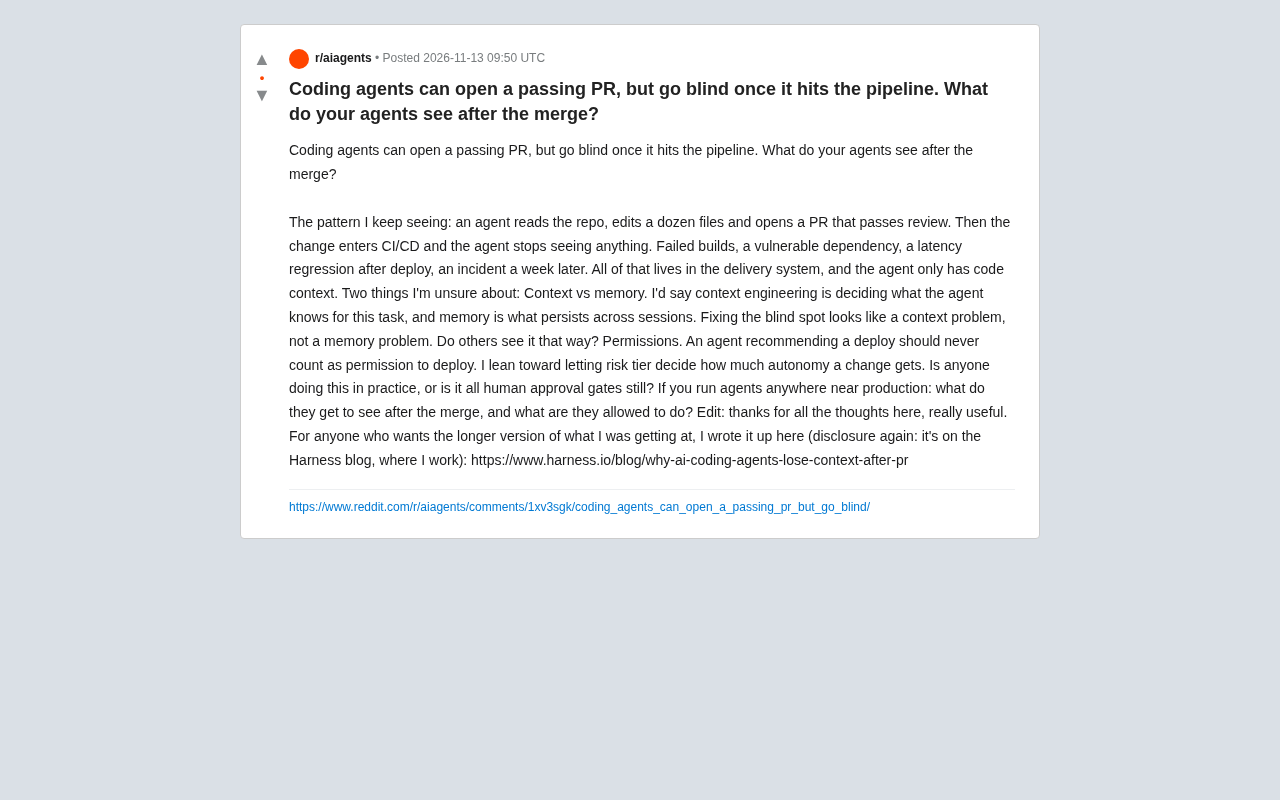
AI编码代理止步于PR,合并后的交付信号盲区需重构上下文与权限。
文章指出AI编码代理在代码层面表现出色,但感知边界止于PR合并,无法获取CI/CD失败、依赖漏洞、部署回归等交付系统信号,形成系统性盲区。作者讨论了两个核心问题:一是该盲区应归为上下文工程问题还是记忆问题,原帖倾向上下文,但存在分歧;二是代理的建议不应等同于部署权限,风险分级自治是潜在方向,但实践中人工审批仍是主流。多数团队的代理在合并后仅具备有限的只读可见性,未形成交付闭环。作者还披露了在Harness工作的背景,提示讨论带有商业立场。
AI编码代理能读懂仓库、修改十几个文件,并提交一个通过审查的PR。但一旦这个变更进入CI/CD流水线,代理就仿佛被蒙上了眼睛——构建失败、依赖漏洞、部署后的延迟回归、一周后才爆出的线上事故,这些关键信号全部存在于交付系统中,而代理只拥有代码上下文。
核心盲区:合并后的信号断裂
开发者们反复观察到同一种模式:代理在代码层面表现出色,却在交付层面完全失明。这不是偶发的工具缺陷,而是当前AI编码代理架构的系统性短板。代理的感知边界止于PR,而软件质量的真正考验恰恰始于合并之后。
这种断裂带来的直接后果是:代理无法从失败中学习,无法感知自己修改引入的运行时问题,也无法参与故障修复的闭环。它像一个只能看到棋盘前半局的棋手,后半局的胜负与它无关。
CI/CD(持续集成/持续交付)是一套自动化流水线:代码合并后自动触发构建、测试、依赖扫描和部署。它产生的关键信号包括构建日志、测试通过率、依赖漏洞告警(如CVE)、部署后的延迟/错误率等。对AI编码代理而言,这些信号通常通过CI平台的API或事件流暴露,但代理的默认工具集只覆盖代码仓库和PR状态,因此形成了“代码内感知、交付外失明”的架构性缺口。
上下文工程与记忆:该修哪个?
原帖作者提出了一个值得深究的区分:上下文工程决定代理在当前任务中“知道什么”,而记忆是跨会话持久保存的内容。他认为,修复合并后的盲区更像是一个上下文问题,而非记忆问题。
这个判断有道理。代理并不需要“记住”上一次部署的延迟数据,它需要的是在当下这个任务中,能够访问到交付系统暴露的实时信号。把CI/CD状态、部署健康指标、依赖漏洞告警纳入代理的上下文窗口,比让代理长期记忆这些数据更直接有效。
不过,多源讨论中也有观点认为两者并非互斥:上下文解决“此刻能看到什么”,记忆解决“下次是否还记得教训”。如果代理在本次部署中发现了某个配置项的危险性,跨会话保留这一认知显然也有价值。原帖作者倾向于将其归为上下文问题,这一立场在评论区获得了一定认同,但并非共识。
上下文工程(context engineering)指在单次任务中,为模型精心选择、组织并注入相关信息(如文件内容、工具输出、系统状态),以提升当前决策质量;记忆(memory)则指跨会话持久化存储的知识,如用户偏好、历史教训。两者的关键区别在于时间尺度:上下文解决“此刻能看到什么”,记忆解决“下次是否还记得”。在代理架构中,上下文通常由提示组装和工具调用结果动态填充,而记忆依赖外部存储与检索机制。
权限边界:建议部署不等于有权部署
帖子中的第二个疑问关乎权限设计。作者的态度很明确:代理推荐一次部署,绝不应被等同于授予了部署权限。他倾向于用风险分级来决定一个变更获得多少自主权。
现实情况是,多数团队仍停留在人工审批卡点阶段。评论区反馈显示,风险分级自治在实践中并不普遍。这背后有合理的谨慎:交付系统的操作后果比代码编辑更难回滚,一次错误的部署可能影响真实用户。
但人工卡点也有代价——它把代理排除在交付闭环之外,代理永远学不会为自己的建议负责。风险分级提供了一条中间路径:低风险变更(如文档更新、非关键路径的依赖补丁)可以给予更高自主权,高风险变更保留人工确认。关键在于分级标准是否透明、可审计。
风险分级自治(risk-tiered autonomy)是一种权限设计模式:根据变更的风险等级动态授予代理不同的自主权。低风险变更(如文档修改、非关键路径的依赖补丁)可允许代理自动执行部署或回滚;高风险变更(如核心服务配置、数据库迁移)则保留人工审批。该模式的关键在于分级标准必须透明、可审计,并能随环境变化调整,否则可能沦为形式。
实践现状:代理在合并后能看到什么?
原帖向运行代理的团队提出了一个直接的问题:合并之后,代理能看到什么,又被允许做什么?从讨论来看,答案普遍保守。多数代理的可见范围仍局限于代码仓库和PR状态,交付系统的信号要么未接入,要么仅以人工通报的形式间接到达。
少数团队尝试将CI失败日志、部署健康检查结果回灌给代理,但往往停留在只读层面——代理可以“看到”问题,却无权触发重试、回滚或修复流程。这种“只读可见”已经比完全失明进了一步,但仍未形成闭环。
作者在更新中补充,他在Harness博客上写了更长版本的分析(并披露了自己在该公司工作)。这一披露值得注意:讨论虽由实践观察引发,但背后有商业产品的立场。
结语
AI编码代理的能力边界正在从“能否写出可用的代码”转向“能否对交付结果负责”。合并后的盲区不是靠更强的代码生成能力能解决的,它需要重新设计代理的上下文来源和权限模型。风险分级自治是否可行、上下文与记忆如何分工,这些问题目前没有标准答案,但把它们摆上台面讨论,本身就是必要的一步。
相关推荐

本地AI入门:Inkling、Qwen与Unsloth实战指南
面向初学者的本地AI实践指南,解析Inkling、Qwen与Unsloth在本地大模型部署与微调中的角色,涵盖模型选型、量化推理、轻量微调流程,以及本地与云端方案的取舍建议。

开放社交网络联盟成立:去中心化社交的新起点
Open Social Web Alliance 开放社交网络联盟亮相,引发 Hacker News 热议。本文梳理联盟的定位、社区讨论中的核心分歧,以及开放社交网络在互操作、内容治理和身份迁移上面临的现实挑战。
别用Rust重写,只优化那5%的慢代码
Fast-Anything 项目主张不要用 Rust 全量重写项目,而是先定位真正拖慢性能的 5% 热点代码再做定向优化。本文解读其核心思路、社区争议与工程实践启示。