#上下文工程
共 58 篇相关文章

前沿模型没有变聪明?一线开发者质疑「原始智能」进步被高估
一位资深开发者提出反直觉观点:前沿大模型变得更实用,但原始智能提升被高估。他从生产harness、软件工程和本地小模型三类实践出发,认为过去一两年的进步主要来自累积改良与更好的工程封装,而非指数级智能跃迁。
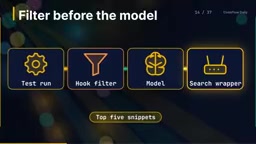
Claude上下文窗口与提示缓存:成本优化实战指南
深入拆解Claude上下文窗口与提示缓存的成本机制:缓存断点、失效条件、TTL选择、上下文编辑与压缩的分工、技能渐进式披露,以及缓存反超不缓存的真实案例与架构决策框架。
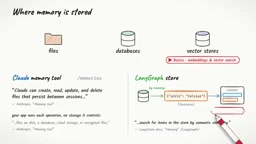
AI Agent记忆机制:短期与长期记忆详解
深入解析AI Agent记忆机制:短期记忆跟踪单次会话消息历史,长期记忆跨会话存储语义、情景与程序记忆。了解Claude记忆工具、LangGraph存储方案及检索如何像RAG一样工作。

一张白板讲透多智能体系统:架构、成本与三大教训
一张白板讲清多智能体系统:为什么需要多个智能体、主智能体与子智能体的接线方式、4倍与15倍的token成本、三条工程教训,以及 agents as tools 与 handoffs 两种交接模式。

MCP服务器最大隐患:连接工具不等于理解业务
MCP让AI Agent轻松连接企业工具,却带来工具过载和语义缺失两大隐患。本文解析为何MCP只负责连接不负责理解业务,以及如何通过上下文层标准化指标、统一实体、约束执行,构建可靠的Agent自动化。
手写Agents.md,让AI编程稳定性大幅提升
B站UP主通过视频编辑器和卡牌游戏两个项目对比,揭示手写Agents.md和设计文档能显著提升AI编程稳定性,解释Agents.md与技能注入机制的区别,并给出文档驱动开发的实用方法。

Anthropic团队拆解上下文工程:从Claude MD到文件系统记忆
Anthropic团队在AI DevCon分享上下文工程演进:从Claude MD文件到Agent自主文件系统记忆,详解版本控制、哈希并发、权限分层与Dreaming会话外记忆流程,并给出生产环境落地的渐进路径。

上下文工程现状:从提示词到上下文管理的范式演进
基于 dbreunig 文章与 Hacker News 讨论,梳理上下文工程的概念边界、当前实践模式与开放问题,解析其与提示词工程的本质差异。
多Agent交接的边界:该给什么,该藏什么?
多Agent工作流中,交接该给多少上下文?本文拆解Reddit开发者的一线经验:给Coder原子spec加目标文件是否足够、给Reviewer为何必须带spec、切片太窄时如何用命名依赖请求有界摘录,并提炼一条可操作的交接判断规则。
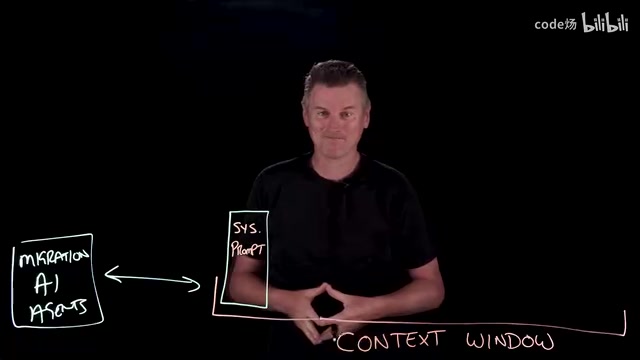
上下文越大AI智能体越不可靠?4种失效模式与修复方法
一项覆盖18个前沿模型的研究发现:上下文窗口越大,AI智能体可靠性反而下降。本文解析上下文腐化的四种失效模式——污染、分心、混乱、冲突,并给出验证、压缩、筛选、清理四种修复方法,说明为什么主动丢弃信息能让智能体更可靠。

渐进式披露让Agent提速2.3倍:上下文工程新思路
Hacker News讨论提出用渐进式披露优化AI Agent上下文,实现2.3倍提速。本文解析上下文膨胀的三大性能损耗,介绍分层工具目录、按需检索、历史压缩等实践路径及落地注意事项。

告别上下文大杂烩:多智能体管道如何严格界定状态与交接
多智能体管道中上下文大杂烩导致状态膨胀和交接模糊。本文基于Reddit讨论,总结显式输入输出模式、不可变状态、分层状态等严格界定状态与交接的工程实践,并分析交接协议设计中的关键取舍。

如何在智能体开发中榨取最大智力?HN热议
Hacker News 热议如何从 AI 智能体中获取最大智力。本文从上下文质量、工具设计、评估迭代和多智能体协作四个维度,拆解提升智能体表现的关键实践,帮助开发者突破智能体“差一口气”的瓶颈。
AI编程代理看不到的7件事,每条命令补齐上下文
AI编程代理只能看到仓库文件和你输入的文字,CI日志、issue线程、PR行内评论、线上schema、运行时日志、功能开关状态和浏览器控制台都在它视野之外。本文给出七条命令,逐一将这些隐藏状态转为代理可读的文本,并说明如何用.context/目录与CLAUDE.md让上下文跨会话保留。

《Context Engineering》新书发布:AI系统失败往往因为上下文
新书《Context Engineering》指出AI系统失败多因上下文而非模型。文章解读上下文漂移、知识图谱检索、决策可审查性等核心观点,为技术领导者提供AI生产落地的工程框架。

端侧AI Agent如何解决"手机本该知道"的上下文传递难题
StareBrain团队详解端侧AI Agent的上下文传递架构:如何在不将数据上传云端的前提下,用本地解析层自动补全位置、时间、联系人等参数,并通过置信度分级决定自动填充、建议还是询问用户。

实测:Skill文件超过6KB,模型输出失败率翻倍
实测 28 次执行发现:skill 文件超过 6KB 后,模型空输出率达到 25%,自然膨胀的 9.2KB 文件更是高达 50%。本文拆解实验数据、约 1500 token 的机制解释,以及把 skill 文件压在 6KB 以下的三条实操规则。
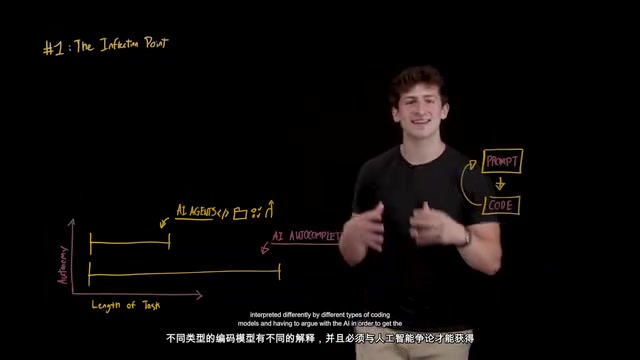
AI写代码必懂的5个核心概念:从自动补全到智能体编排
IBM Technology 讲解 AI 编程智能体必懂的 5 个概念:开发拐点、从实现到指挥的角色迁移、上下文与循环工程、LLM 原理与显存机制、提示注入与沙箱安全,并展望 AI 作为新电力的未来。

