AI测试岗新方向:大模型评估与智能体实战入门

AI测试从“用AI测试”转向“对AI测试”,需评估大模型、知识库和智能体三层能力,用分数替代断言。
文章指出,传统软件测试的断言逻辑在AI场景下失效,因为大模型输出介于对错之间,需用分数衡量质量,这正是“评估”取代“测试”的原因。AI测试对象分为三层:大模型(基础能力)、知识库/RAG(规则驱动)、智能体(执行闭环),评估重点各有不同。实战入门需准备Python、Node环境和OpenAI兼容的大模型接口。文章还提供了评估方法论和思维导图,为想切入AI测试岗的开发者指明路径。
传统的软件测试靠断言判定对错,但面对大模型,这种非黑即白的逻辑失效了。AI的输出往往介于对错之间,需要用分数来衡量质量——这正是"评估"取代"测试"的原因。B站一场技术直播中,讲师系统梳理了AI评估的三大对象与实战路径,为想切入AI测试岗的开发者提供了一条清晰的入门路线。
从"用AI测试"到"对AI测试":测试角色的根本转变
讲师回顾了此前讨论过的三种结合方式:用AI测试(AI作为助手)、让AI测试(AI作为主角执行测试)、以及对AI测试(AI成为被测对象)。前两者仍是测试传统软件,只是引入了AI工具;而第三种,测试人员与AI站到了对手席上——被测系统本身就是AI。
这一转变并非纸上谈兵。中国移动、中国电信等国企APP已内置AI能力,腾讯、DeepSeek广告等厂商也在推出AI原生软件。即便纯手工测试人员,也无法回避对AI功能的验证。据讲师观察,2B软件后端普遍接入智能体或智能客服,对这类系统的测试需求正在快速增长。
三大评估对象:大模型、知识库与智能体
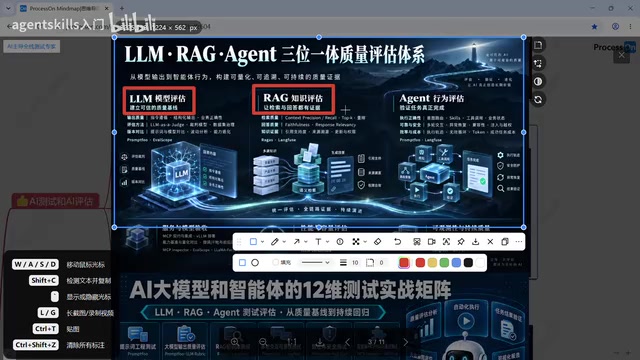
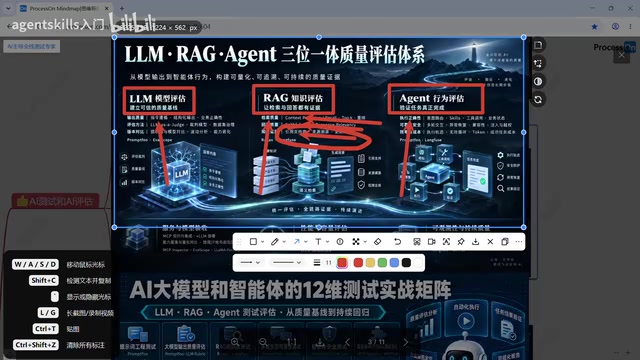
讲师将AI评估的目标拆解为递进的三层:
大模型(LLM):基础能力评估
接入大模型即可获得聊天等基础AI能力,门槛较低。但仅靠大模型无法处理具体业务规则。讲师以拼多多的AI聊天功能为例——通讯录式的大量AI角色陪聊体验惊艳,但功能下线后留下的问题是:没有业务规则支撑,AI无法完成退款、售后等实际任务。
知识库(RAG):规则驱动的能力跃升
RAG(检索增强生成)为AI提供确切的业务依据。讲师用生鲜退款的例子说明:冻鱼到货后部分化冻,该退全款还是按比例退款?答案取决于知识库中的生鲜售后规则。评估RAG需关注三个环节——检索质量、生成质量、以及结论是否有确切依据。
RAG(检索增强生成,Retrieval-Augmented Generation) 是一种将外部知识检索与大模型生成相结合的技术架构。其基本流程是:当用户提出问题时,系统先在知识库(如文档、数据库、FAQ)中检索出与问题最相关的片段,再把这些片段作为上下文,与用户问题一起送入大模型,让模型基于这些确切的资料来生成回答。这样既弥补了大模型参数中固化的知识可能过时或缺失的问题,又让回答有据可查,显著降低“幻觉”概率。评估RAG系统时,检索环节关注召回率、精确率与排序质量;生成环节关注答案是否忠实于检索到的内容、是否完整回答了问题、语言是否通顺。
智能体(Agent):从"说"到"做"的闭环
知识库让AI能说清楚该退多少,但真正发起退款、完成资金流转,需要智能体执行动作。评估重点随之转移:动作是否执行、执行是否正确、是否完整、有无额外偏差。讲师强调,即便知识依据无误,执行环节仍可能出错——该退三分之一的退了全款,就需要通过评估发现。
实战准备:Python、Node与大模型接口
入门实操需要三样东西:Python环境、Node环境、以及一个大模型API接口。安装包获取简单,双击运行即可。讲师提醒,目前基本没有免费的大模型接口,工作中通常由公司提供;个人练手可选DeepSeek,一元起充。
接口要求方面,OpenAI兼容是事实标准。国内主流模型——阿里、MiniMax、智谱、DeepSeek——均兼容该协议,因此这一条件在国内场景下自动满足。
OpenAI兼容接口 是指遵循OpenAI API(如Chat Completions接口)的请求与响应格式的API规范。由于OpenAI在该领域的广泛影响力,其接口格式已成为事实标准。国内主流大模型厂商(如阿里通义、MiniMax、智谱、DeepSeek等)均提供了兼容OpenAI的API端点,开发者只需替换base_url和api_key,即可用相同的代码调用不同模型。这极大降低了评估工具的开发与迁移成本,也使得基于OpenAI生态的评估框架(如LangChain、LlamaIndex等)能够无缝对接国内模型。对于测试人员而言,这意味着一次编写的评估脚本可以灵活切换被测模型,方便进行横向对比。
评估方法论:为什么分数比断言更合适
AI系统的输出难以简单判定对错,评估通过分数表达质量区间。这一术语区分并非文字游戏——传统软件的断言逻辑在AI场景下失效,需要建立新的质量度量体系。讲师提供了一份思维导图,涵盖评估对象、工具方法与场景案例,可作为学习路线的参考框架。
从大模型到知识库再到智能体,三层能力递进对应三类评估重点。对于想进入AI测试岗的开发者,这条路径比盲目自学更具体:先理解每层能力的原理,再结合工具在真实场景中完成评估实践。
断言(Assertion) 是传统软件测试中的基本判定手段,通常以“预期结果是否等于实际结果”或“是否满足某条件”的形式出现,输出为布尔值(通过/失败)。然而,大模型的输出是自然语言文本,具有多样性、模糊性和上下文依赖性,同一问题可能有多种合理回答,很难用简单的相等判断来界定对错。因此,评估转而采用评分机制,如人工评分、基于规则的打分、或使用另一个大模型作为“裁判”进行自动评分(LLM-as-a-judge)。评分可以是连续值或分级标签,能够表达“部分正确”“基本可用”“有轻微偏差”等中间状态,更贴合AI系统的实际质量分布。
背景补充
智能体(Agent) 指能够感知环境、自主规划并执行动作以完成特定目标的大模型应用形态。与单纯的聊天模型不同,智能体通常具备工具调用(如调用支付接口、查询数据库)、任务分解、多步推理等能力。它把大模型的“语言理解”转化为“可执行的操作”,从而完成退款、下单、售后等闭操作。评估智能体时,除了关注最终结果是否正确,还要关注其动作序列是否合理、是否有冗余或遗漏步骤、是否在异常情况下能正确回退或求助。这与传统API测试中的功能验证有相似之处,但智能体的非确定性使得评估需要更关注整体行为质量而非单一返回值。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。