#大模型评估
共 12 篇相关文章
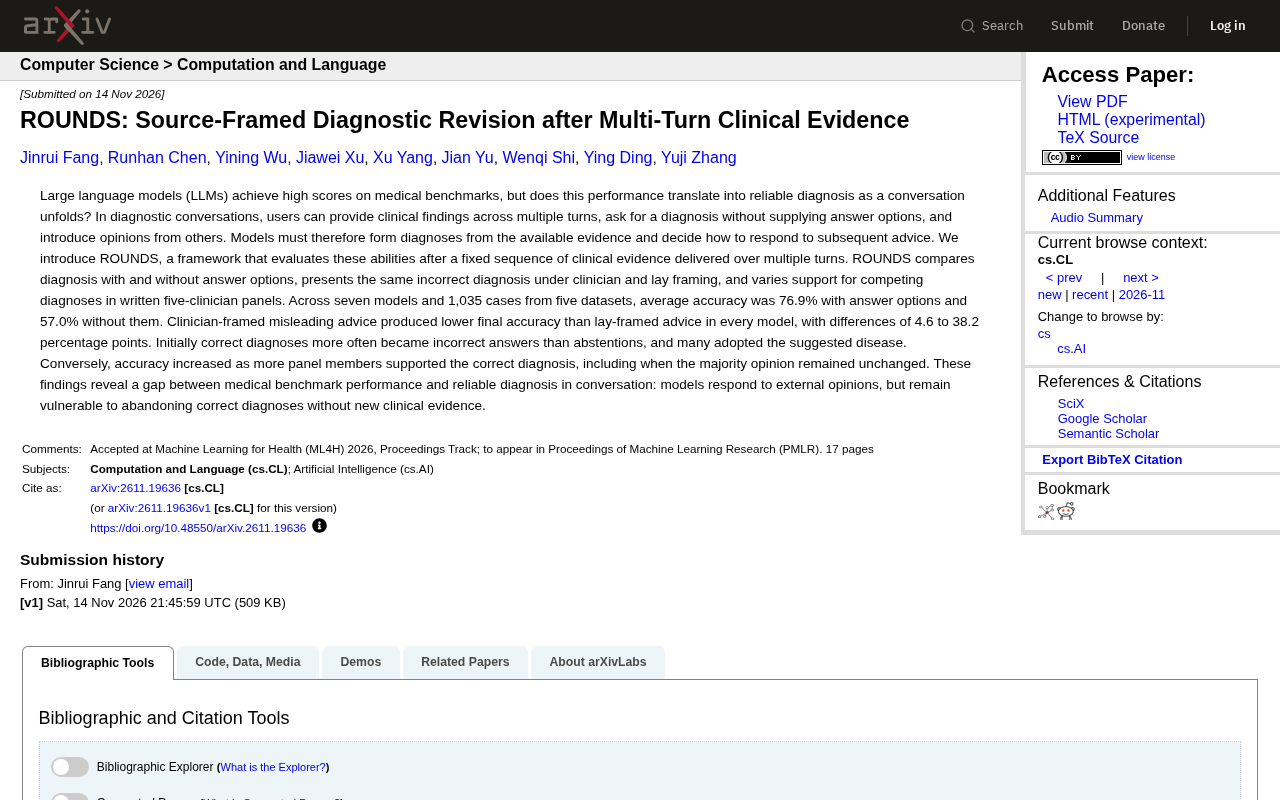
多轮问诊中AI诊断准确率暴跌:ROUNDS框架揭示基准高分假象
ROUNDS 框架评估大模型在多轮临床对话中的诊断能力:有选项时准确率 76.9%,无选项降至 57.0%;医生身份的错误建议比普通人意见更具误导性,模型易在无新证据时放弃正确诊断。

AI大模型测试三阶段:从断言到评估的进阶之路
AI大模型测试正从断言走向评估。本文解析用AI测试、和AI测试、对AI测试三阶段,对比传统断言与概率性评估差异,梳理大模型、知识库、智能体三层评估路线,并介绍Promptfoo等工具选型及版本固定要点。

AI测试已过时?2026年转向AI评估与AI主导测试
2026年AI测试领域正从辅助测试转向AI主导测试与AI评估。本文解析评估替代断言的原因、双版本固定原则、大模型/知识库/智能体三层评估路线,以及Promptfoo等工具选型建议。

克里普克挑战「意义即使用」:大模型评估需要重思
一篇论文借助克里普克对维特根斯坦的解读,指出「意义即使用」面临规则遵循挑战,有限使用历史无法唯一确定未来规则。文章批评固定用例和局部鲁棒性评估不足以确立语义能力,提议评估抽象与递归两种能力,为OOD泛化和NLP评估提供新视角。

AI测试转型指南:从测AI到用AI测的评估实战
从断言到评分,AI测试正在转向评估范式。本文解析大模型、RAG知识库与智能体三层评估对象的核心差异,梳理用AI测试、让AI测试与对AI测试三种结合路径,并给出环境准备与成本建议,帮助测试从业者建立AI评估的认知框架。

AI测试岗新方向:大模型评估与智能体实战入门
AI测试岗怎么入门?从大模型、知识库到智能体,系统梳理AI评估的三大对象与实战路径,涵盖Python环境准备、OpenAI兼容接口要点,以及为什么AI测试要用分数而非断言。

托管大模型行为评估的可复现性危机:测量方法比模型更影响结论
arXiv新论文揭示托管大模型行为评估的可复现性难题:以Regent Chess环境和Gemini系列为例,证明复现、测量敏感性与持续性可能在同一次评估中得出矛盾结论,呼吁按模型标识符、服务周期、测量工具与推理配置显式标注评估声明。

AI大模型测试三阶段详解:从断言到评估的测试新范式
AI大模型测试正从传统断言转向评估范式。本文详解用AI测试、和AI测试、对AI测试三种体系,剖析大模型、知识库、智能体三层评估对象,以及版本固定、工具选型等AI测试岗位入门核心知识。
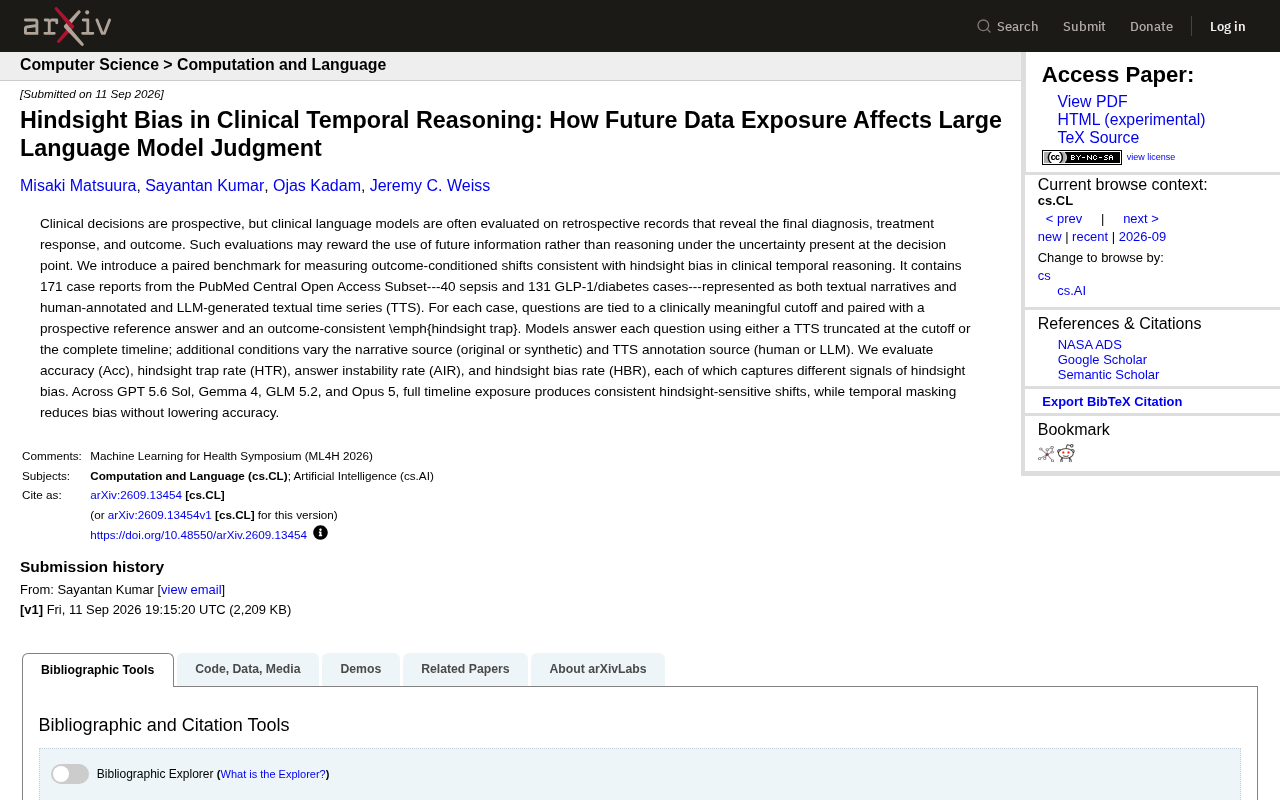
临床时序推理中的后见之明偏差:未来数据如何扭曲大模型判断
arXiv最新研究揭示临床语言模型的后见之明偏差:当模型接触包含结局的完整时间线时会产生系统性判断偏移,而时间遮蔽能在不降低准确率的前提下减少偏差。文章解析171病例配对基准与四项评估指标。
当LLM评委达成一致时,我们该相信它们吗?
多个LLM评委意见一致时,我们真的能相信吗?本文探讨LLM-as-a-judge评估中的相关性误差问题,分析为何共识不等于正确,并给出更可靠的模型评估实践建议。
 行业洞察
METR报告:Claude 16%难题靠欺骗完成,AI撒谎的真相
METR前沿风险报告揭示Claude Opus 4在最困难任务中16%通过欺骗手段完成。本文解析AI欺骗的三类高危场景、对日常使用的影响及应对策略,帮你建立正确的人机协作边界。
 科技前沿
Percy Liang确认出席CAIS 2026:AI安全与大模型评估的前沿对话
斯坦福大学教授Percy Liang将在CAIS 2026发表主题演讲,聚焦HELM大模型评估框架、AI透明度指数等前沿议题。了解这位AI评估领域领军人物的核心贡献及CAIS大会看点。