AI产品界面重复标签失误:细节质量为何不容忽视

一个引发热议的界面小失误
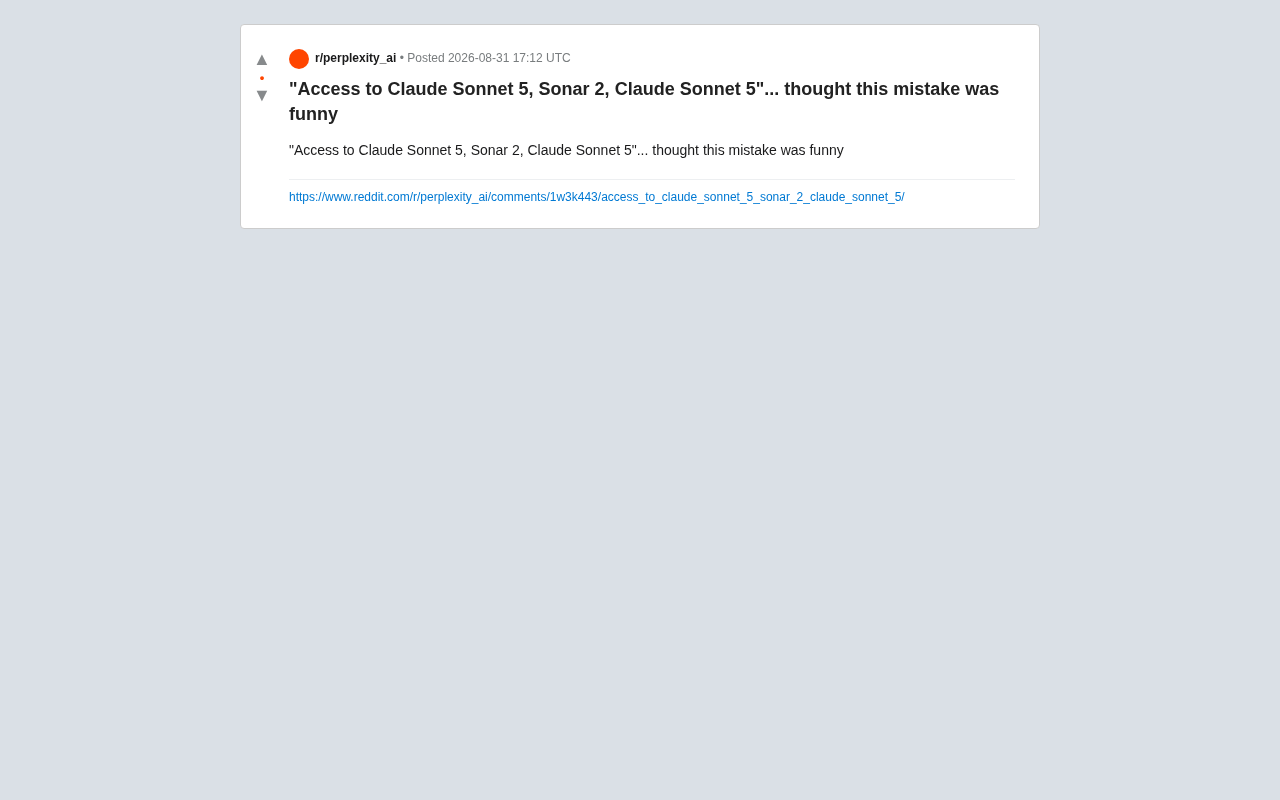
近日,Reddit社区中一位用户分享了一张产品界面截图,迅速引发讨论。截图中,某AI产品的模型访问权限列表出现了明显的重复:"Access to Claude Sonnet 5, Sonar 2, Claude Sonnet 5"——同一个模型名称 Claude Sonnet 5 竟然被列出了两次。
这位用户在帖子中调侃道:"thought this mistake was funny"(觉得这个错误挺有意思的)。虽然只是一处看似微不足道的文案重复,但它却折射出当下AI产品在快速迭代过程中普遍存在的质量把控问题。
重复标签为什么会出现?
AI产品的高速迭代压力
在生成式AI爆发的当下,各大平台几乎每隔几周就要接入新模型、更新订阅方案或调整权限说明。以模型接入类产品为例,它们往往需要同时集成来自Anthropic(Claude系列)、OpenAI以及自研搜索模型(如Sonar)等多家厂商的能力。
这里值得展开说明的是,这些被集成的模型各自有着截然不同的技术特征和接口规范。Claude Sonnet 5 是 Anthropic 公司推出的大语言模型,属于 Claude 系列的中端均衡型产品。Anthropic 的模型命名采用三层体系:Haiku(轻量快速)、Sonnet(均衡型)和 Opus(旗舰型),分别对应不同的性能与成本权衡。这种分层设计使得开发者可以根据具体应用场景——从低延迟的实时聊天到需要深度推理的复杂任务——选择最合适的模型层级。Sonnet 作为中间档,通常在响应质量和推理速度之间取得较好的平衡,因此也是被第三方平台集成最多的版本之一。Anthropic 本身是由 OpenAI 前高管 Dario Amodei 和 Daniela Amodei 于2021年创立的AI安全公司,其核心研究方向是"宪法AI"(Constitutional AI)——一种通过让模型自我批评和修正来对齐人类价值观的训练方法,这使得 Claude 系列在安全性和可控性方面形成了独特的技术优势。
而 Sonar 是 Perplexity 推出的搜索增强型模型,其核心特点是将实时网络检索能力与大语言模型的生成能力深度融合,能够在回答中引用最新的网络信息源——这与 Claude 这类纯生成式模型有着本质区别。传统的大语言模型受限于训练数据的截止日期,无法获取最新信息,而 Sonar 通过检索增强生成(Retrieval-Augmented Generation, RAG)架构解决了这一问题。RAG 的基本原理是在模型生成回答之前,先从外部知识库或互联网中检索与用户查询相关的文档片段,再将这些片段作为上下文注入到模型的提示中,从而生成既准确又时效性强的回答。这一架构最早由 Meta AI(原 Facebook AI Research)的研究团队在2020年的论文中系统提出,此后迅速成为解决大语言模型"幻觉"问题和知识时效性问题的主流方案。在实际实现中,RAG 系统通常包含三个关键组件:查询理解模块(将用户问题转化为检索查询)、检索引擎(从向量数据库或搜索引擎中召回相关文档)、以及生成模块(将检索结果与原始问题合并后送入大语言模型生成最终回答)。这种架构在需要事实核查、新闻摘要、学术研究等场景中具有显著优势。
不同厂商的模型在认证方式、API 接口规范、速率限制、上下文窗口大小等方面都存在显著差异,这种多源异构的集成场景使得模型元数据的管理变得格外复杂。例如,Claude 系列的上下文窗口可达 200K tokens,而某些模型可能仅支持 8K 或 32K tokens;不同模型的计费单位(按 token 数、按请求数、按订阅包)也各不相同。这里的"token"是大语言模型处理文本的基本单位,它并不完全等同于一个单词或字符——在英文中一个 token 大约对应4个字符或0.75个单词,而在中文中一个汉字通常会被编码为1-3个 tokens,具体取决于模型使用的分词算法(如 BPE、SentencePiece 等)。上下文窗口的大小直接决定了模型在单次对话中能"记住"多少信息,200K tokens 的窗口意味着模型可以一次性处理相当于一本中等长度小说的文本量,这对于长文档分析、多轮对话等应用场景至关重要。任何一次模型版本升级或新模型接入,都可能涉及前端展示、后端路由、权限控制、计费系统等多个子系统的联动更新,稍有疏忽就可能出现数据不一致的情况。
在这样密集的更新节奏下,产品团队常常依赖手工维护配置列表或文案模板。当一个新模型上线、旧模型下架,或者版本号发生变化时,就很容易出现复制粘贴错误——比如把同一个条目误填两次,正如这次的"Claude Sonnet 5"重复现象。
配置驱动 vs 硬编码的差异
从技术角度看,这类重复问题通常源于配置管理不够规范。如果模型列表是硬编码在前端界面中,而非从统一的后端配置或数据源动态生成,那么人为编辑时的手误就难以被自动发现。相反,如果采用配置驱动 + 去重校验的方式,这类低级错误本可以在构建阶段就被拦截。
配置驱动(Configuration-driven)是一种在现代软件工程中被广泛采用的架构范式,其核心思想是将业务逻辑中频繁变化的部分——如模型列表、功能开关、权限定义——抽离到外部配置文件或数据库中,而非直接写死在源代码里。这种思想的起源可以追溯到"关注点分离"(Separation of Concerns)原则和"十二要素应用"(Twelve-Factor App)方法论,后者明确提出应用的配置应存储在环境中而非代码中。"十二要素应用"由 Heroku 联合创始人 Adam Wiggins 于2011年提出,最初是为了总结构建现代 SaaS 应用的最佳实践,其中第三条"Config"(配置)原则指出:配置在不同部署环境之间会有显著差异,因此不应被硬编码在代码中,而应通过环境变量或外部配置服务来管理。这一原则后来成为云原生应用开发的基础共识之一。在实际工程实践中,常见的配置管理工具包括 HashiCorp Consul(提供服务发现与配置共享,支持多数据中心的分布式架构)、Spring Cloud Config(适用于 Java 生态的分布式配置中心,支持 Git 作为配置存储后端)、etcd(Kubernetes 生态中的分布式键值存储,是 Kubernetes 控制平面的核心组件之一),以及各大云平台提供的托管配置服务,如 AWS AppConfig(支持渐进式配置部署和自动回滚)、Azure App Configuration 等。
采用配置驱动的好处在于,更新配置无需重新编译和部署代码,同时可以在配置层统一施加校验规则(如唯一性约束、格式检查、枚举值白名单),从架构层面杜绝人为手误传播到生产环境。更进一步,许多配置中心还支持配置变更的审计日志和版本回滚,这意味着即使某次配置更新引入了错误,团队也能迅速定位变更者和变更时间,并一键恢复到正确版本。这种版本化配置管理的理念与 GitOps 运动一脉相承——GitOps 主张以 Git 仓库作为系统期望状态的唯一真实来源(Single Source of Truth),所有对系统的变更都必须通过 Git 提交来触发,从而天然获得完整的变更历史、代码审查和回滚能力。对于需要频繁增删模型的AI平台而言,这种架构选择的重要性不言而喻——它将"人记住不要犯错"的软性要求转化为"系统不允许犯错"的硬性约束。
小失误背后的大启示
细节决定用户信任
对于AI产品而言,用户对"智能"的期待极高。一个界面上连模型名称都会重复出现的产品,难免让人对其整体严谨性产生疑虑——如果连静态文案都没校对好,那么核心的模型调用、计费逻辑是否也存在类似隐患?
这种心理机制在行为科学中有一个经典的类比——"破窗效应"(Broken Windows Theory)。该理论最初由犯罪学家James Q. Wilson和George L. Kelling于1982年在《大西洋月刊》(The Atlantic)上发表的文章中提出,指出如果一栋建筑的一扇窗户破了却不修理,人们就会倾向于认为整栋建筑缺乏管理,进而引发更多的破坏行为。这一理论在1990年代被纽约市警察局长William Bratton采纳并应用于城市治安管理,取得了引人注目的效果。在软件产品领域,这一效应同样适用:用户在界面上发现的每一个小错误——无论是拼写失误、布局错位还是重复条目——都会累积成对产品整体可靠性的怀疑。认知心理学中的"光环效应"(Halo Effect)也解释了类似现象:人们倾向于根据对事物某一方面的印象来推断其整体特质。如果用户在界面上感知到了"粗糙",这种印象会不自觉地蔓延到他们对产品技术能力、数据安全性甚至公司管理水平的整体评价上。对于AI产品尤为如此,因为用户本质上是在将自己的决策、创作甚至隐私数据托付给一个"黑箱"系统,而他们判断这个黑箱是否值得信赖的依据,往往就是那些能直接看见和感知到的外在细节。
虽然这次只是一个无伤大雅的展示错误,但它提醒所有产品团队:在追求功能上新的同时,基础质量的把控同样重要。用户对产品的信任,往往就建立在这些看似不起眼的细节之上。
AI产品团队值得借鉴的实践
对于正在构建AI应用的开发者和团队,这个案例提供了几点实用启示:
-
动态生成而非手工维护:模型和功能列表应尽量从统一数据源自动渲染,减少人工编辑环节。具体而言,可以在后端维护一张模型注册表(Model Registry),前端页面在渲染时通过 API 动态拉取当前可用的模型列表,而非将模型名称硬编码在 HTML 模板或前端组件中。Model Registry 的概念在机器学习工程(MLOps)领域已被广泛采用,MLflow(由 Databricks 开源,已成为 MLOps 领域的事实标准之一)、Weights & Biases(专注于实验追踪和模型版本管理)等平台都提供了成熟的模型注册与版本管理功能。一个完善的 Model Registry 不仅记录模型的名称和版本号,还会维护模型的状态(如"实验中""待审核""生产中""已废弃")、性能指标、部署配置等元数据。团队可以借鉴类似思路构建面向产品展示层的模型元数据管理系统,确保前端展示、权限控制和计费系统都从同一个数据源获取模型信息,从根本上消除因多处维护导致的不一致问题。
-
加入去重与校验逻辑:在展示层或构建流程中增加简单的去重、拼写校验机制,能有效拦截此类错误。例如,可以在 CI/CD(持续集成/持续部署)流水线中加入自动化脚本,检查所有面向用户的文案中是否存在重复条目或格式异常。CI/CD 是现代软件开发中自动化构建、测试和部署的标准实践,常用平台包括 GitHub Actions、GitLab CI、Jenkins、CircleCI 等。具体技术手段包括:在构建脚本中对配置文件的数组字段执行
Set去重验证(利用集合数据结构的天然去重特性,如 JavaScript 中的new Set(array).size === array.length即可判断是否存在重复元素),使用 lint 工具扫描国际化(i18n)文件中的重复键值,甚至可以利用正则表达式在预提交钩子(pre-commit hook)中检测文案模板里的连续重复模式。Pre-commit hook 是 Git 版本控制系统提供的一种客户端钩子机制,它允许开发者在代码提交之前自动执行预定义的检查脚本——如果检查不通过,提交将被阻止,从而在问题进入代码仓库之前就将其拦截。这些措施的实施成本极低(通常只需几十行脚本代码),但能显著降低低级错误流入生产环境的概率。 -
建立发布前的UI Review流程:即便是文案层面的改动,也应纳入代码审查或测试流程。许多成熟的产品团队会在发布前进行截图对比测试(Visual Regression Testing),自动检测UI层面的异常变化。常用的工具包括 Percy(由 BrowserStack 提供,支持跨浏览器截图对比)、Chromatic(与 Storybook 深度集成,Storybook 是前端组件开发和文档化的流行工具)、BackstopJS(开源轻量级方案,支持 Docker 化运行以确保截图环境一致性)等,它们的工作原理是在每次代码变更后自动截取关键页面的截图,并与基准版本进行像素级对比,将差异部分高亮标记供团队审查。更先进的工具还引入了AI驱动的智能对比算法,能够区分"有意义的视觉变化"(如设计更新)和"无意义的噪声"(如字体渲染的微小差异),从而减少误报率。这种方法特别适合捕捉那些人眼容易忽略但确实存在的细微变化,如文案重复、字体异常、元素错位等。
-
重视社区反馈闭环:像这次一样,用户往往是最敏锐的"测试员",快速响应和修复能够传递出团队对产品品质的重视。建立从社区反馈到内部工单的自动化流转机制,能显著缩短此类问题的修复周期。例如,可以通过监控 Reddit、Twitter/X、Discord 等平台的品牌关键词提及,利用情感分析(Sentiment Analysis)自动识别负面反馈,并通过 Webhook 将其转化为 Jira 或 Linear 中的工单,确保每一条有价值的用户反馈都不会被遗漏。情感分析是自然语言处理(NLP)中的一个成熟子领域,现代的情感分析系统已经能够准确区分讽刺、建设性批评和真正的产品缺陷报告,一些工具如 Mention、Brand24、Hootsuite 等已经将这些能力集成到了开箱即用的社交媒体监控方案中。一些领先的产品团队甚至会在社区中公开回应并标注修复进展(例如在 GitHub Issues 或产品更新日志中引用社区反馈的原始链接),这种透明度本身就是建立用户信任的有效手段。在开源社区文化影响下,这种"在公众面前修bug"的做法不仅不会被视为软弱,反而会被用户解读为团队对产品质量的真诚承诺。
结语
"Claude Sonnet 5"出现两次,本身只是一个轻松的社区谈资。但透过这个小小的界面失误,我们能看到AI产品在高速发展期普遍面临的质量与速度平衡难题。
在模型能力日新月异的今天,谁能在保持迭代速度的同时守住细节质量,谁就更有可能赢得用户长期的信任。对于任何一款希望走得更远的AI产品来说,这或许是一个值得反复咀嚼的提醒。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。