AI大模型测试三阶段:从断言到评估的进阶之路

AI测试正从断言转向评分式评估,按大模型、知识库、智能体三层递进展开。
文章指出,AI测试已从“用AI辅助测试”翻篇,进入AI主导测试乃至评估AI应用本身的三层递进体系。由于Transformer架构的采样机制和输出形式的多样性,大模型天生具有概率性,传统相等断言失效,必须改用0到1的连续评分来表达好坏,但仍需划定及格线完成上线验收。作者将AI评估类比性能测试,强调两者都靠多轮对比而非对错判断,并提出必须固定被测系统版本(模型、参数、提示词、上下文)和评估版本(数据集、断言、门槛)两个维度,仅替换其一才具横向对比价值。评估对象分大语言模型、知识库、智能体三层,复杂度递增;工具推荐CLI驱动、支持Python扩展且已被OpenAI收购的Promptfoo,适合大多数产品验收场景。
AI大模型测试三阶段:从断言到评估的进阶之路
过去半年,AI测试领域发生了显著变化。据B站UP主分享,腾讯、阿里、字节等大厂在AI测试上的发力,以及DeepSeek广告从模型研究转向工程化研究,共同推动了一个共识:单纯用AI辅助测试已成为过去式。行业正在进入AI主导测试的新阶段,并最终走向对AI应用本身的测试。
测试体系的三个层次:从用AI到测AI
UP主在课程中系统梳理了AI时代测试的三种体系,如今这些体系已从模糊的设想变得日益清晰。
用AI测试:辅助提效的过去式
早期讨论聚焦于借助AI辅助测试、提高效率。但据UP主观察,这半年来国内领先的AI公司——腾讯、阿里、字节以及DeepSeek——已经将这一阶段“翻篇”。AI不再只是辅助工具,而是开始承担更核心的测试职责。
和AI测试:人机各司其职
当前大厂推动的是“AI主导测试”。UP主解释,这不再是测试人员完全主导所有工作,而是大部分测试工作——从需求分析、用例设计、系统探索到代码编写和自动化回归——都可以交给AI。人与AI各失其职,但AI承担的比例显著上升。
对AI测试:评估AI应用本身
第三个层次是对AI进行测试,即评估那些内部使用了AI功能的软件系统。UP主举例,中国移动等企业已有AI客服,各类AI占卜、AI算命、视频生成应用层出不穷。这些AI应用的测试思路、流程与传统软件测试截然不同,需要单独的方法论。
这三个体系并非三选一的关系,而是递进关系。UP主指出,对智能体的测试就包含了对知识库和大模型的测试,复杂度逐级递增。
为什么测试要变成评估?
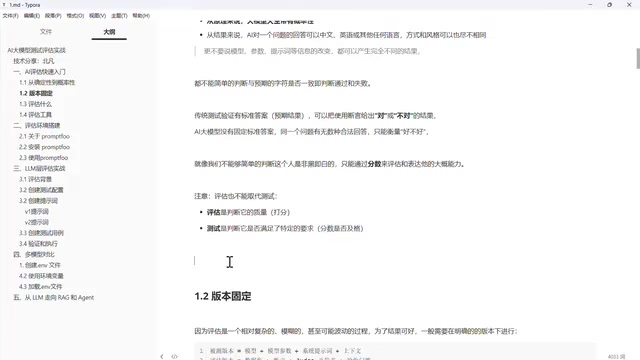
传统软件测试依赖断言——断言1等于1,或断言状态码、返回数据、字段内容。输出基本一致,断言稳定可靠。但AI大模型打破了这种确定性。
概率性:大模型的天然属性
UP主从两个角度解释了概率性的来源。原理层面,当前主流大模型多采用或参考Transformer架构,其输出本质上是概率选择,天生带有不确定性。同一问题可能得到不同回答。结果层面,即便输出一个确定的数字“2”,它也可以用中文大写、中文小写、英文、阿拉伯数字、二进制、十进制、十六进制等多种形式表达,风格也可能不同。
更关键的是,模型参数、提示词、上下文等任何一丁点改变,都可能导致结果巨大变化。用相等断言去判断“对或不对”显然不再适用。
Transformer 是 2017 年 Google 团队在论文《Attention Is All You Need》中提出的神经网络架构,其核心是自注意力机制(Self-Attention),能够并行处理序列中任意位置之间的依赖关系,取代了此前 RNN/LSTM 的逐步递归结构。GPT、BERT、LLaMA、DeepSeek 等主流大模型均基于或借鉴该架构。模型在生成每个 token 时,会对词表中所有候选词计算一个概率分布,再按该分布采样输出,因此同一输入在不同采样策略(如 temperature、top-p)下可能得到不同结果。这正是文章所说“输出本质上是概率选择”的技术根源,也是断言式测试难以适用的根本原因。
评估:用分数表达好坏
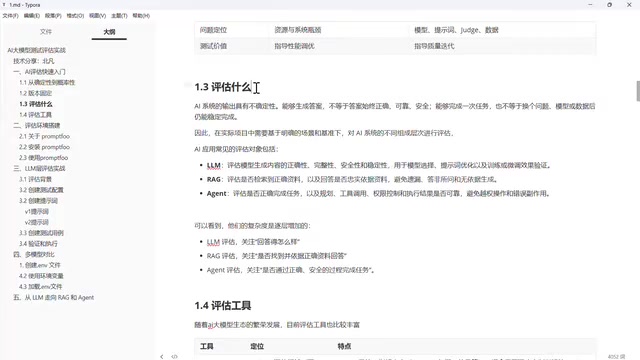
UP主用了一个生动的类比:判断一个人不能简单说“好人”或“坏人”,这种判断有失偏颇。对复杂事物的判断——如智商、癌症、肿瘤、抑郁症——往往通过分数来评估。高考作为公认公平的选拔方式,也是通过分数体现差距。
因此,AI测试采用打分方式,用0到1的连续值表达“有多好”或“有多不好”。但评估并非完全取代测试。UP主强调,评估给出分数后,仍需划定及格线,判定软件能否上线、能否发布。分数可以离散化为0和1,对应传统断言中的通过或不通过。
AI评估与性能测试的相似性
对于不熟悉AI评估的测试人员,UP主建议类比性能测试来理解。两者都不特别关心对错,而是在特定条件下通过一组数据发现问题。性能测试提bug需要至少测两轮、做对比;AI评估同样需要横向对比不同模型、不同提示词、不同门槛的效果。
做过系统性能测试的同学,可以将AI评估的概念和思路往性能测试上靠,理解起来会顺畅很多。
版本固定:AI评估的特殊要求
传统测试有版本概念,测哪个版本、报告对哪个版本负责,大家都能理解。但AI评估的版本固定更严格,需要固定两个版本。
被测系统版本
包括使用了什么模型、传了什么参数、用了什么提示词、添加了什么上下文。每一项变化都意味着被测版本变化。UP主举例,今天测DeepSeek,明天换成GPT,版本就不对了,结果需要重新评估。
评估版本
包括用了什么数据集、什么断言、什么门槛。数据集或门槛变了,结果也会不同。
UP主指出,只有固定一个版本、替换另一个版本,才具备横向对比价值。两个版本同时变化,结果就是全新的独立评估,没有对比意义。
评估什么?三层递进路线
很多同学关心AI评估要评哪些指标,如召回率、准确率等。但UP主提醒,首先要确定评估对象,不同对象目的不同、指标不同。
第一层:大语言模型
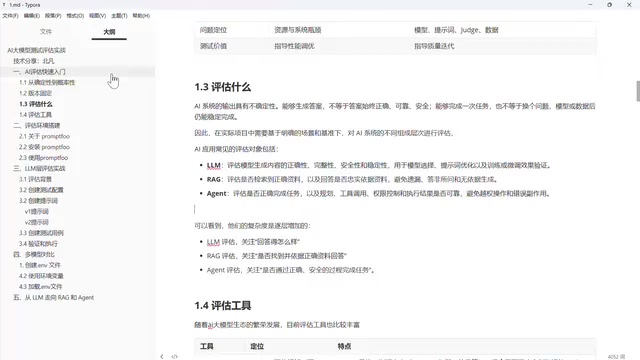
评估大模型生成内容的正确性、完整性、安全性和稳定性。对大模型公司而言这是必选项;对普通公司,评估可用于模型选型、提示词优化,以及微调后模型的验证。
第二层:知识库
知识库的原理是先检索正确资料,再结合资料回答问题。评估需覆盖检索环节和生成环节,关注检索是否准确、生成结果是否有参考资料支撑,即忠实度问题。
知识库问答通常采用 RAG(Retrieval-Augmented Generation,检索增强生成)范式:先把文档切分成片段并向量化存入向量数据库,用户提问时先检索出最相关的若干片段,再把这些片段作为上下文拼入提示词交给大模型生成答案。因此其质量由检索和生成两个环节共同决定——检索环节关注召回率、命中率、排序准确性,生成环节关注答案是否有检索内容支撑。文中提到的“忠实度”(Faithfulness)即衡量生成答案中的每个论断能否在检索到的资料中找到依据,是 RAG 评估的核心指标之一,与之并列的常见指标还有答案相关性(Answer Relevancy)和上下文精确率(Context Precision)。
第三层:智能体
智能体涉及任务规划、工具使用和任务推进,是复杂度最高的评估对象。UP主预测,旅游agent、法律agent、医疗agent等将在更重要场合普及,评估方法也需相应发展。
学习路线很清晰:先测大模型,再测知识库,最后测智能体。UP主强调,理论框架比工具实操更重要——实操看一眼即可,方向性内容才是面试和实际工作的底气。
智能体(Agent)指以大模型为决策核心、能够自主分解任务、调用外部工具并根据执行结果迭代推进的系统。其典型结构包括:规划模块(把用户目标拆解为子任务)、工具调用模块(通过 Function Calling 或 MCP 等协议调用搜索、数据库、代码执行器等外部能力)、记忆模块(保存短期对话与长期知识)。与传统单轮问答不同,智能体的输出是一条包含多步决策的轨迹,评估时既要看最终任务是否完成,也要看中间步骤是否合理、工具调用是否正确、有无冗余或危险操作。常用的评估维度包括任务成功率、步骤效率、工具调用准确率以及轨迹级的 LLM-as-a-Judge 打分。
工具选型:Promptfoo与RAGAS
UP主列举了多种AI测试工具,重点介绍了两个。第一个是PyTest风格的评估工具,适合有PyTest自动化经验的同学。第二个起源于RAG评估,如今也可测智能体和模型。
最终推荐的是Promptfoo。UP主给出几个理由:它支持CLI和UI两种驱动方式,CLI意味着可被AI自身调用,未来可能出现“AI评估AI”的场景。同时支持批量调用和Python自定义,扩展性强。更重要的是,Promptfoo已被OpenAI收购,其优秀性得到认可。
UP主也指出,工具选择应视场景而定:做指标学术研究可选专业工具;做线上智能体生产监控可选监控类工具;对大多数测试同学,评估是为了判定产品能否上线的验收场景,Promptfoo较为合适。
Promptfoo 是一个开源的提示词与 LLM 应用评估工具,通过 YAML 配置文件声明测试用例、待比较的模型或提示词以及断言类型,可在命令行中批量运行并生成可视化对比报告,支持自定义 Python/JavaScript 断言和 CI 集成。RAGAS(Retrieval Augmented Generation Assessment)则最初专注于 RAG 流水线的自动化评估,提供忠实度、答案相关性、上下文召回率等无需人工标注参考即可计算的指标框架,后来扩展出对智能体和通用模型的评估能力。两者定位不同:Promptfoo 更偏向工程化的提示词对比与回归验收,RAGAS 更偏向指标体系的学术化度量,实际项目中常结合使用。
结语
从断言到评估,不只是术语变化,更是思维方式的转变。AI的概率性本质决定了测试必须从“对错判断”转向“程度评分”,同时保留及格线判定的验收环节。三层评估对象——大模型、知识库、智能体——构成了清晰的学习路径,而版本固定和工具选型则是落地实践的关键保障。
相关推荐

Hermes Agent零基础实战:自进化AI助手
Hermes Agent 零基础教程:GitHub 41.7K 星的自进化 AI Agent 怎么装怎么用。本文拆解其学习循环、三层记忆与 Skill 自改进机制,对比 Claude Code 和 OpenClaw 的差异,并附 WSL 安装实操步骤。

RAG面试核心:离线建库与在线检索全流程拆解
拆解RAG检索增强生成的完整工作流程:离线阶段文档加载、切割、向量化、入库,在线阶段问题改写、向量检索、重排、生成,并解析RAG面试核心考点与系统优化方向。

AI大模型零基础入门:原理与API调用实战指南
从AI发展脉络到大模型训练原理,再到Token、Temperature、Top-P等核心概念,本文结合实战课程讲解系统提示词、Function Call、RAG与记忆能力的实现逻辑,并给出四类API调用场景的落地路径,适合零基础开发者入门。