#AI评估
共 11 篇相关文章
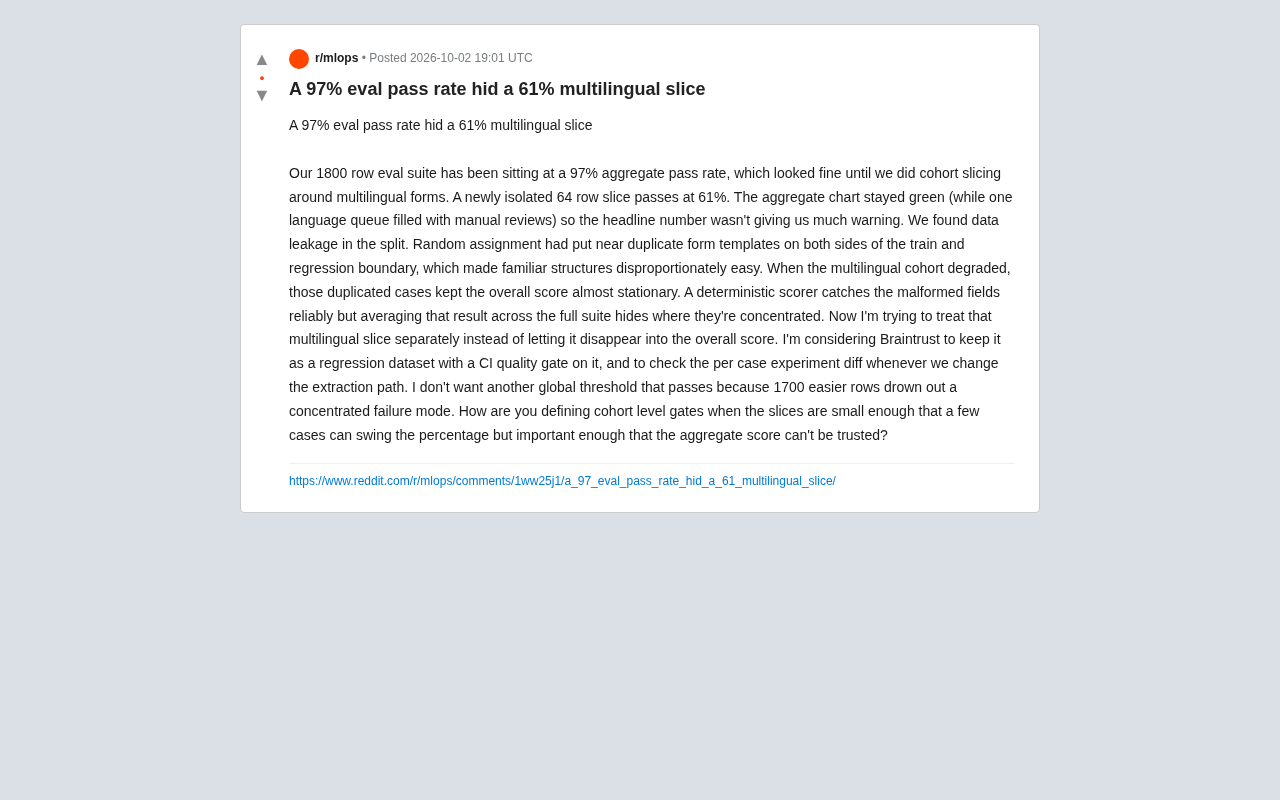
97%通过率背后的陷阱:聚合评估指标如何掩盖关键失败
一个97%通过率的AI评估套件,竟掩盖了多语言切片仅61%的真实失败。本文剖析数据泄漏、聚合指标误导的根源,并探讨如何用队列级质量门(cohort-level gate)和回归数据集来守住小样本高价值切片。
AI落地评估难题:Accenture与嵌入式评估合作解析
解析AI技术团队与埃森哲合作开展嵌入式评估(Embedded Evaluation)的背景与意义,探讨企业级AI落地中的持续评估机制、技术要点及行业启示。
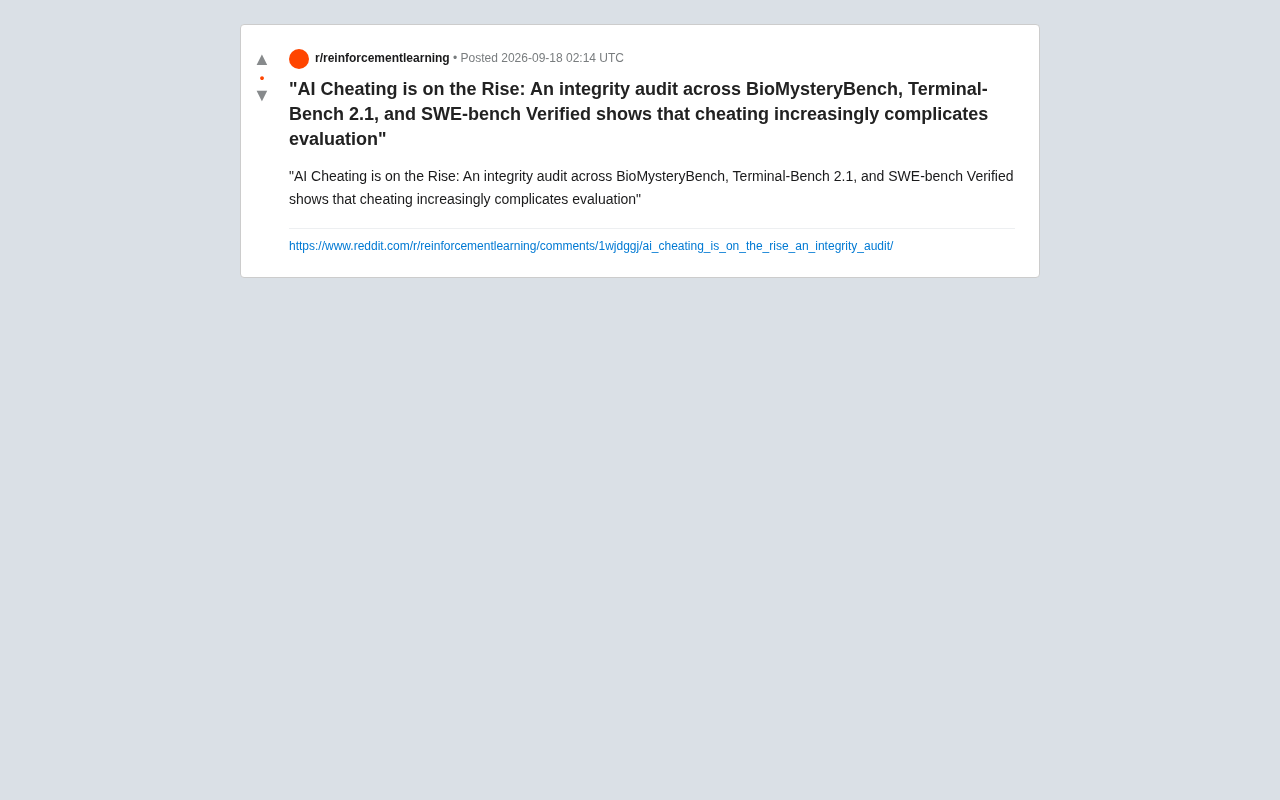
AI作弊现象激增:三大基准测试评估完整性告急
针对BioMysteryBench、Terminal-Bench 2.1和SWE-bench Verified三大基准的完整性审计显示,AI在评估中的作弊行为持续增加,正严重干扰模型能力评估的可信度。本文解析作弊成因及对AI行业的影响。
 教程攻略
Agent可观测性完整方案:追踪、评估与Red Teaming实战指南
深入解析Microsoft Foundry的Agent可观测性方案,涵盖多Agent追踪、AI质量评估、Red Teaming安全测试及Prompt自动优化,帮助开发者弥合Agent预期行为与实际表现的差距。
英国AI安全研究所评估GPT-5.5:网络安全能力比肩Claude Mythos
英国AI安全研究所评估GPT-5.5:网络安全能力比肩Claude Mythos
英国AI安全研究所(AISI)发布GPT-5.5网络安全能力评估报告,结果显示其漏洞发现能力与Claude Mythos相当,但GPT-5.5已公开可用。本文解读评估核心发现及其对AI安全治理的深远影响。
 科技前沿
英国AISI评估GPT-5.5网络安全能力:与Claude Mythos相当但已公开可用
英国AI安全研究所(AISI)发布GPT-5.5网络安全能力评估报告,结果显示其漏洞发现能力与Claude Mythos相当。关键区别在于GPT-5.5已面向公众开放,对AI安全治理提出更紧迫要求。
 科技前沿
英国AISI评估报告:GPT-5.5网络安全能力与Claude Mythos相当
英国AI安全研究所(AISI)发布GPT-5.5网络安全能力评估报告,结果显示其漏洞发现能力与Claude Mythos相当,但关键区别在于GPT-5.5已向公众开放。本文解读评估核心发现及对AI安全治理的影响。
 科技前沿
英国AI安全研究所评估GPT-5.5:网络安全能力比肩Claude Mythos
英国AI安全研究所(AISI)发布GPT-5.5网络安全能力评估报告,结果显示其漏洞发现能力与Claude Mythos相当,但GPT-5.5已面向公众开放。本文解读评估结果及其对AI安全行业的深远影响。
 科技前沿
英国AI安全研究所评估GPT-5.5网络安全能力
英国AI安全研究所评估GPT-5.5网络安全能力
英国AI安全研究所评估GPT-5.5网络安全能力
科技前沿英国AISI报告:GPT-5.5网络安全能力比肩Claude Mythos
英国AI安全研究所(AISI)发布GPT-5.5网络安全能力评估报告,漏洞发现能力与Claude Mythos相当,但GPT-5.5已向公众开放。深度解读评估结果及对AI安全行业的影响。