AI大模型测试三阶段:从原理到API调用实战指南
面向测试从业者的AI大模型三阶段能力升级路径:从网页使用到提示词工程,再到代码级SDK调用与智能体构建。
本文以测试从业者视角,系统梳理了大语言模型的核心原理与三阶段进阶使用路径。第一阶段是基础的文本输入;第二阶段是提示词工程,通过高质量指令提升AI执行效果;第三阶段是基于Python OpenAI SDK的代码调用,可完全掌控模型选择、消息角色(user/assistant/system)和流式输出等参数,能力远超网页端。文章还澄清了API Key与Token的关键区别——前者无过期概念应存入环境变量,这也是高频面试考点。当具备代码调用能力后,便可构建从生成用例到自动执行、输出报告的智能体闭环,其落地方向即当前最热的RAG(知识库)与Agent(智能体),这也是AI应用测试区别于普通黑盒测试的核心所在。
对测试从业者来说,AI大模型带来的不仅是新工具,更是一条清晰的能力升级路径。这份来自B站测试教学的分享,把大模型的测试与应用拆成了三个递进阶段:从基础的文本输入使用,到提示词工程的进阶,再到基于代码和API的高阶调用。理解这条路径,能帮你从「会用AI」跨越到「会测AI应用」。
大语言模型的基本原理:输入一段,输出一段
抛开多模态的复杂性,大语言模型最核心的运作可以简化成一句话——输入一段文本,输出一段文本。中间发生的「变换」,本质是预训练模型结合自注意力机制,通过概率推算得出最可能的输出内容。
这里有个关键概念是 Token(分词)。文本会被专门的分词器切分成最小处理单位。原视频特别指出,在真实项目中我们通常不会手动做分词处理,原因有三:大模型自带分词器;不同模型的分词器各不相同,手动拆分意义不大;逐字处理效率太低。理解这个机制,就能明白为什么模型是「输入一段、输出一段」而非逐字响应。
从这个简单结构出发,可以推导出两个经典应用场景。翻译是Transformer最初被提出时要解决的问题——输入一段外语,输出对应含义的另一段文字。聊天则是另一个典型:有来有回,你输入内容,模型必然会回应你。正如原视频调侃的,「哪怕你让它闭嘴,它也会输出内容」,因为内容生成是它最底层的特征。
三阶段进阶:从手动输入到提示词工程
掌握原理后,使用方式呈现出明显的三个层级。
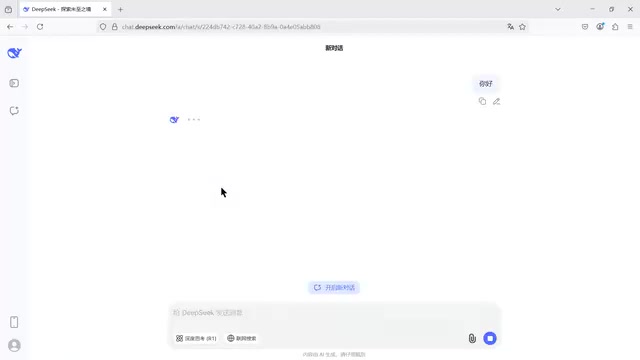
第一阶段是基础的内容输入。 无论是打开DeepSeek广告网页、下载APP,还是用自动化脚本填入,对大模型而言并无区别——你只要输入内容,它就会输出内容。但如果只是漫无目的地聊天,AI并不会对测试工作产生真正价值。
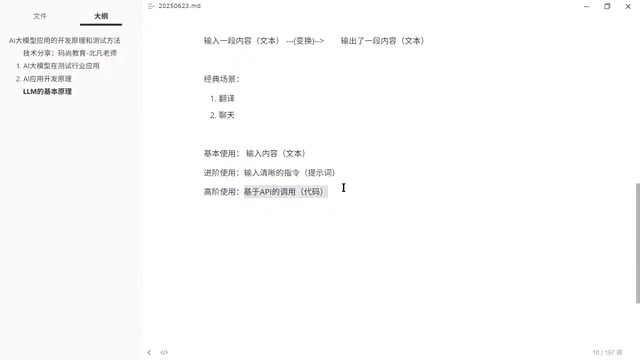
第二阶段是提示词工程(进阶)。 关键在于不是单纯输入内容,而是输出「清晰的指令」。原视频给了个直观例子:直接聊天时模型会大段回复,但如果发出明确指令「每次回复内容不要超过两个字」,输出立刻变得简洁。这种输入高质量、高效率、能达成更好执行效果的指令的过程,就是提示词工程。对测试而言,这意味着你可以让AI帮你分析测试点、设计用例、甚至生成代码,效率远高于随意对话。
不过这两个阶段有个共同的天花板:你离不开DeepSeek的网页或APP。一旦要把AI能力打包成团队工具或对外收费的产品,界面上充斥的第三方Logo就成了问题。这就催生了第三阶段。
高阶应用:基于API的SDK调用
第三阶段是基于API的调用,这也是从功能测试向接口测试、自动化测试跨越的分水岭。用代码方式调用大模型,意味着代码是你自己的——它长什么样、怎么运行、输出什么结果,完全由你掌控,还能自行包装前端,隐藏底层模型来源。
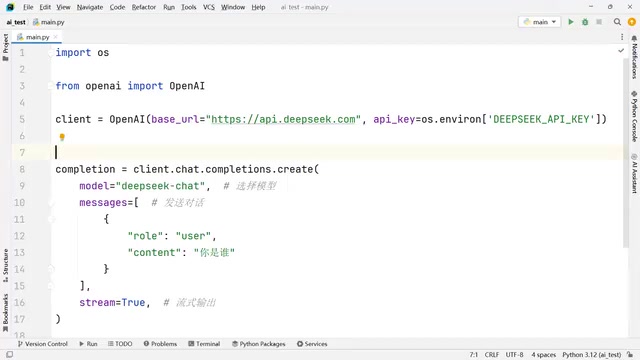
目前行业标准是 OpenAI 库。OpenAI这家推出ChatGPT的公司,为大模型调用提供了一套基于Python实现的工具。虽然接口调用听起来像用Postman就能搞定,但真正好用的方式还是要进入Python代码层面。
实操上,核心是导入OpenAI模块并进行实例化,需要两个关键参数:
- 接口地址(base_url):指向要调用的大模型接口
- API Key:身份凭证
原视频特别对比了 API Key 与 Token 的区别,这是一个高频面试考点。Token有失效时间,过期后需重新登录获取;而API Key在设计上没有失效概念,一次生成长期有效。因为API Key关联着钱包余额,最佳实践是把它放到环境变量中,再从环境变量取出与接口地址组合调用。
这种调用方式被称为 SDK 调用——它同样基于HTTP协议,但用法比传统接口测试更丰富复杂。原视频提到,不少招聘要求会写明需要「SDK测试经验」,很多测试人员因没接触过而困惑,其实它指的正是这种代码化的接口调用方式。
关键参数:模型、角色与流式输出
调用对话生成接口时,有几个必须掌握的参数:
模型选择:DeepSeek有两个模型,ChatGPT、谷歌、阿里千问等各有多个模型,必须写正确。
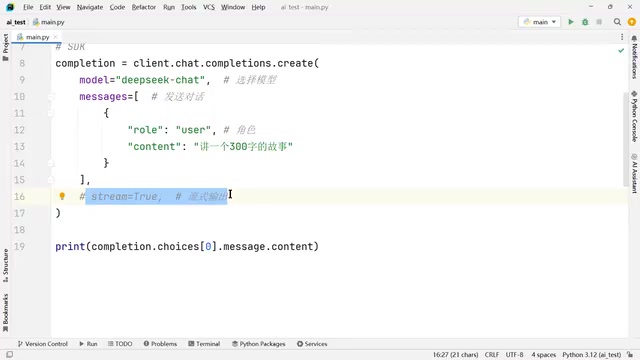
消息内容与角色(role):这是网页端做不到的控制能力。在SDK层面,你可以设置消息的角色——user(用户提问)、assistant(AI)、system(系统提示),每种作用不同。而在网页里,你只能输入「你是谁」这三个字,无法选择角色,掌控力远不如代码方式。
流式输出(stream):非必填参数。开启时,模型生成多少就输出多少(类似网页里逐字蹦出的效果);关闭时,模型会等全部内容处理完毕再一次性返回。原视频用「警察办案」作比喻——流式是实时公布进展,非流式是破案后开新闻发布会一次性发布。
这里牵涉到重要的测试视角:如果测的是用户体验,通常希望流式输出打开,避免用户误以为程序卡死;如果测的是功能完整性,则可能需要完整输出后再校验。两种模式没有对错,取决于测试目标。
SDK(Software Development Kit,软件开发工具包) 是厂商封装好的代码库集合,开发者通过 pip install openai 安装后即可在 Python 中直接调用,无需手动构造 HTTP 请求头、处理认证、解析 JSON 响应等底层细节。相比直接用 Postman 或 requests 库发起裸 HTTP 请求,SDK 调用的优势在于:方法签名更语义化(如 client.chat.completions.create()),流式响应的迭代器处理已被封装好,以及错误重试等边界逻辑由库本身负责。值得注意的是,由于 OpenAI 最早确立了行业接口规范,DeepSeek、阿里千问、月之暗面等国内主流大模型均选择兼容 OpenAI 的接口格式,这意味着同一套 SDK 代码只需修改 base_url 和 model 参数,即可切换到不同厂商的模型,大幅降低了迁移成本。
system 角色在实际工程中的重要性值得单独说明。与 user 和 assistant 消息不同,system 消息不参与对话轮次的展示,而是作为「隐藏的全局指令」贯穿整个会话,用于设定模型的身份、口吻、回复边界等行为规范,例如「你是一名专业的接口测试工程师,只回答与测试相关的问题,拒绝其他话题」。这正是各类商业 AI 产品差异化定制的核心手段——产品背后用的可能是同一个基础模型,但通过不同的 system 提示词,就能塑造出截然不同的产品人格。从测试角度看,system 提示词的鲁棒性(即用户能否通过精心构造的 user 输入绕过 system 约束,即「越狱」攻击)是 AI 应用安全测试的重要检测项。
从代码调用到智能体:AI测试的落地方向
当你能用代码方式调用大模型时,就不会满足于在输入框里单调地输入内容了。原视频举了一个极具启发的场景:
过去用AI生成接口测试代码,你还得手动复制、粘贴到文件、右键运行。但在代码层面,AI生成的代码本身就可以直接执行——让AI生成代码后自动保存到文件(如 AAA.py),再用Python运行这个文件。这样就实现了从设计用例 → 执行用例 → 生成报告的全自动闭环,甚至把报告自动发到邮箱。
这个逻辑指向的正是当下最热的概念——智能体(Agent)。掌握了用代码方式使用大模型,就等于达到了大模型应用的高阶水平,与「只会拥抱AI、使用AI」完全不是一个层次。
原视频最后点明了 LLM 应用落地的两大方向:一是 RAG(知识库),二是 Agent(智能体)。它同时强调,单纯的聊天机器人并不算真正的AI应用——因为模型天生就会聊天,DeepSeek连模型都开源免费。真正有价值、能收费的,是构建在基础能力之上的其他应用能力。对测试从业者而言,理解大模型开发原理,才能测好这些AI应用,而不是把它当成普通网页或APP来做黑盒测试。
RAG(Retrieval-Augmented Generation,检索增强生成) 是当前 LLM 落地最主流的工程模式之一。其核心思路是:在调用模型之前,先从外部知识库(如企业内部文档、测试用例库、接口文档)中检索与当前问题最相关的片段,再将这些片段拼入提示词一起发给模型,从而让模型「知道」训练数据之外的私有知识。这解决了大模型两个典型缺陷:知识截止日期导致的信息滞后,以及无法直接访问企业私有数据。Agent(智能体) 则更进一步——它让模型不只是「回答问题」,而是具备调用外部工具(执行代码、读写文件、调接口)的能力,并能根据执行结果自主决定下一步动作,形成「感知→规划→行动→反馈」的循环。对测试工程师而言,能否区分一个 AI 产品是简单聊天机器人、RAG 应用还是 Agent 系统,直接决定测试策略的选取方向。
相关推荐
GPT-6.2 Astra与Sol发布:双模型架构与社区热议
OpenAI 发布 GPT-6.2,包含 Astra 与 Sol 两个模型。本文梳理官方公告与 Hacker News 社区讨论,分析双模型架构对开发者的潜在影响与选型建议。

Gmod TTT 埃及主题地图:太空资本主义与法老对决
探索Gmod TTT埃及主题地图的趣味玩法:玩家选择法老等角色,通过立方体传送到太空,展开资本主义与共产主义的幽默对决,并体验道具战斗的混乱乐趣。

GraphRAG:超越搜索,实现全局知识发现
GraphRAG 是微软研究院推出的知识图谱增强检索技术,超越传统 RAG 的局部搜索,实现全局性知识发现。本文介绍其核心理念、代际演进及医疗领域应用案例。