AI大模型开发学习路径:从零基础到企业实战完整指南

为什么大模型学习需要系统化路径
大模型应用开发已成为当下技术领域最炙手可热的方向。根据麦肯锡2023年全球调查,超过50%的企业已在至少一个业务领域部署了生成式AI,这一比例较前一年翻倍,开发者需求随之激增。然而市面上的学习资源却普遍碎片化,教育资源的结构性缺口——重演示、轻工程化——成为行业普遍痛点。一位B站UP主在制作系统课程前,花了整整一个月刷遍各大平台的教程,最终得出结论:这些内容「普遍不够系统、不够完整,大多只讲单个工具的基础操作,关键的工程化落地流程却一笔带过」。
这个观察精准点出了当前AI教育的核心痛点——播放量高的爆款视频往往聚焦于吸睛的表面操作,而真正决定开发者能否落地的模型微调、私有化部署、Agent开发等核心技能,反而鲜有人讲透。本文将基于系统化框架,梳理一条从零基础到企业实战的完整进阶路径。
基础认知:打牢底层理解
从概念到架构:先懂原理再用工具
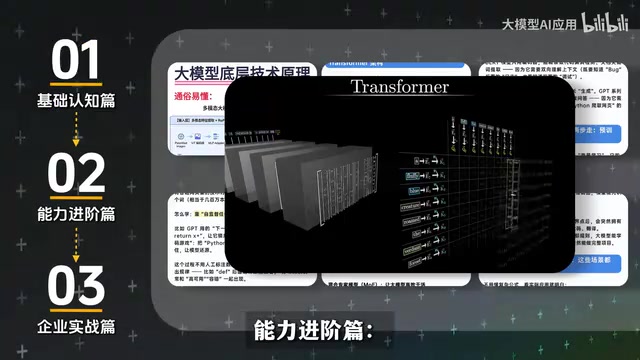
AI大模型学习的第一步,不是急于上手工具,而是建立对底层原理的正确认知。合理的入门路径应当从大模型基础概念切入,逐步走完完整的应用开发流程,最终吃透 Transformer 底层架构。
Transformer 是现代大模型的基石,由Google于2017年在论文《Attention Is All You Need》中提出,彻底革新了自然语言处理领域。值得注意的是,Transformer的影响力早已超出NLP范畴——它已延伸至计算机视觉(ViT将图像切片视为序列token)、蛋白质结构预测(AlphaFold2利用注意力机制建模氨基酸残基间的空间关系)、多模态理解(GPT-4V统一处理文本与图像)等领域,成为现代深度学习的通用骨架。理解Transformer,意味着掌握了一把可跨领域迁移的技术钥匙。
Transformer的核心创新在于完全摒弃了此前主流的循环神经网络(RNN),转而使用纯注意力机制处理序列数据。要理解这一革命性意义,需要了解RNN的根本局限:RNN以串行方式逐步处理序列,每个时间步的隐藏状态依赖于上一步的输出,这导致两个致命问题——长序列中的梯度消失(早期信息在传递过程中不断衰减)以及无法并行计算(训练效率极低)。Transformer用自注意力机制(Self-Attention)一举解决了这两个问题:每个位置的词可以直接与序列中任意其他位置建立关联,注意力权重通过Query、Key、Value三个矩阵的点积运算得出,计算可完全并行化。多头注意力(Multi-Head Attention)则通过在不同子空间中并行运行多组注意力,让模型同时捕捉词汇、句法、语义等不同层次的关系。位置编码(Positional Encoding)则通过正弦/余弦函数或可学习的嵌入,弥补注意力机制本身缺乏位置感知的不足。GPT系列、BERT、LLaMA等几乎所有主流大模型都以Transformer为骨架——理解其编码器-解码器结构(BERT使用纯编码器,GPT使用纯解码器,原始T5使用完整的编解码器)等核心组件,不仅有助于把握模型的能力边界,也能在后续微调和优化环节做出更合理的技术决策。很多开发者跳过这一步直接调用 API,结果遇到复杂问题时完全没有排查思路。
提示词工程:性价比最高的入门技能
在基础阶段,提示词工程(Prompt Engineering)是投入产出比最高的技能。零样本(Zero-shot)、少样本(Few-shot)提示以及思维链(Chain-of-Thought)等技巧,能够在不改动模型参数的前提下显著提升输出质量。
思维链(Chain-of-Thought,CoT)由Google Brain团队于2022年的论文《Chain-of-Thought Prompting Elicits Reasoning in Large Language Models》中系统提出,研究发现只需在少样本示例中加入逐步推理过程,模型在数学推理、常识推理等任务上的准确率便可大幅跃升。此后,Zero-shot CoT(仅需添加"Let's think step by step"这样的触发语句)、Self-Consistency(采样多条推理路径并投票取多数答案)、Tree of Thoughts(将推理过程建模为树状搜索)等衍生方法不断涌现。2024年随着o1、o3等"推理模型"的发布,CoT思想进一步演化为内置的慢思考机制,验证了显式推理步骤的普适价值。
思维链尤其值得重点掌握——通过引导模型「分步思考」,可以大幅改善其在推理类任务上的表现。这一技巧背后的原理在于:大模型的自回归生成机制决定了其输出受到前文token的直接影响,显式的中间推理步骤相当于为模型构建了"工作记忆",显著降低了复杂推理的出错概率。熟练运用这些方法,开发者就能以最低成本让通用大模型服务于特定业务场景。
能力进阶:从调用API到独立开发
RAG与主流开发框架
基础打牢之后,进阶阶段的核心是掌握大模型开发的全套工程化技能。其中,RAG(检索增强生成,Retrieval-Augmented Generation)是当前企业应用中最实用的技术之一。RAG由Meta AI于2020年提出,设计初衷是解决纯参数化语言模型的两大根本缺陷:知识截止日期导致的时效性不足,以及模型"幻觉"(Hallucination)——即模型以高置信度生成看似合理但实际错误信息的现象。其工作流程分为三个阶段:首先将外部文档切片并向量化存入向量数据库(如Chroma、Pinecone、Milvus等);用户查询时通过语义相似度检索最相关的文本片段;最后将检索结果作为上下文注入Prompt,引导模型基于可信来源生成回答。
值得深入理解的是,RAG的工程实现远比"切片-向量化-检索"这一简单描述复杂得多,企业级RAG系统往往需要应对文档格式多样(PDF、HTML、表格、图像)、知识更新频率不一、多语言混合、检索延迟与精度权衡等复杂工程挑战,这也是为何RAG工程师在当前AI人才市场中需求旺盛、薪资溢价显著。
文档切片策略(Chunking Strategy)直接影响检索质量——切片过小会丢失上下文,切片过大则会引入噪声;混合检索(Hybrid Search,结合稠密向量检索与BM25稀疏检索)往往比单纯的向量相似度检索效果更好;重排序(Reranking)模型可进一步精选召回结果的质量。此外,向量数据库的选型也有讲究:Chroma适合本地开发原型,Milvus和Weaviate更适合企业级生产环境,Pinecone则提供托管服务以降低运维负担。进阶的RAG变体如Graph RAG(利用知识图谱增强关联推理)和Agentic RAG(将检索过程本身交由Agent动态规划)也正成为前沿方向。这种架构使企业无需重新训练模型,即可将私有知识库与通用大模型能力相结合,是落地成本最低、效果最可控的企业AI方案之一。
在框架层面,LangChain 和 LangGraph 已成为构建复杂应用的主流选择。LangChain 自2022年底开源以来迅速成为大模型应用开发的事实标准,其核心价值在于提供了一套高度抽象的组件化接口:LCEL(LangChain Expression Language)允许开发者用声明式管道串联提示词模板、LLM调用、输出解析等环节;内置的Memory模块支持对话历史的多种存储策略;丰富的Tool集成覆盖了搜索、数据库、代码执行等主流工具。LangGraph 则进一步支持有状态、多步骤的智能体工作流编排,通过有向图结构描述复杂的条件分支与循环逻辑——这对于需要动态决策、错误重试或人机协作(Human-in-the-Loop)的企业场景至关重要。掌握这两个框架,是从「简单调用」迈向「系统开发」的关键分水岭。
Agent智能体开发:最前沿的方向
Agent(智能体)开发是目前最前沿、也最具想象空间的领域。2024年这一领域进入快速规模化阶段:OpenAI发布Assistants API与GPT-4o的工具调用能力,Anthropic推出Computer Use赋予Claude操控桌面的能力,Google DeepMind的Gemini则深度整合了Google Workspace生态。以ReAct(Reasoning + Acting)范式为代表的现代Agent框架,让大模型能够交替进行「推理」和「行动」——思考下一步该做什么,然后调用外部工具(如搜索引擎、代码解释器、数据库API等),再根据工具返回结果继续推理。
ReAct范式由普林斯顿大学和Google Research于2022年联合提出,其关键洞察在于:将语言模型的内部推理(Reasoning Trace)与外部世界的操作(Action)交织在同一生成流中,既增强了推理的可解释性,也赋予了模型感知和改变环境的能力。在此基础上,OpenAI的Function Calling和Tool Use接口将工具调用标准化为结构化的JSON输出,极大降低了工程实现的难度。多Agent系统(Multi-Agent System)则更进一步,常见的架构模式包括:监督者-工作者模式(Supervisor-Worker,由调度Agent分解任务并派发给专能Agent执行)、对等协作模式(Peer-to-Peer,多个Agent平等交换信息共同完成目标)以及流水线模式(Pipeline,Agent依序处理并传递中间结果)。AutoGen、CrewAI等专为多Agent场景设计的框架正在快速成熟,但可靠性、成本控制与安全边界仍是工程化落地的核心挑战,这正是系统化学习相较于碎片化教程的关键价值所在。这要求开发者深入理解Agent的规划能力(Planning)、记忆机制(Memory)和工具使用(Tool Use)三大核心模块,以及任务分解、状态管理等一系列机制。
模型微调与私有化部署
进阶阶段的高阶内容集中在模型微调与本地部署。LoRA(低秩适配,Low-Rank Adaptation)由微软研究院于2021年提出,其核心思想基于一个重要发现:预训练模型的权重更新矩阵在微调过程中具有"低内在秩"特性,因此可以用两个低维矩阵的乘积来近似完整的权重更新,大幅压缩可训练参数量。
从数学层面理解LoRA:对于预训练权重矩阵W(维度d×k),LoRA在其旁路注入两个低秩矩阵A(d×r)和B(r×k),其中秩r远小于d和k(通常取4~64),实际更新量ΔW = BA。训练时冻结原始W,仅更新A和B;推理时将BA合并回W,不增加任何推理延迟。以LLaMA-7B为例,全量微调需要更新70亿参数,而LoRA通常只需训练不到1%的参数即可达到接近的效果,使得在消费级GPU(如RTX 4090)上微调十亿级参数模型成为可能。
LoRA极大地民主化了大模型微调门槛。在Hugging Face的PEFT库和trl库支持下,开发者可在单张消费级GPU上完成对LLaMA-3、Mistral、Qwen等主流开源模型的特定领域适配;国内的魔搭社区(ModelScope)和Unsloth等工具进一步降低了中文场景下的微调门槛,使垂直领域模型定制变得触手可及。在LoRA基础上,QLoRA(2023)将4-bit NormalFloat量化应用于冻结的基础权重,将显存需求再度压缩约75%;DoRA(2024)则将权重分解为幅度和方向两个分量分别更新,进一步提升了微调效果。全量微调则适用于对性能要求极高、资源充裕的场景,也可用于持续预训练(Continual Pre-training)以注入新领域知识。
在部署环节,本地私有化部署与高并发推理优化是企业落地的两大核心课题。数据安全敏感的行业(如金融、医疗、政务)往往需要私有化方案以满足合规要求,面向大规模用户的服务则必须通过模型量化(GPTQ、AWQ等主流量化方案可在几乎不损失精度的情况下将模型体积压缩至原始大小的25%~50%)、KV Cache优化(缓存历史注意力计算结果以避免重复计算)、批处理推理(Continuous Batching,动态拼接并发请求以提升GPU利用率)等手段解决推理性能与成本的平衡问题。这些恰恰是新手最头疼、也最难从零散教程中学全的部分。
企业实战:让技能真正转化为价值
可直接落地的真实项目
技术学习的最终目的是解决实际问题。实战阶段应围绕可落地的真实项目展开,例如智能问答 Agent、电商智能客服、企业级 AI 智能体以及智能助教等典型应用。
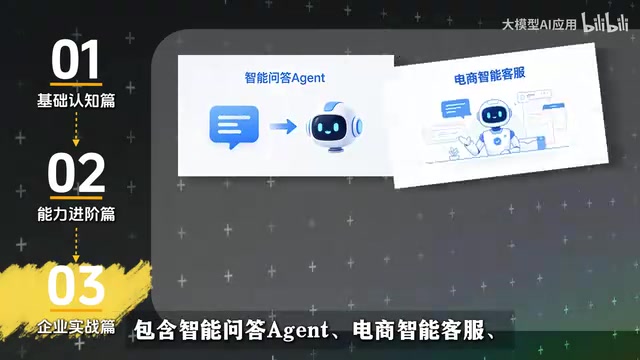
这些项目覆盖了大模型应用的主流商业场景。以电商智能客服为例,它综合考验 RAG 知识库构建、意图识别、多轮对话管理等多项技能;企业级 AI 智能体则往往需要打通内部系统、调用多种工具,是对综合工程能力的集中检验。真实项目的价值还在于暴露"课程中学不到"的工程细节——例如如何处理向量检索的召回率与精确率的权衡、如何设计Agent的错误恢复机制(包括重试策略、降级方案和人工介入触发条件)、如何在多轮对话中高效管理上下文窗口(Token预算管理、历史摘要压缩、重要信息持久化等策略),以及如何对大模型应用进行可靠的评估(LLM-as-Judge、基于测试集的自动评估、用户反馈收集等方法)。
从学习者到开发者的跃迁
真正的能力体现在「学完就能用」。通过完整的项目实操,学习者能够将碎片化的知识点串联为系统能力,实现从「调用API」到「独立完成企业级应用开发」的跃迁——这也是区分业余爱好者与专业开发者的核心标准。
如何选择优质的学习资源
面对海量AI教程,学习者应当警惕那些只讲表面操作的碎片化内容。一套优质的学习路径应具备三个特征:理论与实操深度结合、覆盖工程化落地全流程、配套真实可复现的项目案例。
对于零基础学习者,建议严格遵循「基础认知 → 能力进阶 → 企业实战」的递进逻辑,切忌跳过原理直接堆砌工具。唯有理解底层机制——从Transformer注意力计算的Q/K/V矩阵运算,到RAG的向量检索与重排序原理,再到Agent的ReAct规划推理范式——才能在快速迭代的AI技术浪潮中保持持续的适应能力。大模型技术仍在高速演进,但扎实的系统化基础,始终是应对变化最可靠的武器。
核心要点
核心要点
核心要点
相关推荐

GitHub日报·10月23日:Agent运行时与技能库同日爆发

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。