AI大模型面试突击:LangGraph与RAG项目如何讲清楚
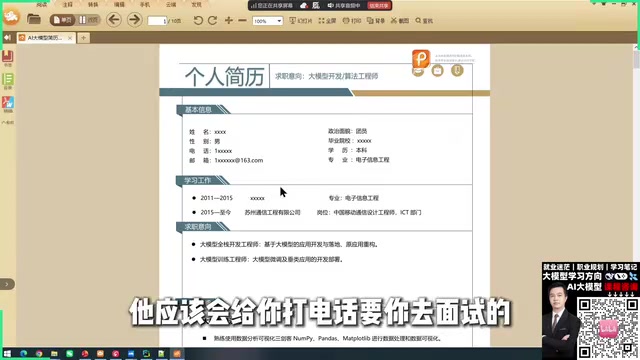
AI大模型面试先过简历关:排序、技能裁剪与三个项目包装的逻辑。
本文整理自一场AI大模型岗位面试初级班直播,指出框架面试题可以突击,但简历和项目讲不清就连面试机会都拿不到。核心建议包括:简历模块按“最想给面试官看的放最前”排序;专业技能模板必须按真实掌握情况删改并拆行写具体;由于AI应用项目周期普遍一个月到三个月、团队两三人,简历建议包装三个以上项目以支撑时间线,大厂持续迭代的项目可例外;LangGraph面试重点在状态结构设计与多轮流程中的状态一致性,RAG项目则围绕瓶颈、改动与效果变化方向做定性表达。
面试突击班的第一课:简历与项目才是敲门砖
一场面向AI大模型岗位的面试初级班直播课,把20道LangChain、LangGraph相关的面试题放在了一边,先讲了一个更前置的问题:简历怎么写、项目怎么包装。这个安排本身就说明了一件事——框架API可以突击背,但简历上的项目经历如果讲不清楚,连面试机会都拿不到。
直播内容围绕四个话题展开:AI大模型简历的撰写规则、简历中的项目包装、LangChain与LangGraph面试题,以及后续单独安排的笔试题环节。本文重点拆解前两部分,并结合RAG项目的表达逻辑给出可操作的建议。
简历排序的核心规则:把最亮眼的东西放最前面
讲师给出的第一条规则非常直接:你愿意给HR或面试官看的东西放最前面,不想被看到的放后面。这不是排版美学,而是信息优先级的博弈。
典型简历包含基本信息、工作经验、专业技能、求职意向、项目经验、自我评价五块。基本信息固定在前面,其余模块的顺序没有统一标准,判断依据只有一个——哪一部分最能让面试官产生“给你打电话”的冲动,就把它提到前面。
- 名校计算机相关专业背景,学历直接放最前,而且要写得显眼
- 学历普通,就把专业技能模块提前,用技术栈的密度换取注意力
- 项目足够亮眼,项目经验前置同样成立
这条规则之所以重要,是因为筛选简历的人平均停留时间极短,前三屏之外的内容被看到的概率大幅下降。
专业技能怎么写:模板是骨架,替换才是关键
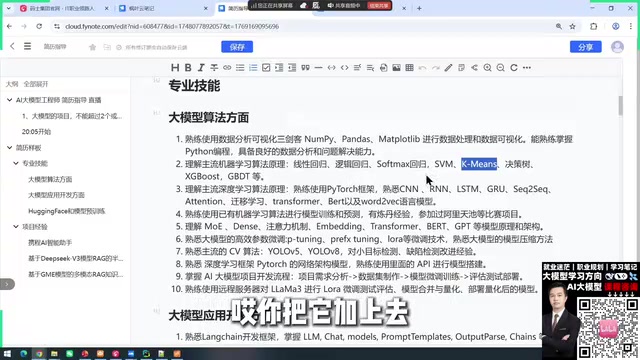
直播中展示了一份已经写好的专业技能模板,但讲师强调的重点不是照抄,而是“控制C控制V之后必须改”。模板里列出的技能项,会什么留什么,不会的直接删掉。
以向量检索相关技能为例,模板给出了可以拆行展开的写法:
- 第一行写基于BGE、Qwen等embedding模型的部署与文本向量化
- 第二行写基于Qwen embedding与re-rank模型完成文本向量化和重排
- 第三行写基于GME-embedding-VL实现文本与图片的向量化,完成多模态嵌入模型部署
把一长串技能拆成多行、每行对应一个具体能力,比堆砌关键词更容易让面试官判断你的真实边界。讲师对“一个字都不想改”的态度相当尖锐:如果连模板都不愿意按自己的实际情况调整,那找工作这件事本身就值得重新考虑。
项目包装的数量逻辑:为什么建议至少三个
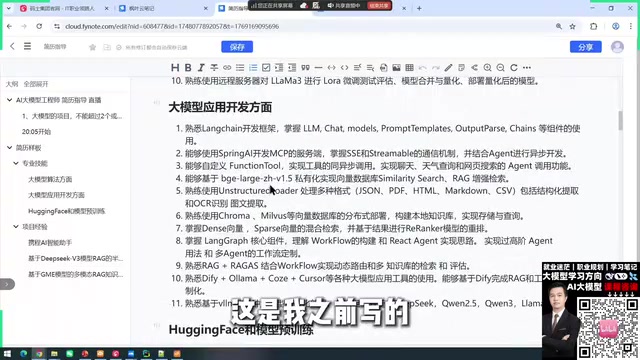
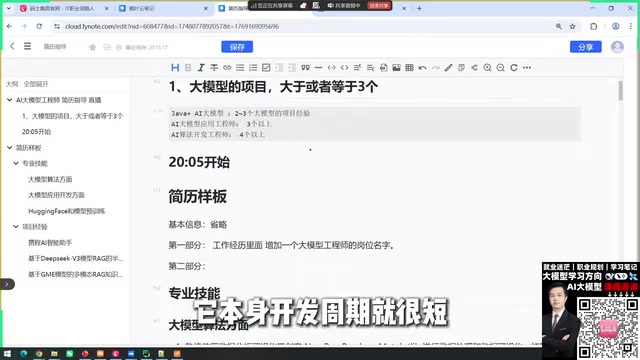
这是全场信息密度最高的部分。讲师给出的建议是:AI大模型简历中的项目数量应大于等于三个。支撑这个建议的是一个被反复提到的行业观察——AI应用类项目的开发周期普遍很短。
直播中举了一个真实案例:某位同学在企业里独立开发了一个基于原有ERP系统的智能采购助手,整个项目一个人完成,耗时约两个月。讲师接触到的其他AI大模型应用项目,开发周期大致在一个月到三个月之间,团队规模通常在两人左右,不超过三人。
按这个节奏推算,如果简历上的项目时间跨度包装到半年到八个月,只写一个项目在时间线上根本立不住,三个项目才构成合理的叙事密度。
例外情况同样存在:在大公司做完项目后持续做优化、迭代、增加新功能,单个项目的周期可以拉长,写一到两个项目也说得通。讲师也承认有少部分同学只写一两个大模型项目,因此这条建议是经验法则而非硬性标准。
Embedding与re-rank是RAG链路中两个容易混淆但职责不同的环节。Embedding模型(如BGE、Qwen-embedding、GME-embedding-VL)负责把文本或图片映射为稠密向量,使语义相近的内容在向量空间中距离更近,从而支撑向量检索;它决定了“能不能召回”。Re-rank模型则对初步召回的候选文档做更精细的相关性打分和重新排序,通常计算成本更高但只作用于少量候选,用于提升Top结果的准确性;它决定了“召回的排得对不对”。多模态embedding(如GME-embedding-VL)进一步把图片也映射进同一向量空间,使文本查询可以检索图片内容。面试中能区分两者的作用与引入时机,是判断RAG工程经验的重要信号。
LangGraph与RAG项目怎么讲清楚
面试题环节涉及LangChain与LangGraph框架,这两者在项目表达中的定位不同,讲法也应该分开。
LangChain类问题通常落在组件层面——文档加载、切分、向量化、检索器配置。回答时把每个环节的选择理由说清楚,比罗列API更有说服力。比如为什么选这个切分策略、检索Top-K怎么定、重排模型在什么情况下才引入。
LangGraph的考点集中在状态管理。面试官关心的不是你调用过哪些节点,而是你如何设计状态结构、如何在多轮流程中传递和更新状态、遇到分支和循环时怎么保证状态一致性。讲项目时把这部分展开,能直接体现你对Agent编排的理解深度,而不只是会跑通一个demo。
RAG项目最容易被追问的是效果问题。素材中没有给出具体的性能指标,但表达逻辑可以遵循一条主线:原始方案的瓶颈在哪、做了哪些改动、改动之后检索质量或回答准确度的变化方向如何。定性描述趋势、说清楚因果链,比报一个记不住来源的数字更稳妥。
RAG(Retrieval-Augmented Generation,检索增强生成)是一种将信息检索与大语言模型生成相结合的技术范式:面对用户提问,系统先从外部知识库中检索出相关文档片段,再把这些片段作为上下文交给大模型生成答案。相比直接依赖模型参数中的记忆,RAG能让回答基于可更新的私有数据,并显著降低幻觉。一个典型RAG链路由文档加载、文本切分、向量化嵌入、向量库检索、重排(re-rank)和最终生成几个环节组成,每个环节的取舍都会影响最终效果,这也是面试官反复追问“为什么这样设计”的原因。
LangGraph是构建在LangChain之上的有状态编排框架,核心抽象是“图”:节点代表处理步骤,边代表流转方向,并可支持条件分支与循环。它把多轮Agent流程显式建模为状态机,所有节点共享一个可读写的状态对象,每次流转都基于当前状态决定下一步。因此面试中真正有价值的是:状态里存了什么字段、哪些节点负责更新、循环如何设置终止条件、并发或异常时状态如何保持一致。能把这些问题讲清楚,说明你理解的是Agent编排的设计模式,而不是只会照着示例拼节点。
面试表达的一条隐性主线
把这场直播的内容串起来看,简历、技能、项目三者服务于同一个目标:让面试官在最短时间内形成“这个人能上手干活”的判断。项目周期短、团队小是AI应用开发的现实,简历上的项目数量和写法要贴合这个现实,而不是反过来堆砌一个经不起追问的豪华履历。
专业技能按真实掌握程度裁剪,项目按真实开发节奏组织,面试时把状态管理和检索链路的设计决策讲透——这三件事做到了,LangChain和LangGraph的面试题才有发挥的余地。
相关推荐
Yung Pueblo谈自我觉察:一本365天的心灵变革指南
Yung Pueblo在Talks at Google访谈中分享新书《Journey》的365天自我觉察结构,探讨冥想、直觉、关系共同领导与感恩实践,提出与改变做朋友的日常行动建议。
黎曼猜想被Lean形式化验证?联合声明引发热议
Lean社区博客发布黎曼猜想形式化验证联合声明,在Hacker News引发359分、263条评论的热议。本文解析Lean与mathlib的形式化验证背景、社区两极反应,以及为何在读到原文前不宜断言黎曼猜想已被证明。

FBI与USDA遭黑客攻击:关键基础设施安全再响警报
FBI与USDA据报遭黑客攻击,FBI近几个月内第二次被入侵,本次目标为国家犯罪信息中心(NCIC)。本文分析事件细节、NCIC的战略价值及政府机构面临的共性安全挑战。