AI大模型选型指南:DeepSeek与千问三实战对比

大模型课程应去模型中心化,培养跨模型选型与迁移能力。
文章围绕B站UP主明镜与点点的大模型课程设计展开,核心主张是课程不应绑定单一模型,而应培养选型与迁移能力。文章对比了DeepSeek-V3与R1的关键差异:R1在0528版本前默认不支持Function Calling和JSON Output,智能体开发应优先选用V3的0324版本。千问三则凭借编程式思维模式切换和强化的MCP、智能体支持获得好评。文中还记录了R1 0528更新及蒸馏模型发布的插曲,说明大模型领域信息半衰期极短。课程覆盖DeepSeek、千问三、OpenAI、Claude等多模型,强调Function Calling、RAG、Agent等通用概念才是可迁移的底层资产。
为什么大模型课程不该只讲一个模型
“你这个课为什么不讲DeepSeek广告?”这是B站UP主明镜与点点在推出新版大模型教程时被问得最多的问题。他的回答很直接:一个合格的大模型开发者,不能只盯着一个模型用。
这个观点值得展开。企业在技术选型时,领导可能随时问你“DeepSeek V3和千问三系列哪个更适合这个项目”,如果你只接触过一个模型,这种问题根本答不上来。UP主在视频中坦言,自己之前的课程叫《新版LangChain LangGraph MCP智能体与工作流开发》,标题里压根没提DeepSeek,但课程里照样会讲。同理,OpenAI、Claude、千问三也都会覆盖。
这种“去模型中心化”的课程设计思路,其实反映了一个现实:大模型生态变化太快,把课程绑定在某个具体模型上,半年后可能就过时了。掌握选型能力和迁移能力,比记住某个模型的API参数更有长期价值。
DeepSeek的两个模型:V3与R1的关键差异
UP主在课程中重点拆解了DeepSeek的两个主力模型。一个是DeepSeek-V3(API中叫DeepSeek-Chat),另一个是DeepSeek-R1(API中叫DeepSeek-Reasoner)。名字看起来只是版本号不同,但在应用开发中的表现差异很大。
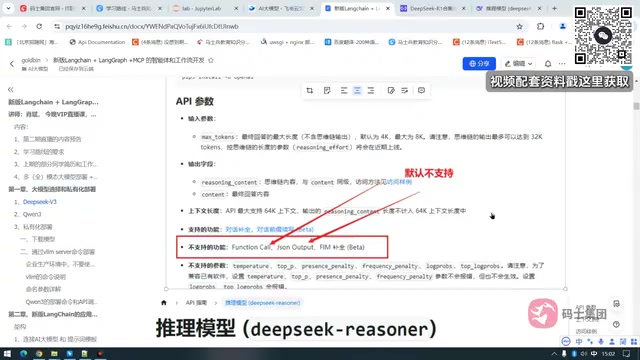
关键点在于:DeepSeek-R1默认不支持Function Calling和JSON Output。这两个能力对智能体开发和工作流编排来说几乎是刚需。如果你直接用R1做工具调用,大概率会碰到报错——不是模型坏了,是你用错了模型。
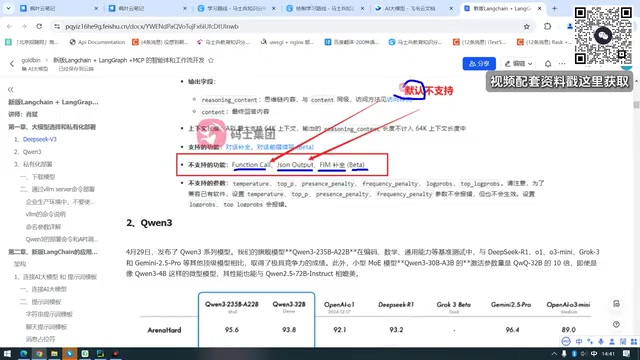
UP主特别强调,“默认不支持”不等于“永远不支持”。Function Calling本质上是OpenAI提出的一种能力,任何模型都可以通过微调来获得。他在政府部门和医院的落地案例中就看到过对R1重新微调后支持工具调用的做法。所以选型时要区分“开箱即用”和“可改造”两个层面。
那实际开发该用哪个?UP主的建议是:优先用DeepSeek-V3的0324版本。在3月24日之前的V3版本在做Function Calling时会出现循环调用的问题,他自己踩过这个坑。0324版本之后这个问题已经修复,稳定性好了很多。
一个补录带来的意外更新
视频录制过程中还发生了一个插曲。UP主刚说完R1默认不支持Function Calling,不到一周后的5月28日,DeepSeek就发布了R1的0528小版本更新,官网明确开始支持Function Calling和JSON Output。他随即补录了一段,并用下来觉得“确实非常好用”。
紧接着5月29日,又出了一个蒸馏版模型——DeepSeek-R1-0528-千问三-8B。UP主的使用感受是,这个蒸馏模型在某些场景下甚至比4月29日发布的千问三原版更好用,既支持深度思考,也支持Function Calling,还对MCP做了优化。
这段补录本身就是一个很好的注脚:大模型领域的信息半衰期极短,做技术选型不能只看静态文档,得持续跟进版本动态。
Function Calling(函数调用) 是大模型与外部工具交互的核心机制。开发者用JSON Schema描述可用函数(如查天气、查数据库),模型根据用户意图输出结构化的调用请求,应用程序执行后再把结果回传给模型。它让LLM从“只会聊天”变成能真正操作外部系统的智能体。JSON Output(结构化输出) 则要求模型严格按指定JSON格式返回内容,便于程序解析。两者都是工作流编排和Agent开发的基础设施。不同模型支持程度差异很大:有的开箱即用,有的需微调,有的完全不支持。选型时须把这两项能力作为硬指标核查。
千问三的两个能力让开发者眼前一亮
千问三在4月29日凌晨发布,UP主用了半个月后,挑出了两个他认为真正有差异化的能力。
第一是思维模式可由程序控制切换。 DeepSeek的深度思考模式需要用户在网页上手动点按钮开关,但千问三允许开发者通过传参的方式,在代码层面无缝切换深度思考与非思考模式。复杂逻辑推理时打开,简单Function Calling或MCP调用时关闭,灵活度对应用开发来说提升明显。
第二是智能体能力的增强。 UP主引用官方说法称,千问三增强了以思考和非思考两种模式与外部工具精确集成,并强化了对MCP的支持。他自己的评价是:在开源模型中,千问三对MCP、Function Calling和智能体的支持能力“最好,没有之一”。这个判断带有个人使用体验的色彩,但他也加了一个限定条件——仅限开源领域。
MoE与Dense:千问三的架构分层
千问三系列内部有两套架构。MoE架构的代表是旗舰模型Qwen3-235B和30B版本;其余如8B、14B、1.5B等则采用Dense架构。UP主没有展开做跑分对比,他的态度是“仁者见仁”,更看重实际使用中的体感差异。
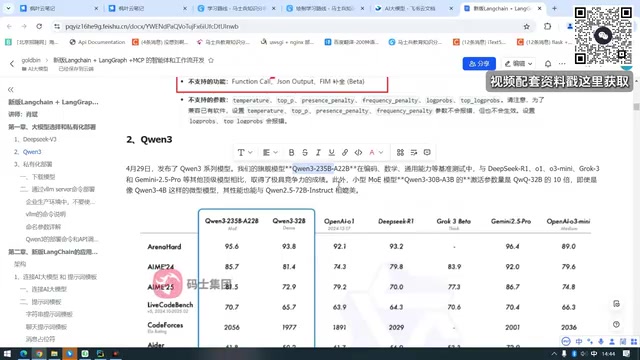
这种务实取向值得参考。模型排行榜上的分数差距,在具体业务场景中往往被数据质量、Prompt设计和工程优化所稀释。选型时与其纠结零点几分的差距,不如先跑通自己的用例。
MCP(Model Context Protocol,模型上下文协议) 是由Anthropic提出的一套开放协议,用于标准化大模型与外部数据源、工具之间的连接方式。可以把它理解为“AI应用的USB接口”:工具提供方按MCP规范暴露能力,模型或Agent框架按统一方式发现和调用,避免为每个工具单独写适配代码。MCP降低了智能体接入外部系统的集成成本,也让不同模型之间的迁移更平滑。正因如此,模型对MCP的支持程度已成为评估其智能体能力的重要维度,这也是原文强调千问三“对MCP做了优化”的原因。
MoE(Mixture of Experts,混合专家) 是一种稀疏激活架构:模型内部包含多个“专家”子网络和一个路由机制,每次推理只激活其中少数专家,因此总参数量可以做得很大,而实际计算量相对可控,兼顾能力与成本。Dense(稠密) 架构则是每次推理都激活全部参数,结构简单、部署门槛低,小参数量模型常用这种形式。这解释了千问三为何在旗舰型号上用MoE追求能力上限,在8B、14B等较小规格上用Dense保证易用性。理解这一分层,有助于根据算力预算和场景需求选择合适的模型规格。
课程覆盖的技术栈与选型逻辑
从UP主披露的课程大纲来看,内容包括大模型原理、Agent智能体、大模型框架、RAG支持库、模型微调、私有化部署等。这套组合基本对应了当前大模型应用工程师岗位的核心技能要求。
他反复传递的一个信号是:国内模型以DeepSeek和千问三为主力案例,但OpenAI、Claude等国外模型同样会用。Claude 3.5、3.7以及GPT-4o、o3都在课程范围内。这种“多模型并行”的教学方式,比单一模型教程更贴近真实工作场景——毕竟企业项目里因为成本、合规或性能原因混用多家模型的情况越来越常见。
对学习者来说,与其问“学哪个模型能找到工作”,不如问“能不能在不同模型之间快速迁移”。API形态在趋同,Function Calling、结构化输出、MCP这些概念跨模型通用,底层能力才是可迁移的资产。
常见问题
DeepSeek-R1现在支持Function Calling了吗?
根据视频中的补录信息,R1的0528版本起官方已支持Function Calling和JSON Output。此前版本需要微调才能获得该能力。
千问三和DeepSeek怎么选?
如果看重开箱即用的智能体支持和编程式思维模式切换,千问三的开源模型表现突出;如果团队已在DeepSeek生态中,V3的0324版本稳定性足够支撑工作流开发。实际选型建议用自己的业务用例做小规模对比测试。
零基础学大模型开发需要先学哪个模型?
UP主的课程设计思路可供参考:不绑定单一模型,从选型方法入手,同时接触国内外主流模型。先理解Function Calling、RAG、Agent等通用概念,再落到具体模型的API上,迁移成本会低很多。
相关推荐

主流世界之外:被忽视地区的安全与隐私困境
人本安全研究长期集中于西方,导致安全方案在主流世界失效。研究者Collins Minando基于肯尼亚移动贷款应用、网吧认证困境及九国本地专家研究,揭示社会经济约束如何重塑隐私实践,并提出移动货币隐私重设计与PETs部署路径。

Claude被曝可在正常图片中隐藏秘密信息
Reddit帖子称Claude Fable 5.1能在正常图片中隐藏秘密信息,本文梳理事件背景、图片隐写技术原理及潜在安全风险,并给出从传闻走向验证的测试路径建议。

AI助手何时该主动建议?时机决定一切
AI助手何时该主动建议?Reddit讨论揭示:同样的建议在不同时机感受迥异。本文分析主动建议的双面性、用户期待的分界线及设计原则,探讨如何平衡自动化与用户控制。