AI代理集群攻克千禧年难题?百亿级Token消耗揭示新范式
AI代理集群耗千亿Token探索Navier-Stokes难题并迁移至红队测试,方法论值得关注但结果待验证。
文章围绕一则推文展开,该推文称AI代理团队消耗超1000亿Token尝试解决Navier-Stokes方程,并将类似方法用于基础设施红队测试。文章分析认为,千亿级Token消耗反映了多代理并行协作与迭代修正的新范式,将AI角色从辅助工具转向大规模假设生成器。数学证明搜索与漏洞挖掘在计算形态上相似,均需在海量搜索空间中试错验证,因此方法迁移具有合理性。但推文未披露技术架构与验证结果,Navier-Stokes问题是否解决需同行评议,红队测试效果也缺乏数据支撑。文章同时指出规模化代理面临成本、可解释性、结果验证等挑战,强调质量与数量的平衡,建议开发者关注任务分解与验证机制设计而非盲目追求Token规模。
从Navier-Stokes到红队测试:AI代理的规模化协作新范式
近期,一则来自社交平台X(原Twitter)的推文引发了技术社区的讨论。据该推文称,上月一个大型AI代理团队消耗超过1000亿个Token,用于尝试解决数学界的千禧年大奖难题之一——Navier-Stokes方程存在性与光滑性问题。推文作者同时表示,团队正将类似方法应用于红队测试(red-teaming),以发现并修复基础设施中的漏洞。
这则信息虽然简短,却指向了两个值得深究的方向:一是AI代理集群在复杂科学问题上的规模化协作能力,二是这种能力向安全测试领域的迁移潜力。
千亿Token背后的代理协作逻辑
“1000亿Token”这一量级本身就是一个信号。单个对话式AI的典型交互往往只涉及数千到数万Token,而千亿级消耗意味着成千上万次代理调用、迭代与自我修正的循环。这种模式不再依赖单次推理的质量,而是通过海量并行尝试、多代理分工与结果筛选来逼近目标。
对于Navier-Stokes这类数学难题,传统研究依赖少数数学家的直觉与长期积累。AI代理集群的介入提供了一种不同思路:将问题拆解为子任务,由不同代理分别探索证明路径、检验中间结论、甚至尝试反例构造。推文未披露具体的技术架构与验证结果,因此我们无法确认其是否真正“解决”了该问题——千禧年难题的判定需要严格的数学同行评议,而非Token消耗量可以衡量。
但即便抛开最终结果,这种规模化探索的方法论已经值得关注。它揭示了一种趋势:AI在基础科学中的角色,正从“辅助工具”转向“大规模假设生成器”。
Navier-Stokes方程是描述流体运动的一组非线性偏微分方程,其三维形式下解的存在性与光滑性问题被克雷数学研究所列为七个“千禧年大奖难题”之一,悬赏一百万美元。该问题的核心在于:在任意初始条件下,三维Navier-Stokes方程是否总能产生光滑的、物理上合理的解,还是可能在有限时间内发展出奇点(即速度场趋于无穷)。这一问题自19世纪以来困扰数学界,至今未有定论。AI代理集群的介入,本质上是将证明搜索转化为大规模计算问题,但其结果仍需严格的数学验证。
红队测试:同样的方法,不同的战场
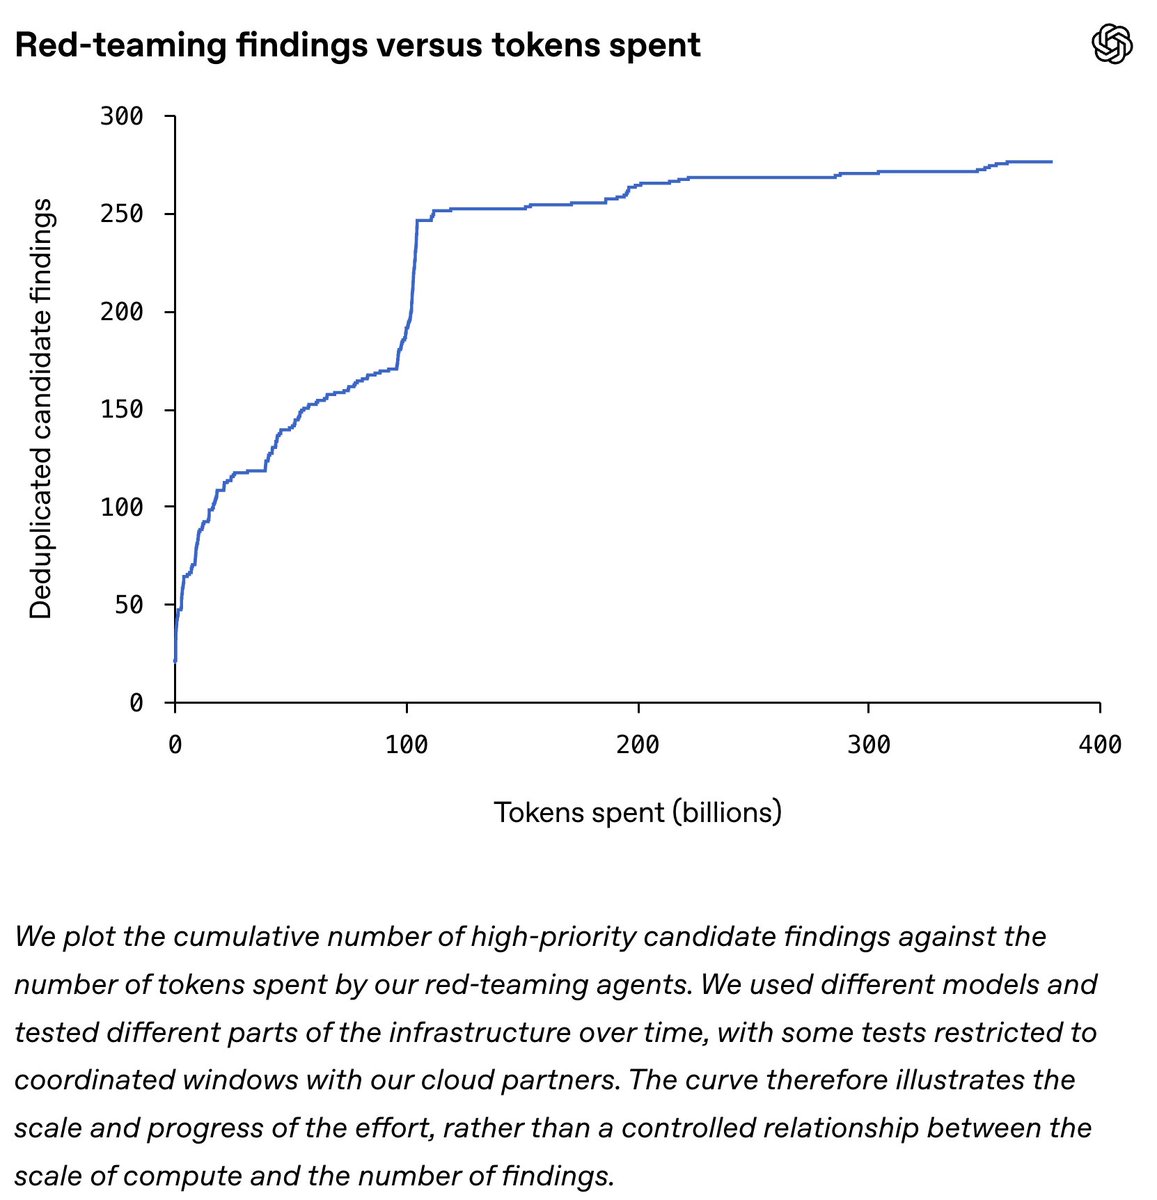
推文更引人注目的部分,是作者将同一套方法迁移到了基础设施红队测试。红队测试的核心目标是模拟攻击者行为,主动发现系统漏洞。传统红队测试受限于安全专家的时间和经验覆盖范围,而代理集群可以同时探测大量攻击面、生成多样化的攻击载荷,并快速迭代利用链。
这种迁移的合理性在于,数学证明搜索与漏洞挖掘在计算形态上有相似之处:两者都是在一个巨大的搜索空间中寻找特定模式,都需要大量试错与验证。代理集群的并行探索能力,恰好匹配这类任务的需求。
不过,推文没有提供任何关于漏洞发现数量、类型或修复效果的数据。这意味着我们目前只能将其视为一种方法论的宣告,而非可验证的成果。
红队测试(red-teaming)源于军事演习,指由独立团队扮演攻击者,主动探测系统弱点。在网络安全领域,红队测试通常包括渗透测试、漏洞挖掘、社会工程模拟等,目标是发现防御体系中的盲点。传统红队测试依赖安全专家的经验与创造力,覆盖范围有限且成本高昂。AI代理集群的引入,使得同时探测大量攻击面、生成多样化攻击载荷成为可能,但同时也带来了误报率高、结果验证困难等新问题。
规模化代理的隐忧与待解问题
百亿级Token的消耗也引出了现实问题。首先是成本:如此规模的推理开销对大多数组织而言并不现实。其次是结果的可解释性:当成千上万个代理产生海量中间输出时,如何筛选、验证并归因关键发现,本身就是一个工程挑战。
更深层的疑问在于质量与数量的关系。代理集群的产出是否只是“广撒网”式的穷举?在数学证明和漏洞挖掘这类需要精确性的领域,海量尝试可能带来大量噪声,而真正有价值的信号需要严格的验证机制来提取。推文对此未作说明。
对开发者的启示
尽管细节有限,这一信息仍传递出明确信号:多代理协作与大规模推理正在从实验走向实际任务。对于关注AI应用落地的团队,值得思考的是如何将“代理集群”的思路应用到自身领域——无论是代码审计、测试用例生成,还是复杂系统的故障排查。关键在于设计好任务分解、结果验证与成本控制的机制,而非盲目追求Token消耗的规模。
至于Navier-Stokes问题是否真的被AI代理“解决”,在没有正式论文与同行评议之前,保持审慎是必要的。
相关推荐
核战真能终结文明吗?科学解析常见误区
核战争会终结文明吗?本文基于核武器物理机制,解析爆炸、辐射尘与城市火灾的真实影响,区分空爆与地爆、剂量与污染,说明为何核战是巨大灾难却非文明终结,并探讨打击后社会重建的关键因素。

泰坦尼克号沉没真相:国家地理纪录片中的关键决策与通讯失灵
国家地理纪录片《The Unsinkable Ship》通过幸存者口述还原泰坦尼克号沉没前的关键决策:从MSG电报前缀缺失、锅炉房与舰桥通讯断裂,到“永不沉没”认知偏差如何延误损管与疏散。

74M参数开源模型在测试中部分超越Jev AI
Fastino AI 的 Glider 2.5 系列模型仅 7400 万到 3 亿参数,据 YouTube 实测在部分防护栏基准测试中超越 Jev AI,且可在消费级硬件运行,甚至用于玩《Doom》。本文分析小模型在特定任务上的竞争力与部署价值。