AI读取神经网络权重?先读懂方法再读标题

前沿智能体能读取和修复小型网络权重,但头条演示被高估,真正价值在于自动化ML调试循环。
文章剖析了《Sparks of Weight Space Programming》中宣称的AI权重编程能力。核心发现是:最抓眼球的Math 500提升(7.9%到48.1%)实验使用了Python和最多50批测试预算,而纯权重读取只在小规模网络上验证。游戏识别任务因输入有标签而难度被高估,三行NumPy即可复现。数学提升实为剪除循环方向,无法在少循环模型上生效。真正有价值的成果是前沿智能体在单会话内跑完ML工程师的调试循环,使小型开源模型的窄范围修复可能大幅降低成本。但权重修改对代码审查不可见,需将权重视为代码进行哈希、变更日志和版本管理。审读此类声明应关注方法表、工具使用、失败案例和独立复现。
一位研究者把 17,253 个数字——一个学会玩某款游戏的小型神经网络的权重——交给 GPT-6 Astra,让它猜是哪个游戏。四个网络全部猜对。这份代号《Sparks of Weight Space Programming》的工作由 Rikyei Tekhi、Jaden Teo、Alex Zhang 和 Omar Khadab 完成,宣称前沿模型能读取网络权重、修复权重,甚至从零写出新的权重。最抓眼球的结果是:在没有任何训练的情况下,Astra 只改动了某个小型模型 0.016% 的权重,就让它在 Math 500 基准上的得分从 7.9% 跃升到 48.1%。帖子在 Hacker News 上拿到接近 3,000 分,讨论热度可见一斑。
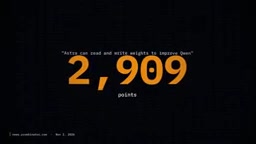
兴奋点之一在于它暗示的方向:递归自我改进,即模型检查并改进自身的权重。同一时期,Anthropic 更新的 IPO 文件提到,其对未来模型的预期显示,公司可能即将触及自己设定的"AI 导致显著加速进展"的门槛,但也明确表示当前没有模型跨过这条线。两件事放在一起看,很容易让人产生"奇点临近"的联想。但真正值得读的,是方法,而不是标题。
方法表暴露了什么
Matthew Honnable(Spacey 的创作者)把每个实验放进同一张表:网络有多大、模型是否读取原始数字、能否使用 Python、能否实际运行网络。结果很说明问题——"无工具、纯原始数字"的设置只出现在三个实验中,涉及的网络规模在 17,000 到 172,000 个权重之间。而那个惊艳的 Math 500 结果用了 Python,模型还能在最多 50 批练习题上实际运行网络。
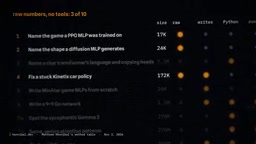
他的比喻很到位:这就像舞台魔术师用几种不同的手法表演同一个戏法。观众看到的是同一个结果,但每种手法的难度和含义完全不同。把"用 Python 跑网络"和"纯粹盯着数字猜"混为一谈,会严重高估模型的能力。
权重空间指的是神经网络所有可学习参数构成的高维空间。一个拥有 17,000 个权重的模型,其权重空间就是 17,000 维实数空间;而现代大模型动辄数千亿参数,权重空间维度可达千亿量级。所谓"读取权重",是指模型直接接收这串数字作为输入,并从中推断出网络的结构、功能或训练状态。这在实际中极其困难,因为权重向量对网络行为的映射高度非线性,且不同训练运行得到的权重排列可能完全不同(排列对称性)。这正是为什么"纯原始数字、无工具"的设置只在极小网络上被验证——维度越低,可推断的信息越有限但越可靠;维度越高,模型越可能依赖表面统计而非真正理解。
排列对称性(permutation symmetry) 是理解权重读取难度的关键概念。在神经网络中,交换同一层内两个神经元的全部输入权重和输出权重,网络的整体功能完全不变。这意味着同一个功能可以由指数级多种权重排列实现。对于权重读取任务,模型不能简单记忆"第 3 个权重对应某个特征",而必须学会对排列不变的表示。这也是为什么从零生成权重比修复现有权重更难:生成需要选定一种与训练分布一致的排列,而修复只需在已有排列上做局部调整。
为什么游戏识别没那么神奇
Sean Godecki 补充了一个更简单的观点:那些游戏网络的输入是有标签的——智能体、移动物体、奖励目标。所以"每个通道关注哪些网格单元"是很容易计算出来的。他用三行 NumPy 代码跑在公开的吃豆人权重上,就复现了视频开头展示的迷宫图。换句话说,游戏识别这个"头条演示"本身的难度可能被高估了。
至于数学提升,Godecki 指出那个模型本来就不算差,只是在长回答里陷入循环。Astra 找到了循环背后的方向并把它剪掉——这更像是一个称职的研究者会做的事,而不是什么超自然能力。编辑权重可以解锁模型已经具备的能力,但无法凭空添加新能力。作者自己也承认这一点:在很少陷入循环的 Gemma 上,同样的方法没有改变分数。
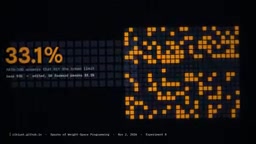
循环(repetition loop) 是语言模型在生成长回答时的一种常见失败模式:模型反复输出相同或高度相似的短语、句式或推理步骤,无法自行跳出。在数学基准如 Math 500 上,这种循环会浪费大量 token 并导致最终答案错误。Astra 所做的"剪除循环方向",本质是在权重空间中找到一个与循环行为相关的低维方向,并沿该方向做微小扰动(仅 0.016% 的权重)。这类似于权重编辑(weight editing) 或模型手术(model surgery) 的思路:不重新训练,而是定位并修改与特定行为相关的参数子集。这类方法能解锁模型已有但被抑制的能力,却无法创造训练数据中不存在的新能力——这解释了为什么在很少陷入循环的 Gemma 上同样操作无效。
Math 500 是衡量数学推理能力的常用基准,包含 500 道竞赛风格数学题,答案通常要求精确匹配。基线 7.9% 意味着模型在绝大多数题目上失败,而 48.1% 表明修复后模型能正确解答近半题目。但需要注意,这一提升是在允许模型使用 Python 并在最多 50 批练习题上实际运行网络条件下取得的,并非纯粹的权重读取或零样本推理。
独立复现的冷水与温度
Simon Willison 在自己的笔记本上用 Qwen 3.8B 试了游戏提示。46 分钟、43,000 个推理 token 之后,它认出了吃豆人,然后是 Pong,再是 Breakout,但漏掉了 Freeway。他的结论是:令人印象深刻,但一个拿着记事本和铅笔的有经验人类大概也能做到。
这不是贬低,而是校准。把这些实验放在正确的参照系里,才能判断它到底推进了什么、没有推进什么。
真正发生了什么
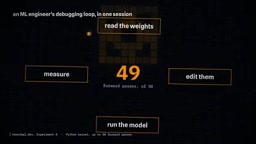
不是超人类的权重读取。是一件更实用的事:一个前沿智能体,在给定 Python 和测试预算的情况下,在一个会话里对小型模型跑完了机器学习工程师的调试循环。这确实有用——对小规模开源模型的窄范围修复可能变得便宜得多。
但另一面是:模型文件现在成了智能体可以修改的东西。那次 Qwen 编辑触及 8 亿个权重中的 13.1 万个,任何代码审查都看不出来。作者甚至提出了反向用法:让模型审计权重中隐藏的问题,比如后门,而无需运行任何测试。
权重后门(weight backdoor) 是指在模型训练过程中被植入的恶意行为,触发条件可能是一个特定输入模式,平时模型表现完全正常。由于后门编码在权重中而非代码中,传统的代码审查、输入输出测试甚至部分红队测试都难以发现。作者提出的反向用法——让智能体审计权重中隐藏的问题——正是利用模型直接读取权重的能力,在不运行测试的情况下检测异常参数模式。这与传统的模型扫描(model scanning) 方法互补:后者通常依赖激活分析或特定触发器搜索,需要大量前向传播;而权重空间审计理论上可以在零推理成本下进行,尽管其可靠性仍有待验证。
哈希与变更日志 在权重管理中的必要性源于一个事实:模型文件是二进制大对象,传统 diff 工具无法给出有意义的差异。对权重文件做密码学哈希(如 SHA-256)可以确保部署的模型与审核通过的版本完全一致;记录每次智能体修改的变更日志(包括修改了哪些参数、修改量、修改前后的评估结果)则提供了可追溯性。保留原始版本用于回滚,是应对权重被意外或恶意修改的最后防线。这套实践借鉴了软件供应链安全中的制品(artifact)管理 思路,将模型权重视为需要版本控制、签名和审计的软件制品。
如何审读这类声明
在基于这类声明构建东西之前,可以按五步走:第一,找方法表,不要只读摘要;第二,问模型用了什么工具、能否运行它正在修改的东西;第三,找失败案例——失败会告诉你边界在哪里;第四,等待独立复现;第五,如果你的部署环境里智能体可以编辑模型,就把权重当代码对待——做哈希、记录变更、保留原始版本以便回滚。
有趣的部分从来不是标题,而是方法。
相关推荐

Claude Code 安装与防封号配置指南
Claude Code 国内安装教程:NPM 方式稳定安装,用 ccswitch 配置第三方模型绕开官方登录防封号,详解四种权限模式与提示词进阶技巧,助你安全高效使用 AI 编程工具。

十年民粹主义为何席卷全球?媒体结构是关键推手
Vox与《大西洋月刊》深度对话:十年民粹主义为何崛起?从广播、电视到社交媒体与AI,媒体结构的变迁如何成为民粹浪潮的关键推手。特朗普的权力悖论、拜登的通胀困境与未来走向全解析。

LLM推理引擎怎么选?七大主流方案全解析
七个主流LLM推理引擎怎么选?本文整理Llama CPP、MLXLM、XLama V3、Hugging Face Transformers、VLLM、SGLang、LMDeploy和TensorRT-LLM的优化方向与适用场景,帮你按CPU、GPU并发、显存受限和NVIDIA数据中心快速定位合适方案。