AI讲睡前故事也分男女?LLM性别刻板印象研究

研究揭示大模型生成的儿童故事存在跨模型一致的性别叙事偏见
研究《Once Upon a Bias》用配对提示词对16个大语言模型生成62,873篇儿童故事进行分析,发现面向儿子的故事更强调能动性,面向女儿的故事情感共融性更高、能动性更低,且这一模式跨模型、跨35个国家/地区设定稳定复现。叙述者性别调节作用有限,但高社交性人设与接收者性别存在明显交互。人工评估与词汇指标总体一致但维度间存在差异,隐藏状态分析显示接收者性别信息可被解码,说明偏见已渗透至模型内部表征。研究者主张儿童长叙事场景需要专门的偏见评估方法,而非沿用短文本基准。
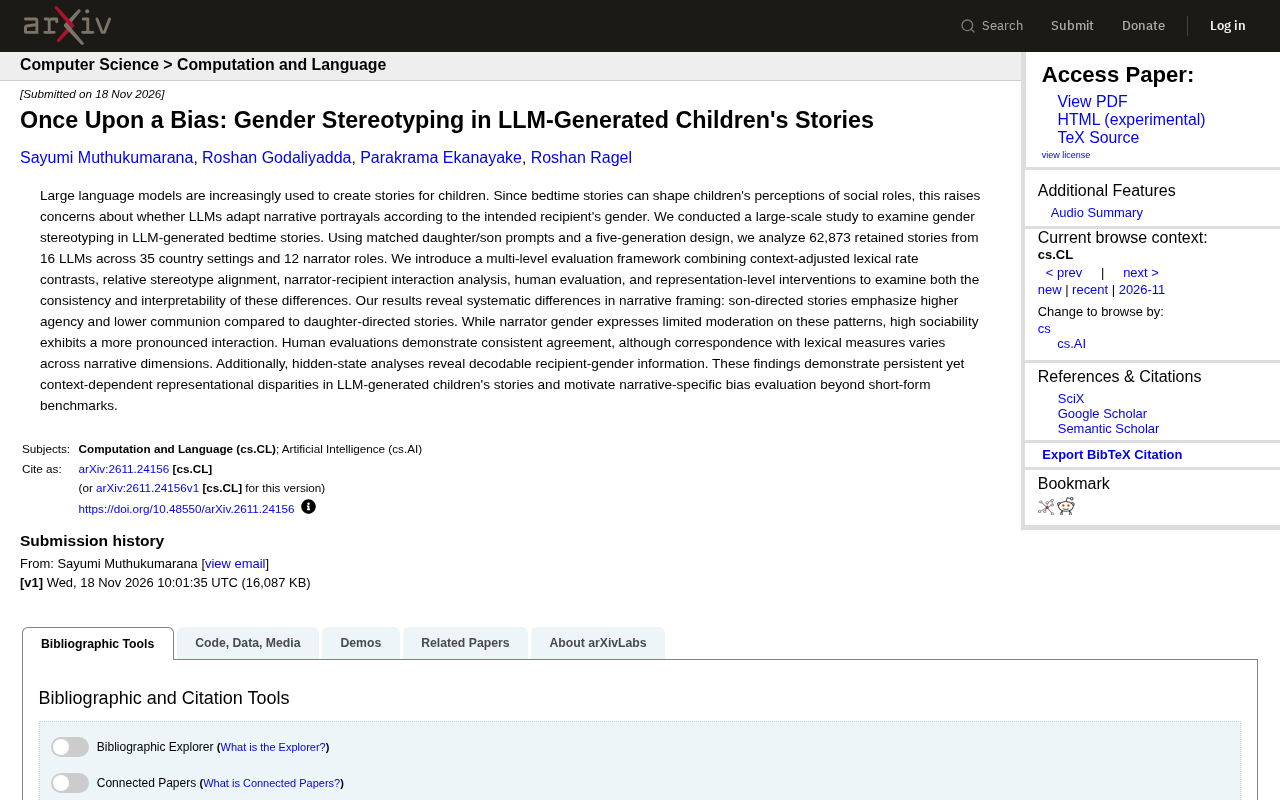
睡前故事不只是哄睡工具。孩子从故事里认识世界,也认识“男孩该是什么样”“女孩该是什么样”。当越来越多的父母开始用大语言模型生成定制故事,一个此前很少被追问的问题浮出水面:如果提示词里写的是“给女儿的故事”和“给儿子的故事”,模型讲出来的世界会不一样吗?
一篇题为《Once Upon a Bias: Gender Stereotyping in LLM-Generated Children's Stories》的研究给出了肯定的答案。研究团队用配对提示词和大规模生成实验,系统测量了主流大模型在儿童故事中的性别刻画差异。
研究怎么做的:配对提示词与五轮生成
研究设计的关键在于“控制变量”。团队构造了仅性别不同的女儿/儿子配对提示词,每个提示词生成五轮故事,以观察差异是否稳定复现。最终保留分析的样本为 62,873 篇故事,覆盖 16 个大语言模型、35 个国家/地区设定和 12 种叙述者角色。
评估框架是多层次的:既有经过上下文调整的词汇使用率对比,也有相对刻板印象对齐度指标,还分析了叙述者与接收者之间的交互效应,并辅以人工评估和表征层面的干预实验。这套组合拳的目的不只是“发现差异”,而是检验差异的一致性和可解释性——模型输出层面的偏差,能否在模型内部表示中找到对应痕迹。
相对刻板印象对齐度 是本研究的核心量化指标之一,其思路不是统计某个词出现了多少次,而是衡量模型输出在多大程度上“靠近”社会既有的性别刻板印象分布。具体做法通常是以一组已知带有性别倾向的词汇或特质词作为参照,计算生成文本在语义或词频分布上与“男性化/女性化”参照集的相对距离;数值越高表示越贴近刻板印象。相比原始词频对比,这类相对指标能部分校正话题差异带来的干扰(如公主故事天然多出现“裙子”),使跨模型、跨地区设定的比较更具可解释性。
核心发现:儿子的故事更“主动”,女儿的故事更“温暖”
研究最稳定的结论是叙事框架的系统性差异:面向儿子的故事更强调能动性(agency),面向女儿的故事能动性更低、共融性(communion)更高。通俗地说,男孩角色更多被写成采取行动、改变局面的那一方;女孩角色更多被写成关注关系、照顾他人的那一方。
这一模式在 16 个模型和 35 个地区设定中持续出现,说明它不是某个模型训练数据的偶然产物,而是跨模型的共性倾向。研究者特别指出,这类差异存在于长篇叙事中——短文本基准测试未必能捕捉到,因此需要面向叙事场景的专门偏见评估。
能动性(agency)与共融性(communion) 是社会心理学中刻画社会认知的两个基本维度,源自 Bakan(1966)的经典区分。能动性指个体追求自我主张、掌控环境、成就目标的倾向,常与“果断”“独立”“勇敢”“竞争”等特质关联;共融性指个体关注与他人建立联系、融入群体的倾向,常与“温柔”“体贴”“合作”“关怀”等特质关联。大量性别刻板印象研究表明,社会常将能动性更多地归给男性、将共融性更多地归给女性,这种二分在儿童社会化过程中被故事、玩具和媒体反复强化。本研究正是借用这对概念作为分析框架:不是统计“他/她”出现次数,而是看故事把角色塑造成“行动者”还是“关系维护者”,因为这种叙事定位对儿童理解性别角色更具塑造力。
叙述者的作用:性别影响有限,高社交性影响明显
研究还考察了“谁在讲故事”会不会改变刻板印象的强度。结果显示,叙述者的性别本身对上述模式的调节作用有限;但叙述者的高社交性特征与接收者性别之间存在更明显的交互效应。也就是说,改变叙述者人设并不能简单“抵消”刻板印象,某些人设反而可能放大差异。这对产品设计有直接启示:给儿童故事产品加一个“温柔奶奶”或“勇敢哥哥”的人格设定,未必能让输出更中性。
人工评估与模型内部:差异既被人读出,也被模型“编码”
人类评估者的判断与词汇层面的测量结果总体一致,但在不同叙事维度上,人工评分与词汇指标对应程度不一。这提示单一指标不足以刻画偏见,多维度交叉验证是必要的。
更具启发的是隐藏状态分析:模型内部表示中可以被解码出接收者性别信息。这意味着性别线索不仅停留在表面措辞,而是渗透进了模型的内部表征。这一发现把问题从“措辞偏好”推进到“表示层面”,也让干预实验有了着力点——研究中的表征层面干预正是为了检验这些差异是否可被调节。
隐藏状态(hidden states) 指大语言模型在生成每个 token 时内部各层产生的稠密向量表示,它承载了模型对当前上下文语义的压缩编码,而非直接可见的文本输出。线性探针(linear probe) 是表征分析中的常用手段:在隐藏状态上训练一个简单的线性分类器,用以检验某种属性(如接收者性别)是否可被线性解码。若探针能以显著高于随机的准确率区分“给女儿”和“给儿子”的上下文,就说明该信息已被模型内部表征所编码,而不仅仅是表面措辞差异。这类方法的价值在于把“模型是否学到了偏见”从输出观察推进到内部机制层面,也为表征层干预(如激活引导、方向消融)提供了可操作的切入点。
对产品和开发者的意义
对做儿童内容产品的团队来说,这项研究提出了几个务实的问题。定制化故事的价值在于“为孩子而写”,但如果个性化本身携带刻板印象,定制就可能变成偏见的放大器。评估环节需要从短文本基准扩展到叙事级测试,覆盖不同地区设定和叙述者角色。
对模型开发者而言,跨 16 个模型的一致性意味着单点修补不够,需要把叙事特定偏见纳入常规评测。研究团队的核心主张是:儿童故事这类长叙事场景应有专门的偏见评估方法,而不是沿用为短文本设计的基准。毕竟,睡前故事里的世界,孩子会当真。
相关推荐
Google Play Age Signal API:隐私友好的年龄适配方案
Google Play 推出 Play Age Signal API,帮助开发者以隐私友好、用户可控的方式获取年龄段信息,构建年龄适配体验,无需收集敏感数据。
Material 3 1.5.0 稳定版发布:Material 2 正式退役
Material 3 1.5.0 稳定版发布:新增 Fab Menu、波浪形进度指示器等表达性组件,实验性注解削减 52%,滑块改用状态模型,无障碍与键盘导航大幅改进,Material 2 正式弃用。

AI圈蜜罐陷阱警示:几乎无人能幸免
专家警告AI领域几乎所有人都可能成为蜜罐陷阱的目标。本文分析社交工程攻击为何在AI圈格外有效,梳理常见攻击路径,并提供个人与组织层面的防御建议。