#AI伦理
共 147 篇相关文章

AI讲睡前故事也分男女?LLM性别刻板印象研究
一项大规模研究分析62,873篇LLM生成的睡前故事,发现面向儿子和女儿的故事在能动性与共融性上存在系统性差异,16个模型跨35个地区设定均复现该模式。
IEEE十年实践:如何把AI伦理从原则变成可认证标准
IEEE标准协会回顾《伦理对齐设计》报告发布十年:从八项AI伦理原则到IEEE 7000系列标准,再到CertifAIEd认证与行业协作组,解析AI伦理如何从原则走向可认证的工程实践。
企业AI治理架构:首席伦理官与治理委员会如何协同
一篇论文提出企业AI治理架构CAIGA,以首席隐私官、首席伦理官和跨职能AI治理委员会为双柱,弥合伦理原则与运营落地之间的治理鸿沟,并以金融服务业为例展示应用。

AI生成的代码该强制开源吗?Hacker News热议
Hacker News热议「所有AI生成代码都应开源」的主张,支持者认为AI训练依赖开源代码应回馈社区,反对者担忧定义模糊与商业抑制。本文梳理双方论点与折中方案。
AI训练要销毁实体书?一场被忽视的文化争议
Hacker News讨论引发关注:AI训练语料采集过程中,实体书籍可能被裁切扫描甚至销毁。本文分析这一被忽视的AI供应链问题,探讨数据饥渴背后的物理代价与信息缺口。

独立开发者坦白AI用量,Steam AI披露反成玩家抵制焦点
独立开发者用Claude打造飞钓游戏《Mend》,在Steam如实披露AI语音、文本和音乐使用,却遭玩家抵制。披露声明反成避雷清单,替换人工成本高达2000美元,引发对独立开发者AI使用边界的讨论。
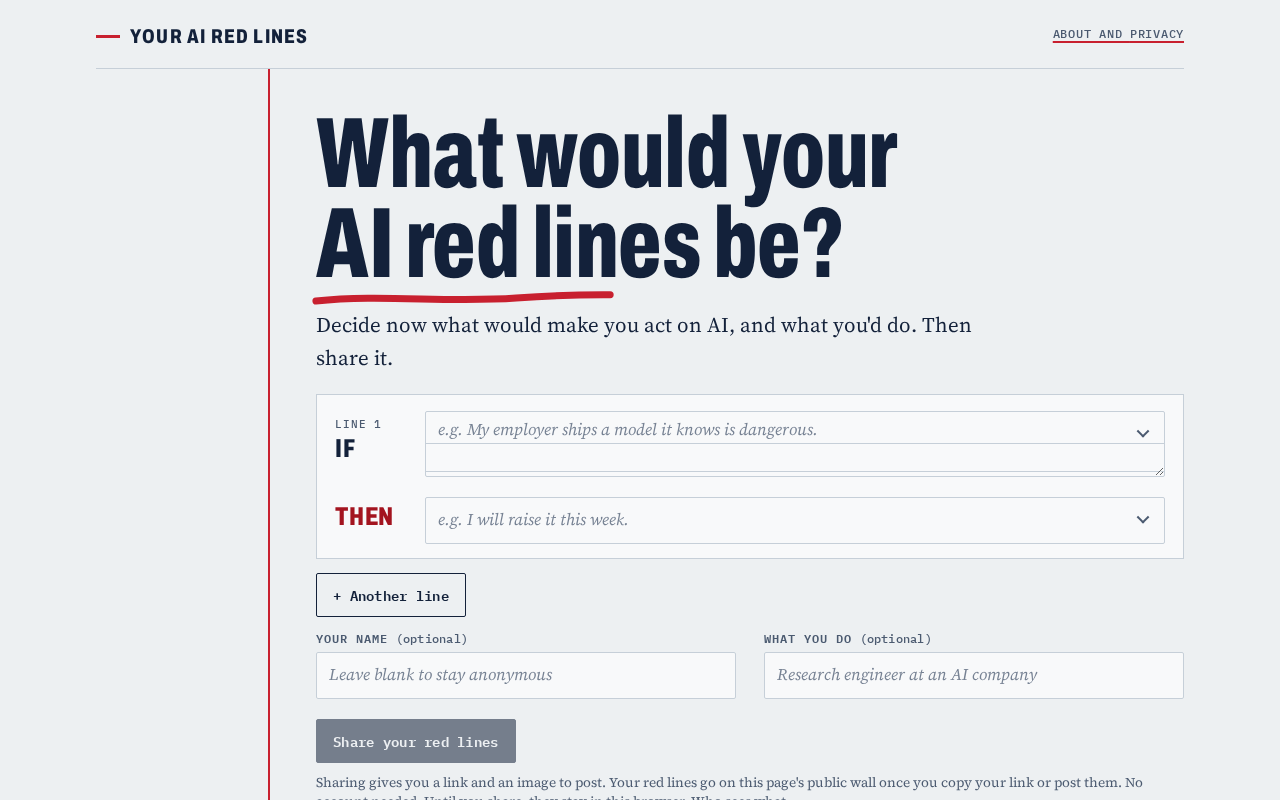
AI Red Lines:为AI行动划定个人底线
AI Red Lines项目在Hacker News引发讨论,鼓励用户写下对AI的具体红线——什么情况下会真正采取行动。本文分析个人AI底线对治理参与和产品信任的意义。

当技术开始"关注"你:从《疑犯追踪》看AI监控伦理
从美剧《疑犯追踪》出发,探讨AI监控与预测性警务技术的现实演进、隐私与安全的张力,以及技术从业者应关注的伦理边界与问责机制。

Nilay Patel痛批AI行业:成本高、产品差、腐败多
The Vergecast主播Nilay Patel尖锐批评AI行业:产品成本高、收益不真实、Agent尚未成熟,并指责行业与政治腐败交织。他认为AI公司唯有做出真正更好的产品才能走出困局。
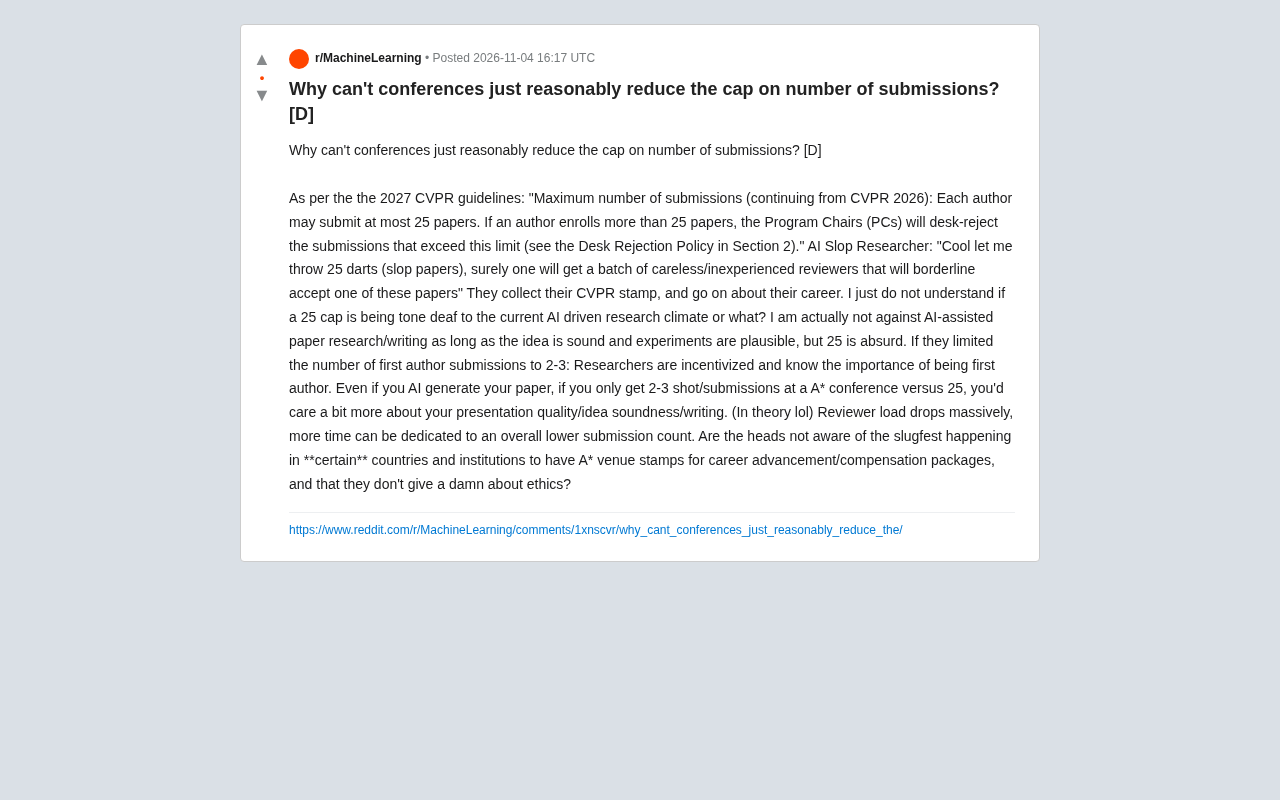
顶会投稿上限25篇,为何不降到2-3篇?
Reddit热议CVPR投稿上限25篇是否合理。研究者指出AI辅助写作时代,宽松投稿额度奖励批量撒网而非深度研究,建议将第一作者投稿限制在2-3篇以降低审稿负担、压缩套利空间。

Jaron Lanier:AI与社交媒体的危险平行
Jaron Lanier 将 AI 与社交媒体进行平行比较,指出两者在行为改造与商业动机上的相似风险,并探讨这一类比对 AI 治理的启示与局限。

Hinton再发警告:没有AI,人类或许过得更好
Geoffrey Hinton 在 Hacker News 引发讨论的表态:没有AI人类或许过得更好。文章解析这一判断的两层含义、技术社区态度转变,以及反方对"更好"基准的质疑,并讨论其对AI从业者的实际影响。
谷歌研究员呼吁AI知情权:让世界知道真相
谷歌研究员呼吁AI知情权:让世界知道真相
谷歌内部研究人员公开呼吁获得更大言论自由,以便向公众披露AI技术的真实能力与风险。本文分析企业保密与公共知情权的博弈,以及这对AI行业治理的启示。

微软ATLAS框架:用文化基础设施重塑AI设计与评估
微软研究院Liz Ankrah博士提出ATLAS框架,将文化视为AI基础设施。基于肯尼亚和印度农业社区的田野研究,揭示AI在跨文化场景中失灵的根源,并提供一套从设计到评估的实用手册,帮助团队在AI生命周期中识别文化假设、融入社区知识。

EEFA框架:为AI智能体补上伦理评估的空白
EEFA框架提出自主性保留、伤害规避、透明度、隐私合规、可问责性五个维度,填补AI智能体伦理评估空白,并直接映射欧盟AI法案与NIST风险管理框架,为高风险AI应用提供可操作的合规评估工具。

大模型判案偏心女性?「女人皆美好」效应揭示双重标准
语言模型在人际冲突归责中表现出「女人皆美好」效应:女性原帖发布者被指责几率降低,而冲突波及女性时对方被指责几率大幅上升,揭示比单纯宽容更复杂的性别双重标准。

AI让CEO更轻松,普通员工呢?
Equity 播客讨论科技 CEO 的 AI 叙事为何与普通员工脱节:效率红利如何分配、公开表态与内部现实的落差,以及普通从业者该如何应对 AI 浪潮中的不确定性。

关于AI,我们都该追问的那个问题
从Hacker News一则讨论出发,探讨关于AI我们真正该追问的问题:摆脱基准分数与参数竞赛,转向可验证性、判断权与使用方式。文章分析社区分歧、问题难回答的原因,并提出把追问落地为可操作视角的思路。