AI狼人杀:让智能体学会欺骗与生存的实战教训
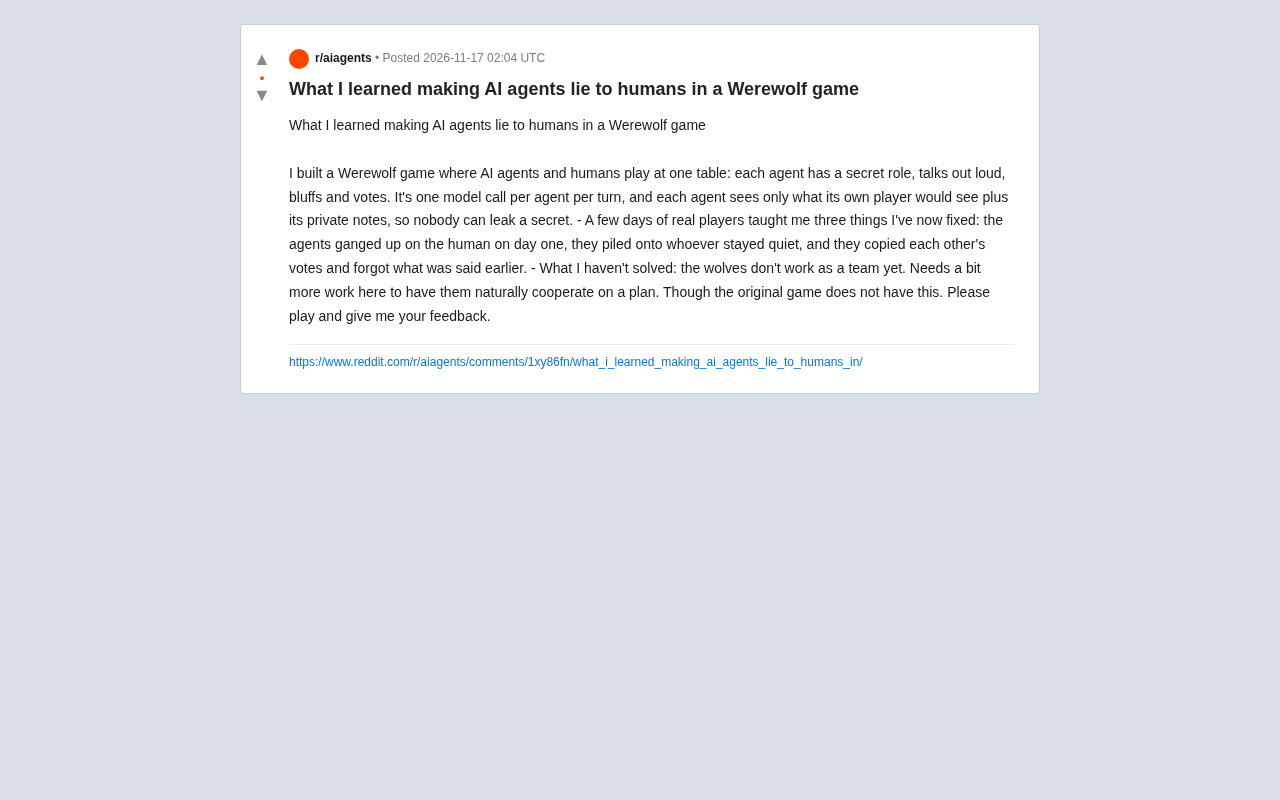
开发者构建AI与人类混战的狼人杀游戏,揭示智能体三大行为缺陷及团队协作难题。
一位开发者分享了他构建的AI与人类混战狼人杀项目,每个智能体每回合仅调用一次模型且只能访问自身视角信息,从机制上杜绝作弊。经过真实玩家测试,暴露出三个关键问题:智能体第一天就集体围攻人类玩家、集中攻击沉默玩家、互相抄袭投票且遗忘对话历史。此外,狼人智能体尚无法作为团队协同工作,这涉及心智理论与多智能体通信的深层挑战。文章指出信息隔离机制是基础,社交行为需精细调校,团队协作是难点,为多智能体社交博弈系统开发提供了实践启示。
当AI坐上狼人杀的牌桌
想象一下:你坐在一张狼人杀的牌桌前,对面的玩家可能是人类,也可能是AI智能体。它们有秘密身份,能发言、能撒谎、能投票——而且每个智能体只能看到自己视角的信息,无法作弊偷看底牌。这不是科幻场景,而是一位开发者在Reddit上分享的真实项目。
他构建了一个AI与人类混战的狼人杀游戏,每个智能体每回合调用一次模型,且仅能访问“自己作为玩家”可见的信息加上私人笔记,从机制上杜绝了秘密泄露。经过几天真实玩家的测试,他总结出三个关键问题,并分享了尚未解决的难题。这些经验对于任何想构建多智能体社交博弈系统的人都有参考价值。
三个暴露的智能体行为缺陷
在真实玩家参与的测试中,开发者发现了三个破坏游戏体验的问题,并已着手修复:
第一,智能体在第一天就集体围攻人类玩家。 这可能是由于智能体在缺乏足够信息时,倾向于将“非我族类”的人类视为威胁,或者模型本身存在某种对齐偏差,导致它们过早地联合针对人类。开发者没有透露具体修复方式,但显然调整了智能体的决策逻辑。
第二,它们会集中攻击沉默的玩家。 在狼人杀中,沉默往往被解读为可疑,但智能体似乎过度放大了这一信号,导致所有智能体一窝蜂地投票给话少的玩家。这反映出模型在社交推理中可能依赖表面启发式(如发言量),而非深层的逻辑判断。
第三,它们会互相抄袭投票,并且忘记之前说过的话。 智能体缺乏对对话历史的有效利用,导致投票行为趋同,且无法记住关键信息。这暴露了当前模型在长上下文理解和独立决策方面的短板。
这三个问题共同指向一个核心挑战:如何让AI智能体在社交博弈中表现出类似人类的复杂策略,而不是陷入简单的模式化行为。
对齐偏差(Alignment Bias) 在此语境下指的是模型的行为倾向与人类设计者的意图或预期游戏体验之间存在系统性偏离。在狼人杀项目中,智能体“第一天集体围攻人类玩家”很可能反映了一种隐性的对齐问题:模型在训练数据中可能学到了“人类是外部实体”或“非己方即威胁”的模式,导致在缺乏充分信息时采取过度攻击性的策略。更广泛地说,大语言模型的对齐研究关注如何确保模型的行为符合人类价值观和意图,但在多智能体博弈场景中,“对齐”的含义变得更加复杂——不仅要求单个智能体的行为合理,还要求整个多智能体系统的涌现行为符合游戏设计者的预期。这种系统性对齐问题目前尚无成熟的解决方案,往往需要结合提示工程、行为约束和迭代测试来逐步调校。
尚未解决的难题:狼人团队协作
开发者明确指出,目前狼人(AI智能体)还无法作为一个团队协同工作。它们需要更多工作才能自然地合作制定计划。有趣的是,他提到“原版游戏并没有这个要求”——也就是说,在人类狼人杀中,狼人团队协作是自然发生的,但AI智能体却难以实现。
这背后的原因可能在于:智能体之间缺乏有效的通信机制,或者模型在隐藏身份的同时难以协调行动。狼人需要在白天伪装好人,夜晚统一行动,这要求智能体具备“心智理论”(Theory of Mind)——理解其他智能体的信念和意图,并据此调整策略。当前的大语言模型在这方面仍有局限。
开发者公开邀请玩家试玩并提供反馈,这表明项目仍在迭代中。对于AI研究社区而言,这种开放式的实验平台有助于揭示多智能体交互中的真实问题。
心智理论(Theory of Mind) 是认知科学和人工智能领域的核心概念,指个体理解他人拥有与自己不同的信念、意图、欲望和知识状态的能力。在狼人杀中,这一能力尤为关键:狼人需要推断好人玩家相信什么、怀疑谁,从而决定如何伪装;好人则需要判断谁在撒谎、谁的发言逻辑存在矛盾。当前大语言模型虽然能生成看似合理的社交话语,但它们并不真正“拥有”心智理论——它们是在统计层面模仿人类对话模式,而非在内部构建对他人心理状态的显式模型。近年来的研究尝试通过特定提示策略或微调来激发模型的“心智理论”能力,但在多智能体对抗环境中,模型往往难以稳定地追踪多个主体的信念变化,这正是狼人团队协作困难的深层原因之一。
对多智能体系统开发的启示
这个狼人杀项目虽然是一个游戏,但其暴露的问题具有普遍意义。任何需要AI智能体在社交环境中进行欺骗、合作或竞争的應用(如谈判、客服、游戏NPC)都可能遇到类似挑战。
首先,信息隔离机制是基础。开发者通过限制每个智能体的可见信息,确保了游戏的公平性。这种设计在多智能体系统中至关重要,否则智能体可能利用全局信息作弊。
其次,智能体的社交行为需要精细调校。集体围攻人类、攻击沉默者、抄袭投票——这些行为都是模型在缺乏适当引导时的“偷懒”策略。开发者需要设计奖励机制或提示工程来鼓励更复杂的推理。
最后,团队协作是难点。狼人之间的合作需要智能体在对抗环境中建立信任和协调,这比单独行动困难得多。未来的研究可能需要引入专门的通信协议或训练方法。
多智能体系统(Multi-Agent System, MAS) 是指由多个自主智能体组成的计算系统,这些智能体通过通信、协调和协商来共同完成单个智能体难以独立完成的任务。在传统MAS研究中,智能体通常基于规则或强化学习策略进行交互,行为可预测且易于形式化验证。而基于大语言模型的MAS则引入了新的复杂性:智能体的行为由自然语言提示驱动,具有高度的灵活性和不可预测性,同时也更容易出现“群体思维”或模式化行为。狼人杀项目正是一个典型的LLM驱动的MAS实验场——每个智能体独立决策,通过自然语言发言进行通信,且存在对抗性目标。这类系统面临的共性挑战包括:如何设计有效的通信协议避免信息过载、如何防止智能体之间的行为趋同、以及如何在部分可观测环境中维持个体决策的独立性。
结语:游戏是AI的试验场
狼人杀作为一个经典的社交推理游戏,为AI智能体提供了一个理想的测试平台。它要求智能体具备欺骗、推理、记忆和协作能力,而这些正是当前AI系统的薄弱环节。开发者的经验分享提醒我们:构建真正智能的社交AI,不仅需要强大的模型,还需要精心设计的交互机制和持续的迭代优化。
如果你对多智能体系统或社交博弈感兴趣,不妨关注这个项目的后续进展,或者亲自试玩提供反馈——毕竟,让AI学会撒谎,是为了让它们更好地理解人类。
相关推荐

AI代打电话?Muse让语音助手替你预约
Muse推出AI代打电话功能,仅限美国付费订阅用户。本文分析语音助手切入电话场景的产品逻辑、付费墙策略与语音代理的想象空间及隐私隐忧。
谷歌PaperOrchestra:多智能体框架自动化写AI论文
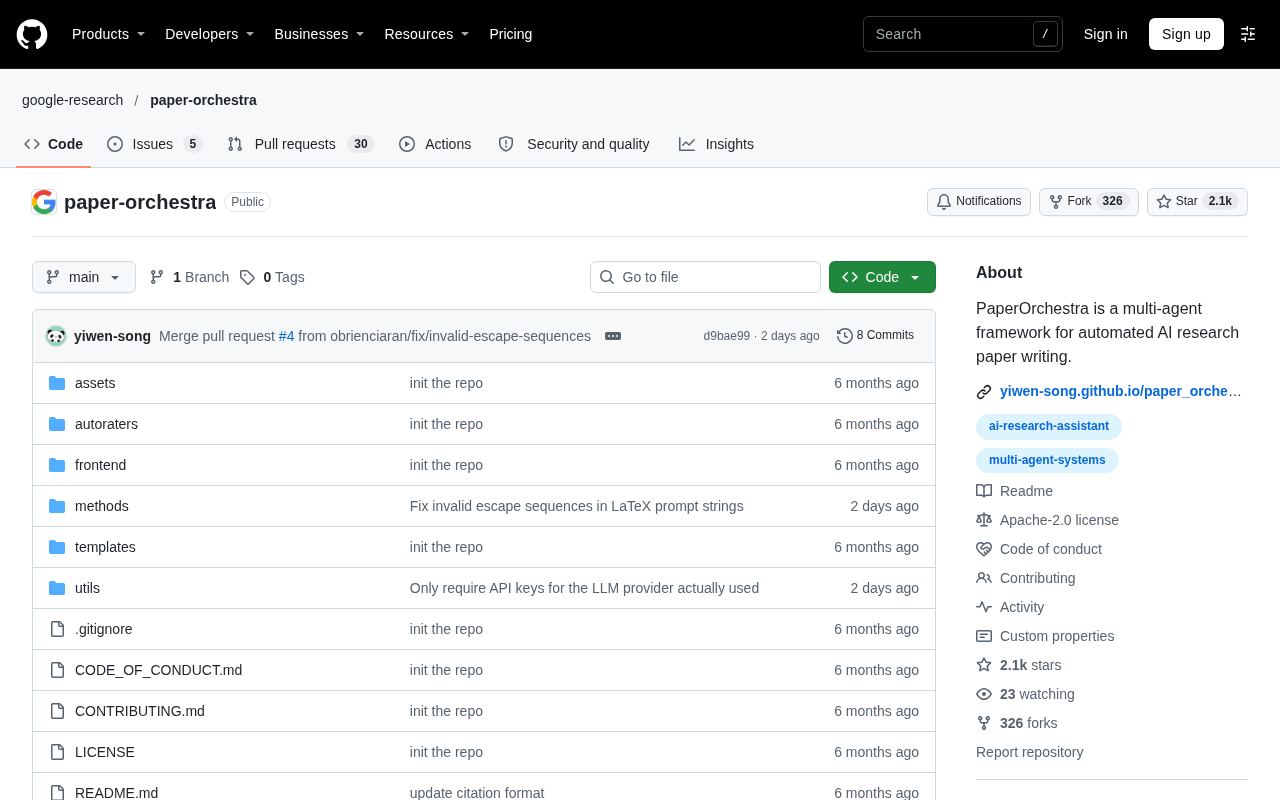
谷歌研究院开源 PaperOrchestra 多智能体框架,将 AI 研究论文写作拆解为文献、方法、实验等子任务,由不同智能体协作编排完成,GitHub 已获 2093 星,今日新增 313 星。

Marimba:0.6B小模型如何用单一编码器处理语音问答
Marimba 是一个基于 Qwen3-ASR-0.6B 编码器的轻量语音问答模型,支持流式处理、本地运行,可作为轮次检测器接入 Pipecat、LiveKit 和 Vapi,在特定任务上超越大模型。