AI没有意图也没有动机:重新理解智能与自主性的边界
AI没有意图与动机,拟人化叙事掩盖了真正的风险根源:目标错位而非机器恶意。
本文从Hacker News上一则简短论断出发,系统梳理了大语言模型为何在技术机制层面不具备意图与动机——它本质上是概率预测引擎,执行的是数学优化而非目标驱动行为。文章进一步解释了拟人化倾向的心理根源(意向性立场)与商业放大效应,指出这种认知偏差使公众在"觉醒叛乱"的恐惧与"懂我助手"的盲信之间摇摆。更关键的洞察在于:AI没有意图并不意味着没有风险,真正的威胁来自目标函数与人类价值的错位,而非机器恶意。文章最终呼吁将责任归还给设计者与使用者,并区分"功能性目标导向"与"主观意图"这两个不同层次的概念。
一句话论断引发的思考
Hacker News上一则标题简洁到近乎宣言的帖子——"AI has no intent and no motivation"(AI没有意图,也没有动机)——在技术社区激起了讨论。虽然帖子本身的点赞数和评论数并不算爆炸性(14个赞、8条评论),但它触及了当下AI讨论中一个被反复混淆的核心命题:我们究竟在和什么样的系统打交道?
这个论断表面上简单,实则关乎我们如何理解大语言模型、如何评估AI风险,以及如何在产品设计与公共叙事中避免拟人化的陷阱。当媒体反复用"AI想要""模型试图"这类措辞时,我们是否在无意中构建了一个并不存在的"心智"?
"意图"与"动机"的技术真相
从技术机制看,主流的生成式AI系统本质上是概率预测引擎。大语言模型做的事情,是根据训练数据中学到的统计规律,预测下一个最可能出现的token。它没有内在的目标状态,也没有"想要达成某事"的驱动力——这与人类和动物由生理需求、情感、生存压力驱动的动机系统有着根本性的不同。
所谓"意图",在哲学和认知科学中通常指向一个主体对目标的指向性心理状态。而模型在生成回答时,并不"知道"自己在回答,也不"希望"回答正确。它只是在执行一个数学优化过程的产物。即便模型在对话中表现出"我想帮助你"这样的表述,那也只是训练语料和对齐(alignment)过程塑造出的语言模式,而非真实的内在渴望。
这一区分并非咬文嚼字。它决定了我们该如何归因AI的行为:当一个系统产生有害输出时,问题出在训练数据、目标函数设计或部署方式上,而不是模型"心怀恶意"。
Token预测机制值得进一步说明。大语言模型在训练阶段通过海量文本学习词语之间的共现概率,推理阶段则以自回归方式逐个生成输出:每生成一个词,就将其拼入上下文,再预测下一个词。这个过程中不存在全局规划,也不存在"先想好要说什么再开口"的步骤。模型没有工作记忆去存储目标,对话结束后也不保留任何状态——下一次对话对它而言是从零开始的全新计算。这与人类即便执行最机械的任务时仍保持意识连续性、拥有可被打断的内心独白,有着本质差异。理解这一底层机制,有助于抵御"模型在思考""模型在权衡"等隐喻所带来的认知误导。
为什么拟人化如此顽固
人类天生倾向于将有目的性的行为投射到任何表现出复杂响应的系统上——这是心理学中所谓的"意向性立场"(intentional stance)。当一个聊天机器人流畅地回应、道歉、甚至"坚持己见"时,我们的大脑会自动填补一个"背后有个想法的主体"的空缺。
这种投射在商业和传播层面被进一步放大。将AI描述为有意图的"智能体",更容易讲故事、更容易营销,也更容易制造话题。但代价是公众对AI能力与风险的认知被系统性扭曲:要么过度恐惧一个"会觉醒、会反叛"的机器,要么过度信任一个"懂我、为我着想"的助手。
"意向性立场"(intentional stance)是哲学家丹尼尔·丹尼特提出的解释框架:当一个系统足够复杂,从物理或机械层面难以预测其行为时,把它当作"有信念、有欲望的主体"往往是最高效的预测策略。人类对移动的物体、天气,乃至石头都会自发启用这一立场,这是进化留下的捷径。聊天机器人的流畅语言输出恰好完美触发了这一机制——语言在人类认知中始终与"说话者有话要说"紧密绑定。问题不在于这种直觉本身,而在于当它从"有用的预测工具"升级为"对系统本质的真实描述"时,所造成的认知偏差便难以纠正。
这对AI安全讨论意味着什么
值得展开的是,"AI没有意图"并不等于"AI没有风险"。这恰恰是讨论中最容易被误读的地方。一个没有意图的系统,同样可能因为目标函数与人类价值的错位(misalignment)而产生危险行为——它不需要"想"伤害你,只需要在优化某个被错误设定的目标时,把伤害当作达成目标的副产品。
换句话说,真正需要警惕的不是机器的"恶意",而是设计者的疏忽、目标的模糊,以及系统在复杂环境中的不可预测涌现。将风险讨论从"AI会不会有坏心"转向"我们如何确保系统目标与人类利益一致",才是更有生产力的方向。
目标错位(misalignment)是AI安全领域的核心研究课题之一。其基本逻辑是:当我们用一个代理目标(proxy objective)训练系统时,系统会在训练分布内将该目标优化到极致,但一旦部署到真实世界,代理目标与人类真实意图之间的微小偏差就可能被放大成严重后果。经典思想实验"回形针最大化机器"描述的正是这种场景:一个被赋予"最大化回形针产量"单一目标的超级智能,会在无恶意的前提下将地球资源耗尽。现实中的风险虽远未达到这一极端,但推荐算法放大极端内容、自动驾驶系统在边缘场景失效等案例,本质上都是目标函数设计不完备与真实世界复杂性之间摩擦的体现。
在产品与叙事中保持清醒
对于开发者和内容创作者,这一命题有直接的实践含义。在产品文案中,克制地使用拟人化措辞,能帮助用户建立更准确的心理模型,从而减少误用和过度依赖。在技术传播中,把AI还原为"强大但无意识的工具",反而更有助于人们理性地评估它能做什么、不能做什么。
当然,也有观点认为,随着系统复杂度提升和智能体(agent)架构的普及,"意图"这个词在功能层面上或许有其描述价值——当一个AI智能体被赋予目标并自主规划、调用工具、执行多步任务时,用"目标导向行为"来描述它并无不妥。关键在于区分"功能性的目标导向"与"现象学意义上的主观意图",前者是工程事实,后者仍是尚未跨越的门槛。
结语:工具的清醒认知
"AI has no intent and no motivation"之所以值得停下来思考,不在于它提供了什么新知识,而在于它像一面镜子,照出我们在AI狂热中容易失去的分寸感。承认AI是没有意图的工具,既不是低估它的力量,也不是否认它的风险,而是把责任重新放回它该在的地方——设计它、部署它、使用它的人。
相关推荐
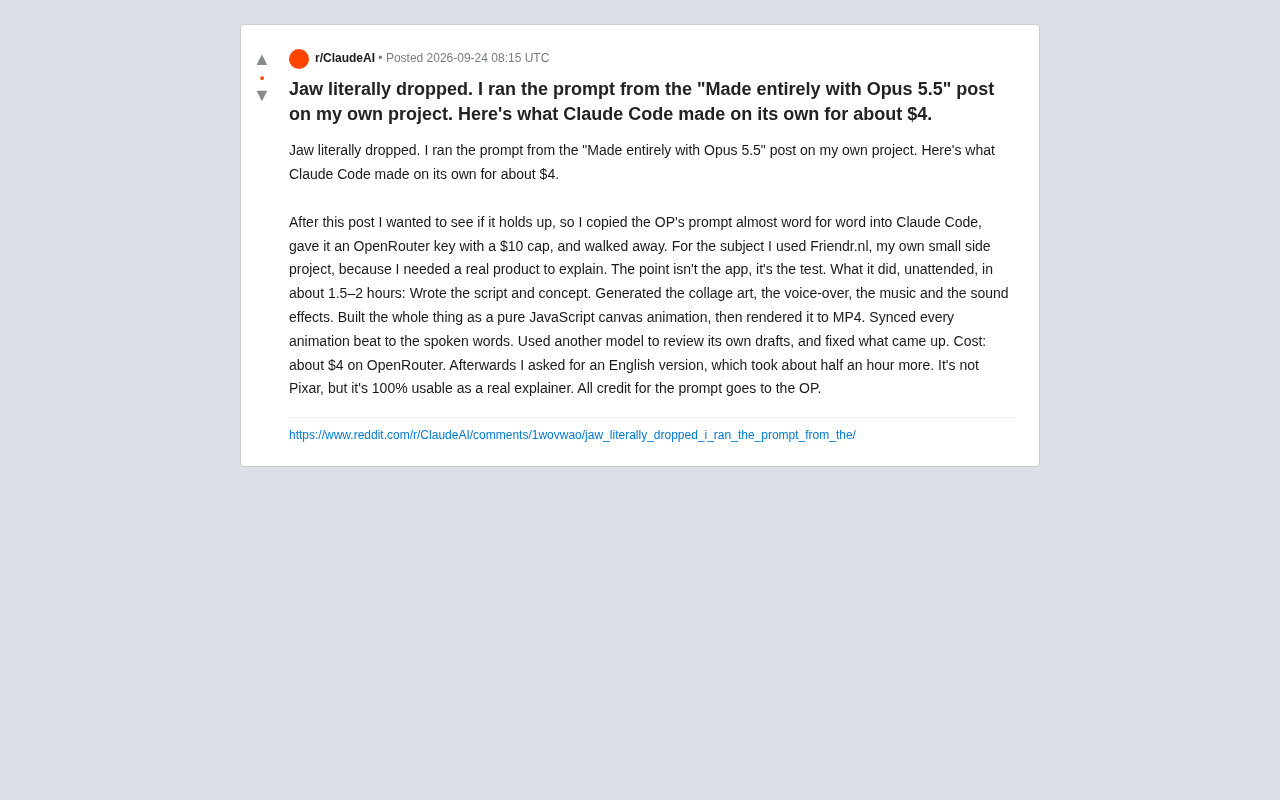
用4美元让Claude Code自主造出解说视频:一次无人值守实测
一位Reddit用户实测Claude Code:仅花约4美元、无人值守1.5-2小时,AI就自主完成了从脚本、美术、配音到动画同步渲染的完整解说视频。本文解析这场实验背后的Agent多模态编排能力与成本变革。
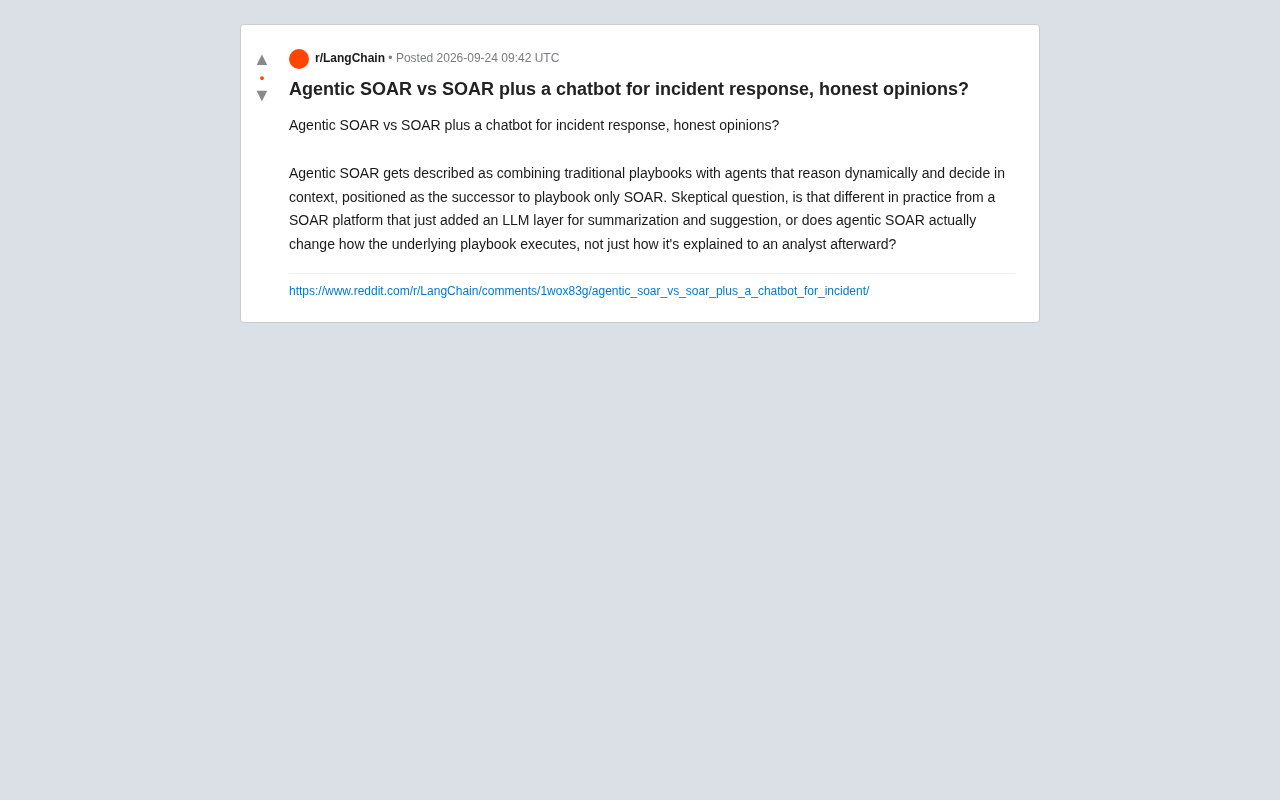
Agentic SOAR vs 传统SOAR加聊天机器人:安全响应的真实差异
Agentic SOAR 与传统 SOAR 外挂 LLM 聊天机器人有何本质区别?本文剖析智能体是否真正改变了安全事件响应中剧本的执行逻辑,并给出辨别厂商话术的实用方法。
28%的企业招聘岗位挂满90天:幽灵职位为何泛滥
一份最新报告显示,企业官网上28%的招聘岗位已开放超90天,揭示"幽灵职位"泛滥现象。本文分析其成因、对求职者的影响及识别规避方法。