层级感知RAG分块工具包:为法律文档打造的私有化处理方案

一款面向法律等结构化文档的私有化RAG分块工具包,核心为层级感知分块器与无需LLM的法律引用提取脚本。
RAG Chunking Processing Bundle 是一套专为结构化文档设计的分块工具包,核心组件"层级感知分块器"能识别文档的多级标题嵌套关系,为每个chunk附加完整章节路径元数据,从而避免传统固定大小分块丢失结构信息的问题,也省去了反复调整chunk大小与重叠参数的调优成本。工具包以完整Python源码形式交付,主打私有化本地部署,直接回应法律、金融、医疗等敏感行业不愿将文档流经外部API的隐私需求。附带的两个法律专用脚本——交叉引用提取器和法案名称提取器——均为纯规则解析方案,无需调用LLM,可处理复杂复合引用格式。整套工具兼容LangChain生态的主流模型提供方,但其效果目前仅有作者自述,缺乏第三方独立验证。
为什么RAG分块值得单独做一个工具
RAG(检索增强生成)流水线里,分块(Chunking)往往是最不起眼却最影响效果的一环。切得太碎,上下文断裂;切得太粗,检索噪声增加。更棘手的是法律文书、合同、研究论文这类结构化程度高的文档——它们天然带有"标题→副标题→章节→子条款"的多层嵌套结构,而大多数通用分块器只会按固定字符数或段落粗暴切分,把这些结构信息全部丢弃。
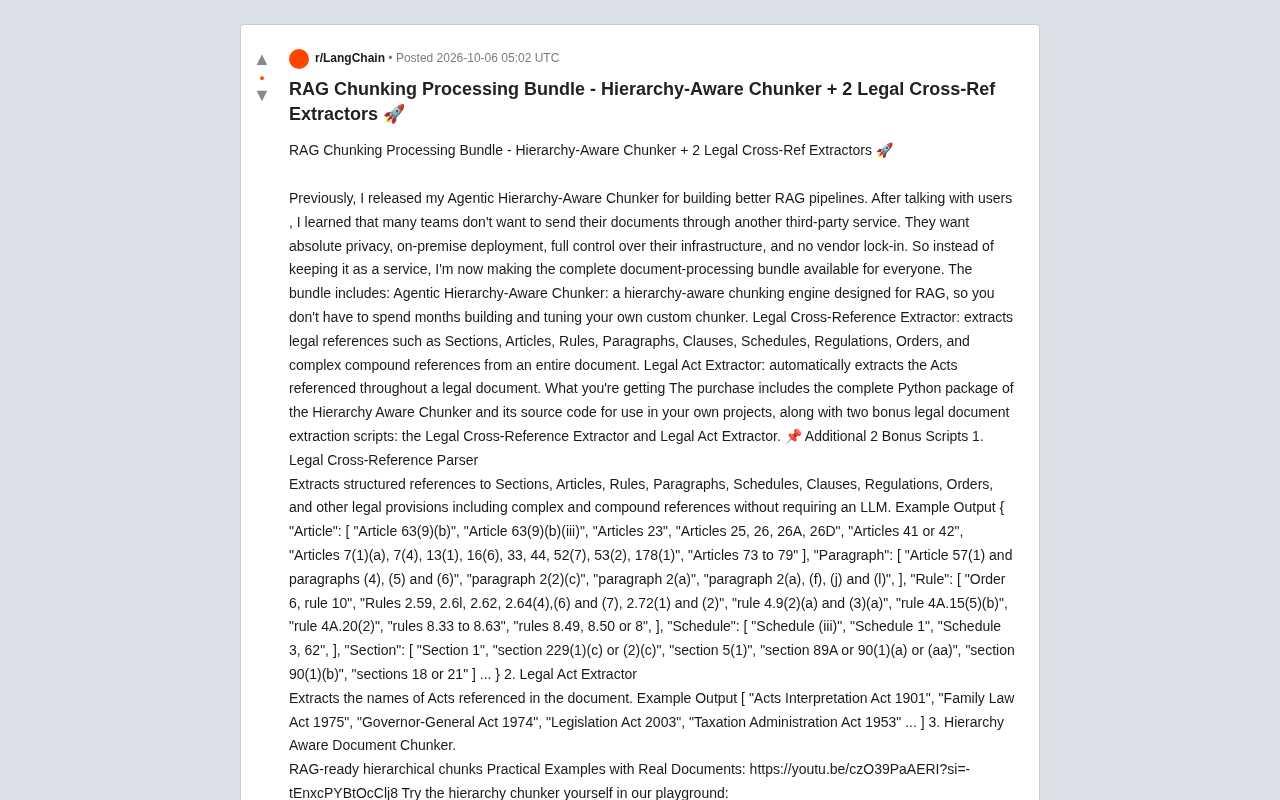
一位开发者在 Reddit 上发布了一套名为 RAG Chunking Processing Bundle 的工具包,核心是一个"层级感知分块器"(Hierarchy-Aware Chunker),外加两个针对法律文档的交叉引用提取脚本。它最值得关注的地方,不只是功能本身,而是其发布方式的转变——从在线服务转向可私有化部署的完整源码包。
RAG(检索增强生成)的基本工作原理是:将外部文档切分成若干片段(chunk),存入向量数据库,在用户提问时检索最相关的片段,再将这些片段作为上下文送入大语言模型生成答案。分块质量直接决定检索召回率——若一段完整的论述被切断在两个chunk中间,向量检索很可能只召回半截内容,导致LLM基于不完整信息作答。常见的固定大小分块(Fixed-size Chunking)和基于段落的分块虽实现简单,但对富含层级结构的文档(如法律条文、学术论文、技术规范)效果有限,因为它们会把"第三章第二节第1条"这样的层级关系彻底打散,检索时LLM无从判断片段的结构归属。
从SaaS服务到源码交付:隐私是核心诉求
作者此前把这个分块器做成了第三方服务,但在与用户沟通后发现一个普遍诉求:很多团队不愿把自己的文档发送到外部服务。他们要的是绝对的隐私、本地化(on-premise)部署、对基础设施的完全掌控,以及不被厂商锁定(no vendor lock-in)。
这一诉求在法律、金融、医疗等敏感行业尤其强烈。合同、判例、监管文件往往涉及保密义务,任何经过第三方API的数据流转都可能构成合规风险。于是作者索性把整套文档处理工具以完整 Python 包加源码的形式交付,让用户可以直接集成进自己的项目,在内网环境中运行。这种"卖代码而非卖服务"的思路,恰好切中了企业级 RAG 落地的真实痛点。
厂商锁定(Vendor Lock-in)指企业一旦深度依赖某家供应商的API或服务,便难以迁移至其他方案,议价能力随之下降。对于RAG流水线而言,这一风险尤为具体:若分块逻辑、向量索引与检索策略均托管于外部平台,一旦供应商调整定价、修改接口或停止服务,整个生产系统都面临重构风险。私有化部署(On-premise)则将所有计算保持在企业自有或自控的基础设施内,数据不经过公网,既规避合规风险,也彻底切断外部依赖。在GDPR、HIPAA等数据保护法规收紧的背景下,这一部署模式正成为金融、法律、医疗等行业的事实标准,而非可选项。
层级感知分块器:让每个chunk都知道自己属于哪一节
这个分块器的核心能力是理解文档结构——识别标题、标题层级、章节与子章节,并把嵌套的子标题合并到正确的 chunk 中,保证上下文连贯流动。
它的几个关键特性值得拆解:
- 保留多级层级结构:支持 Title → Subtitle → Section → Subsections 的多层嵌套,而不是压平成单层。
- 为每个chunk附加元数据:每个分块都知道自己归属于哪个章节,检索器和 LLM 由此始终清楚上下文位置。
- 检索友好的结构化输出:生成的 chunk 是上下文感知、结构化、便于检索的。
从作者给出的示例输出可以直观看到效果。针对一份《Magistrates' Courts (Licensing) Rules (Northern Ireland) 1997》文档,分块结果不仅包含正文,还在 Metadata 中标注了完整层级路径:
--- Chunk 2 ---
Metadata:
  Title: Magistrates' Courts (Licensing) Rules (Northern Ireland) 1997
  Section Header (1): PART I
  Section Header (1.1): Citation and commencement
Page Content:
  PART I Citation and commencement
  1. These Rules may be cited as...
标题被保留并附着到 chunk 上,检索器和 LLM 由此总能知道该片段属于哪一节、哪一子节。作者强调,这样就不再需要为 chunk 重叠和块大小反复调参——对任何做过 RAG 调优的人来说,这是实打实省时间的卖点。
成本与集成:LLM按需使用
工具并非无脑依赖大模型。它把 LLM 推理和自研的优化解析器结合,以此控制成本。作者特别指出:如果 OCR 能完美识别标题/子标题,则完全无需调用 LLM。同时它兼容任何 LangChain 生态的提供方(OpenAI、Anthropic、Google、Ollama),切换灵活。无需额外预处理,直接粘贴原始内容或 Markdown 即可使用。
两个法律专用脚本:无需LLM的引用提取
工具包额外附带两个针对法律文档的提取脚本,二者都主打不依赖 LLM 的纯解析方案,这意味着更快、更便宜,也更适合隐私敏感场景。
法律交叉引用提取器
它能从整篇文档中抽取结构化的法律引用,覆盖 Sections、Articles、Rules、Paragraphs、Schedules、Clauses、Regulations、Orders 等条目,甚至包括复杂的复合引用。从示例输出看,它能正确解析形如 Article 63(9)(b)(iii)、Articles 25, 26, 26A, 26D、Articles 73 to 79、Order 6, rule 10 这类高度嵌套和区间式的表达。
法律条文的引用格式极其多样且不规则,能用规则解析稳定处理这些复合引用,本身就是不小的工程量。对于构建法律知识图谱或条文关联检索的团队,这类结构化引用数据是刚需。
法律文书中的交叉引用(Cross-reference)是指一份文件内部或跨文件之间条款的相互援引,例如"依第63条第9款第(b)项第(iii)目的规定……"。这类引用在立法文本中密度极高,构成条文之间的语义依赖网络。对于RAG系统而言,若不提取并显式建模这些引用关系,检索器往往只能召回被直接提问的条款,而无法自动关联其所援引的上游条文,导致答案缺乏法律依据的完整链条。将引用关系结构化后,可进一步构建知识图谱,实现"某条款的所有引用方"或"某法案被引用的完整路径"这类图查询,大幅提升法律智能应用的推理深度。
法律法案提取器
第二个脚本更聚焦,自动抽取文档中引用到的所有法案(Acts)名称,例如 Family Law Act 1975、Legislation Act 2003、Taxation Administration Act 1953 等。配合交叉引用提取器,可以快速梳理一份法律文件的外部依赖关系。
适用场景与理性看待
按作者的定位,这套工具尤其适合法律文书、研究论文、合同等结构化文档的 RAG 处理。作者还提供了在线 Playground(hierarchychunker.codeaxion.com)供试用,以及 YouTube 上的真实文档演示视频。
需要客观指出的是,这是一份来自 Reddit 的作者自述加商业化推广,示例效果和性能描述均由作者单方给出,缺乏第三方基准测试或独立验证。两个法律脚本的规则覆盖度能否泛化到不同法域、不同格式的文书,也有待实际使用检验。对于考虑采用的团队,建议先用自己的真实文档在 Playground 验证分块质量,再决定是否引入生产流水线。
不过,它所反映的趋势是清晰的:随着 RAG 从 demo 走向企业落地,数据隐私与私有化部署正成为硬性门槛,而面向特定领域(如法律)的结构化预处理,正在成为提升检索质量的关键差异点。
相关推荐
98%家庭不付费AI:消费级AI到底是机会还是幻觉?
a16z最新报告显示全美仅2.2%家庭为AI付费,顶级1%用户支出相当于后50%总和。本文深度解析消费级AI应用榜单、大模型格局、企业采购变化,以及"消费者永不付费"的核心辩论与破局路径。

用Codex做生产监控:Grafana、K8s与安全全链路自动排障
基于 OpenAI Codex 的实战演示,拆解如何用 agentic 工作流处理 Grafana 指标异常、Kubernetes 级联故障和安全资源耗尽三类生产故障,把排障时间从一小时压缩到几分钟,并探讨从人在回路到全自动闭环的落地路径。

Cornerstone OnDemand如何用Amazon Bedrock将数据库诊断效率提升78%
Cornerstone OnDemand基于Amazon Bedrock和Strands Agents构建多智能体系统Orion AI,仅用三人团队在六个月内将数据库诊断时间缩短78%,从45分钟降至10分钟。本文解析其架构设计与可复用经验。