AI模型为何越来越"千篇一律"?蒸馏与RL催生的单一文化危机
蒸馏与强化学习的双重作用正推动AI模型输出走向"单一文化",多样性被系统性压缩。
当前大量开源模型通过蒸馏向Claude等少数头部模型学习,同时经过以人类偏好为导向的强化学习训练,使输出风格高度收敛。分布分析显示,这些模型在创作中反复使用相同主题和角色名,表面流畅的背后是对狭窄模板的重复采样。文章指出,AI呈现的是"一种非常好的风格",而非人类写作所具备的多声部多样性。更深层的隐忧在于:整个行业正在形成"单一文化",共享的偏见与盲点会放大系统性脆弱性;若未来模型继续用AI生成内容训练,多样性将在每一轮迭代中被进一步过滤,直至只剩"最标准"的少数模板。如何在追求性能的同时主动保留输出多样性,是AI训练亟待面对的结构性挑战。
当下的AI模型正在悄然变得越来越相似。当你让不同的大语言模型写一个故事、编一段文案,甚至只是回答同一个问题时,产出的风格、用词乃至角色命名往往惊人地雷同。这种"趋同"现象背后,隐藏着当前AI训练范式的一个结构性问题——模型的多样性正在被系统性地压缩。
蒸馏依赖:大家都在向同一个"老师"学习
一个关键原因在于训练数据的来源高度集中。许多开源权重模型(open-weight models)都在通过蒸馏(distillation)的方式向少数几个头部模型学习,其中Claude是被蒸馏最多的对象之一。
蒸馏本质上是让一个"学生模型"去模仿"教师模型"的输出行为。当整个行业的开源生态都把同一个模型当作学习范本时,结果可想而知:这些模型继承了同一套语言习惯、同一种表达偏好,甚至同一批"思维定式"。这不是简单的技术选择,而是一种集体性的路径依赖——省成本、见效快,但代价是整个生态的输出趋于同质化。
知识蒸馏(Knowledge Distillation)最早由Hinton等人在2015年系统化提出,核心思路是让小型学生模型学习大型教师模型的"软标签"(soft logits)——即输出层的概率分布,而非仅仅是硬标签答案。这种方式能让学生模型用更少的参数和计算量,习得教师模型的泛化能力。在大语言模型时代,蒸馏的对象进一步扩展到教师模型的完整输出文本(output distillation),学生模型通过在这些文本上进行监督微调,间接内化教师的语言风格、推理链路和价值取向。正是这一机制使得"风格传染"成为可能:当Claude的输出成为数十个开源模型的训练语料时,Claude偏爱的句式结构、开头措辞、注意事项表述方式也随之被批量复制,而这些"软性特征"在常规评测基准中几乎不会被检测到。
RL之后,多样性被大幅削减
除了蒸馏,强化学习(RL)阶段是另一个关键变量。原始素材中提到,模型在经过RL训练后,"输出的多样性明显降低,并且开始形成一些固定的小习惯(ticks)"。
这里的逻辑值得深究。RL通常以某种奖励信号来优化模型行为,比如人类偏好或特定评分标准。但当模型被反复推向"高分区间"时,它会逐渐收敛到少数几种被验证过的"安全打法"上。换句话说,RL让模型变得更"好",却也让它变得更"窄"。它学会了如何稳定地拿高分,却牺牲了探索不同表达方式的能力。
这里的RL通常指基于人类反馈的强化学习(RLHF,Reinforcement Learning from Human Feedback)或其变体如RLAIF、DPO(Direct Preference Optimization)。其训练流程是:先让人工标注者对模型的多条输出进行偏好排序,再用这些偏好信号训练一个奖励模型,最后用PPO等算法引导语言模型向高奖励方向更新参数。问题在于,人类标注者对"好输出"的判断本身存在共同偏好——结构清晰、语气友好、措辞稳健——这些偏好会被奖励模型学习并放大。模型因此学会规避任何可能拉低分数的"冒险表达",包括风格实验、非常规叙事视角、模糊或留白式的写法。奖励信号越强、训练轮数越多,这种"安全收敛"就越彻底,模型的实际表达空间也随之线性收窄。
分布分析揭示的隐藏问题
表面上看,这些模型的写作能力似乎不错,语句流畅、结构完整。但当你做一些分布层面的分析(distributional analysis)时,问题就暴露出来了。
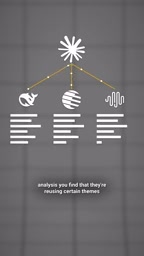
分析显示,这些模型在写作中会反复使用某些特定主题,甚至总是使用相同的角色名字。这种现象很能说明问题:模型并不是真的在"创作",而是在从一个相对狭窄的分布中反复采样。你看到的"流畅",其实是重复的流畅;你感受到的"能力",其实是被训练固化下来的少数几个模板。
对于单次使用者来说,这或许无伤大雅——毕竟一段通顺的文字已经够用。但从整体生态看,这意味着海量AI生成内容正在共享一个越来越小的"表达池"。
一种好风格,不等于多样的风格
原始素材提出了一个尖锐的对比:AI模型的输出更像是"一种非常好的风格",而不是像人类作者那样呈现出的丰富多样性。
这个区别至关重要。人类写作的价值恰恰在于千人千面——不同作者有截然不同的语感、节奏和世界观,正是这种差异构成了文化的丰富性。而当前的AI模型,即便个体质量很高,也只是把大家都收敛到同一个"最优解"附近。你得到的是一个抛光过的、统一的声音,而不是一片多声部的合唱。
单一文化(Monoculture)的隐忧
把这些线索串起来,一个令人担忧的趋势浮现出来:AI领域正在形成一种"单一文化"(monoculture)。
蒸馏让大家共享同一个源头,RL让每个模型进一步收敛,最终结果是整个行业的输出风格高度趋同。这种单一文化的风险不仅仅是"内容无聊"这么简单。在生态学中,单一栽培作物一旦遇到某种病害就会全线崩溃;在AI领域,如果所有模型都共享相似的偏见、盲点和失败模式,那么整个系统对某类问题的脆弱性也会被放大。
更长远地看,如果未来的模型继续用前一代AI生成的内容来训练,这种趋同还可能形成自我强化的循环——多样性被一轮轮地过滤掉,直到只剩下最"标准"的那一小部分。如何在追求模型性能的同时,主动保留输出的多样性,或许是接下来AI训练需要认真面对的课题。
这里提到的自我强化循环在研究领域被称为"模型崩溃"(Model Collapse)或"数据污染"问题。2023年多项研究发现,当模型迭代地在自身或同类模型生成的文本上训练时,输出分布会逐代收窄:低频但真实存在的语言模式最先消失,长尾知识随后退化,最终模型趋向于只能生成高频、"平均"的表达。这与生态学中的近交衰退(inbreeding depression)在机制上高度类似——基因库(或训练数据库)的多样性一旦下降,种群对新型压力的适应能力就会系统性减弱。对AI而言,一旦某类输入触发所有模型共同的盲点(例如特定类型的逻辑谬误或文化偏见),整个生态将同步失效,而没有任何"异质"模型能提供不同的参照或纠错。主动向训练数据引入多样性约束、在评测体系中加入分布多样性指标,是目前研究者提出的主要应对方向。
相关推荐
LynnReal-Omni:32B统一视频扩散模型开源,四步生成多任务全覆盖
LynnReal-Omni 是基于 MiniMax H3 架构的 32B 统一视频扩散模型,支持文生视频、图生视频、姿态引导、视频修复等多任务,四步快速生成,Flash 版单张 H100 上 377ms 完成 540p 视频,权重与 ComfyUI 节点已开源。

Anthropic联合创始人:AI"紧急停止开关"或应强制立法
Anthropic联合创始人向BBC表示,AI系统的"紧急停止开关"(kill switch)可能需要通过法律强制推行。本文分析这一呼吁背后的产业逻辑、技术挑战以及监管与创新之间的张力。

AI数据中心建设热潮,正冲击工业创伤深重的城市
AI数据中心建设热潮正与曾受重工业创伤的城市社区激烈碰撞。以费城为例,全国性反对声浪聚焦能耗、水资源与环境公平问题,揭示AI增长与地方利益的结构性冲突。