#模型蒸馏
共 15 篇相关文章

ShadeNet-5:35M参数单次推理输出反照率/深度/法线
ShadeNet-5 是一个 35M 参数的前馈网络,基于冻结 DINOv2 骨干,单次推理输出反照率、相对深度和表面法线。量化 ONNX 仅 31 MB,CPU 推理约 1 秒,并附带蒸馏式单次精炼器。

D²-OPD:解耦方向与距离的在线蒸馏新方法
D²-OPD提出解耦外推蒸馏中方向与距离的新方法,通过逐前缀硬KL约束控制目标距离,自适应组合教师偏移与初始差距确定方向,在数学推理基准上三个设定均取得最优,最高超越最强基线9.45分。

DMD蒸馏新突破:批评者模型需与教师模型同步缩放
DMD蒸馏研究发现批评者模型需与教师模型同步缩放,否则会导致训练崩溃。步感知批评者STAC进一步提供步特定分数估计,在ImageNet、SDXL、FLUX.2和Wan2.1上均验证有效。
开源模型能追上OpenAI吗?Nathan Lambert深度解析
Nathan Lambert深度解析开源模型能否追上OpenAI与Anthropic:算力、人才、蒸馏的真实作用,中国开源实验室的商业动机,以及新实验室Trillium如何为RSI祛魅。
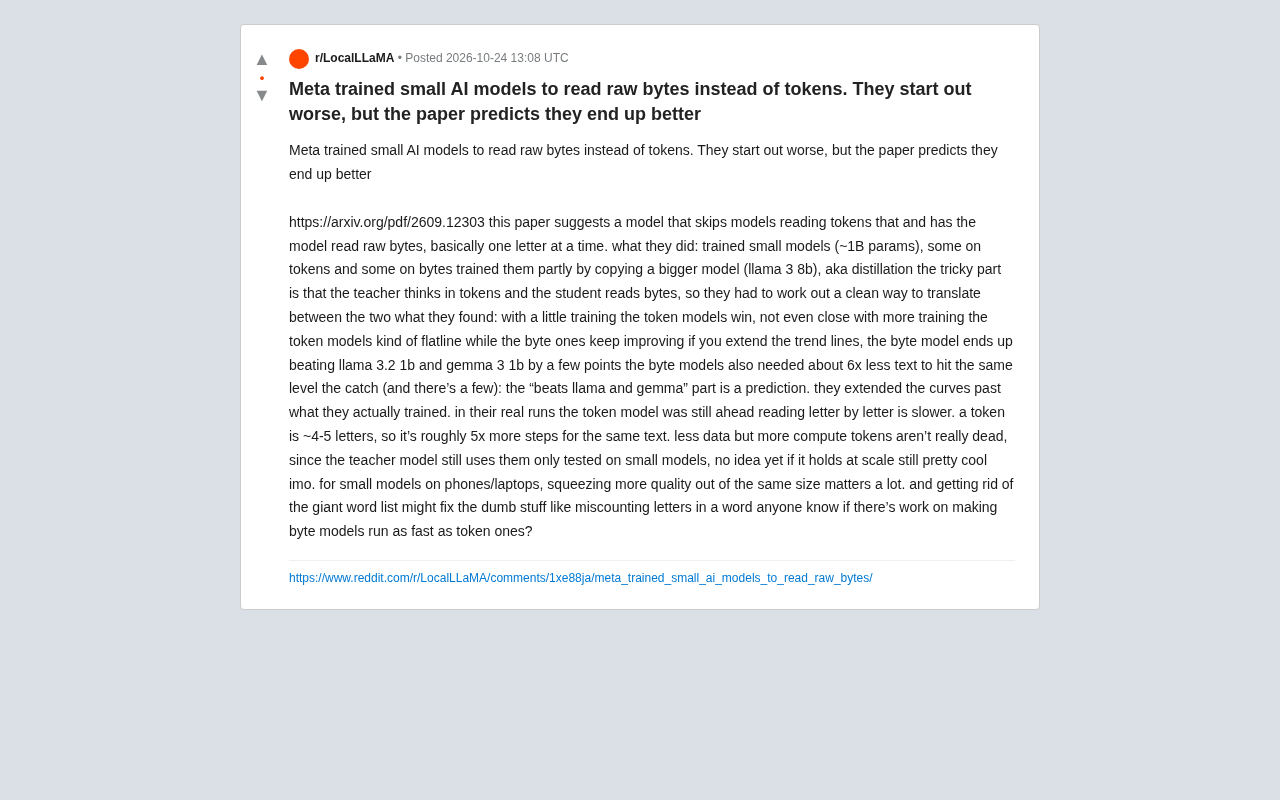
Meta用小模型实测:绕过分词直接读字节,后劲更足
Meta新论文用蒸馏实验对比token模型与字节模型:字节模型起步落后但训练曲线后劲更足,数据效率高约6倍,代价是推理速度慢约5倍。本文梳理实验设计、外推预测的边界与对小模型部署的意义。

模型蒸馏视觉解析:小AI如何向大模型偷师,复制争议何来?
Reddit视觉解析深入探讨模型蒸馏:小模型如何从大模型学习,以及实验室为何担忧该技术被用于复制模型能力。文章拆解技术原理、争议焦点与开发者合规启示。

模型指纹闹剧:DeepSeek蒸馏GPT的谣言与开源反击
DeepSeek被指蒸馏GPT和Claude?模型指纹测试却测出穿越时空的荒诞结果,工具内置指纹库仅有GPT和Claude两家。与此同时DeepSeek开源推理框架DeepInfer,用透明工程回击质疑。

4B模型RL训练实测:能否追上27B大模型?
实测用开源RL环境在双DGX Spark上训练Qwen3.5-4B:只训练边缘任务可追回与27B模型超一半差距,但GRPO机制决定收益有天花板,蒸馏加RL组合效果最佳。

合成数据真正的瓶颈:缺少血缘追踪,而非数据量
合成数据管线的真正瓶颈不是生成量,而是血缘追踪缺失。本文解析蒸馏循环如何悄悄固化教师模型盲区、同家族过滤器为何在洗白偏差、人工标注为何锚定合成文本流畅度,并给出带manifest的血缘优先管线设计。

BranchOPD:用分支采样让在线策略蒸馏更高效
BranchOPD 提出分支式在线策略蒸馏,利用学生不确定性与师生分歧定位关键决策点,通过共享前缀重采样扩大监督覆盖,在数学任务提升18.55个百分点、ALFWorld提升13.8点,同时降低近三成生成成本。
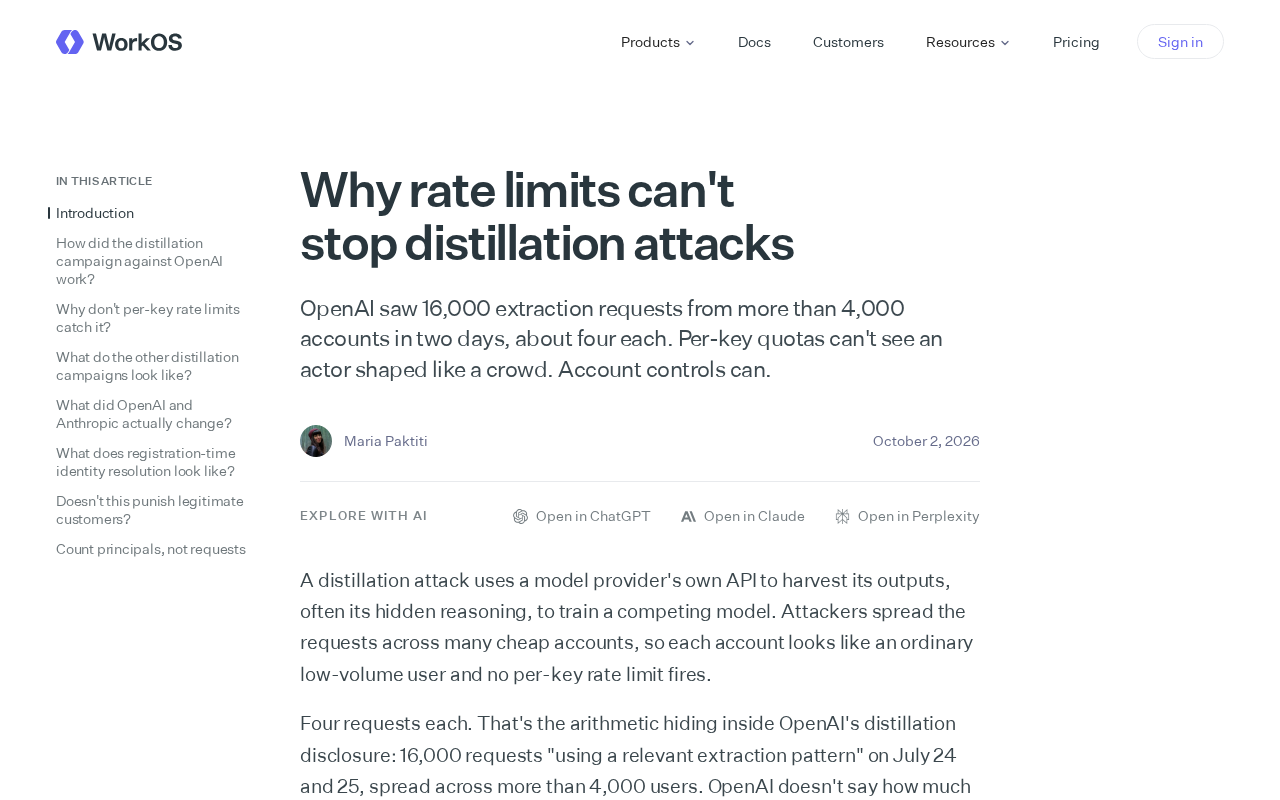
速率限制为何挡不住模型蒸馏攻击?
OpenAI 两天内遭遇 4,000 账户发起的 16,000 次模型提取请求,每账户仅约 4 次。本文解析为何速率限制挡不住分布式蒸馏攻击,以及账户层面控制为何成为必要防御。
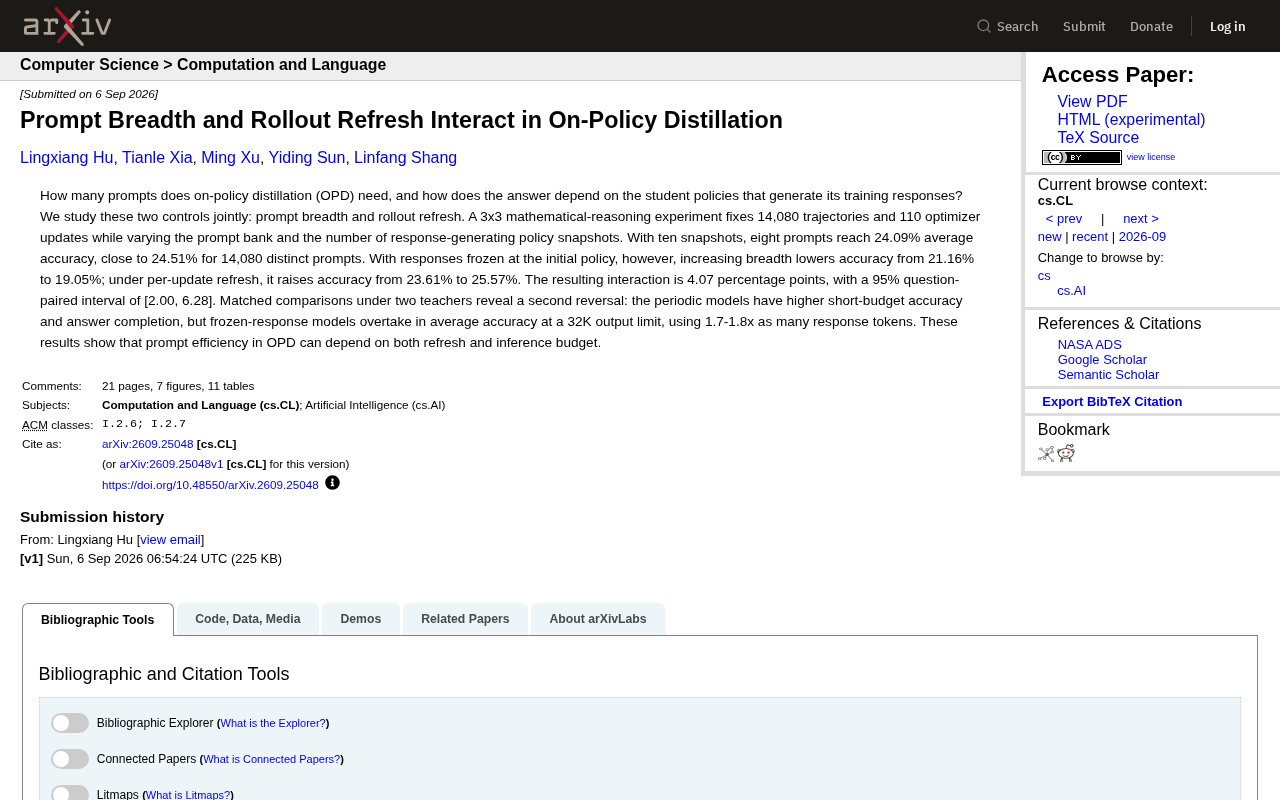
在线策略蒸馏中的提示广度与响应刷新交互效应研究
arXiv 新论文研究在线策略蒸馏(OPD)中提示广度与响应刷新的交互效应,通过 3×3 数学推理实验揭示提示效率同时取决于响应刷新策略与推理预算,交互效应达 4.07 个百分点。

窃取推理链:闭源大模型API的新型知识蒸馏攻击
Panfilov 等人的论文探讨如何从 Claude、ChatGPT 等闭源大模型 API 中大规模蒸馏推理链数据,以及这种做法对强化学习训练与行业竞争的影响。解析推理链蒸馏的技术机制与合规争议。
9美元让Gemini训练出替代自己的小模型:模型蒸馏实践观察
Hacker News热帖"9美元让Gemini训练自己的替代品"引发讨论。本文解析大模型蒸馏训练小模型的技术逻辑、成本构成、现实意义与合规局限,探讨AI应用降本新范式。
 科技前沿
悟空2.2P开源:35B MOE模型性能超越Qwen3.6-27B,速度快3-5倍
悟空2.2P 35B MOE模型正式开源,采用对抗式杂交蒸馏技术,综合性能超越Qwen3.6-27B。4090显卡Q5量化达158 tokens/s,仅需8.9G显存即可运行,支持256K上下文。详解核心技术、硬件配置与实测数据。