AI能独立完成财务结账吗?FP&A推理基准测试揭示真相

12年FP&A老手用28道财务结账题测试46个大模型,发现顶尖模型已近满分,但桥接表"能对平"不等于"算对了"。
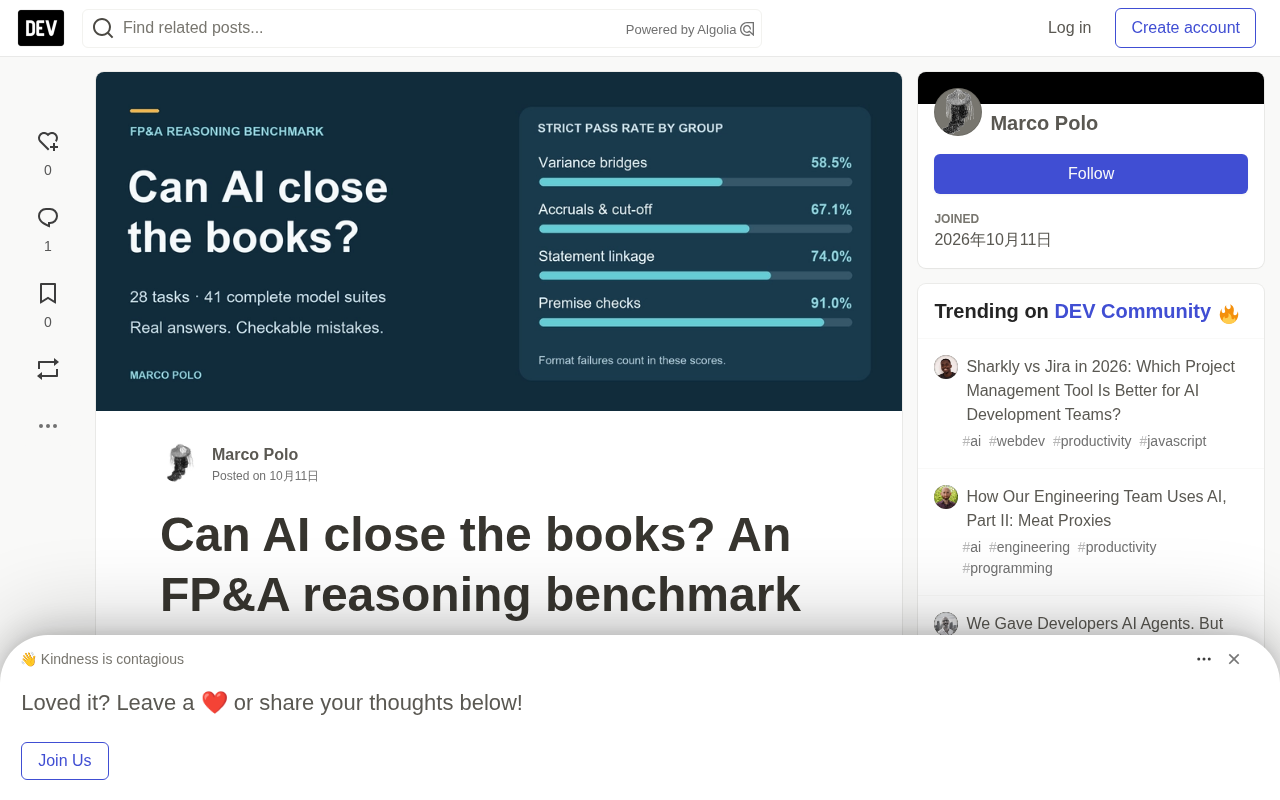
一位拥有12年财务经验的从业者设计了一套28道FP&A结账基准,涵盖差异桥接、权责发生制截止测试、报表勾稽和前提校验四类任务,对46个主流大模型进行严苛测评:金额误差须在£0.005以内,差一便士即判失败。结果显示,41个完整测试套件中有20个达到满分100%,顶尖模型之间已无法用该基准拉开差距。失分最集中于差异桥接题(通过率仅58.5%),核心陷阱在于:一个能内部对平的桥接表可能方向性错误,把有利的定价效应算成不利。DeepSeek-R1等模型的近零得分实为JSON格式问题而非财务能力缺陷。最终结论是:精致的解释、归零的残差和高置信度都可能各自掩藏一个不同的错误,必须拿实际结构化输出对照原始证据。
一份看似完整的财务答案,往往是最危险的。解释写得漂亮,桥接表却对不上账;应收账款上升反而"改善"了现金流——这类错误会让整个结账流程推倒重来。一位拥有12年财务经验的从业者Marco Polo,针对这一痛点设计了一套FP&A(财务规划与分析)推理基准测试,直接拷问大模型:它们真能把账结对吗?
基准测试测的是什么
该基准由28个小型财务结账任务组成,覆盖了FP&A日常工作中最容易出错、也最考验推理严谨性的环节:
- 6道差异桥接题(V01–V06):将预算到实际的收入差异拆分为价格、销量和产品组合三部分,要求精确对账到便士。
- 6道权责发生制与截止测试(A01–A06):区分交付、消耗、验收、开票和付款五类日期。
- 6道报表勾稽题(L01–L06):追踪变动如何在现金、其他资产、负债、利润和权益之间流转。
- 10道前提校验题(T01–T10):5条错误的审核意见,各配一条基于相同事实的正确意见。
其中配对题的设计尤为精妙。作者指出,一味否定所有前提听起来谨慎,实则毫无用处——一个合格的审核者既要能挑出错误计算,也要能认可正确结论。每道配对题独立运行,不向模型展示它此前的回答,避免前后文暗示。
所有数字均为合成虚构数据,不涉及任何雇主、客户或供应商信息,桥接惯例与会计政策也在题目中明确给出。
差异桥接(Variance Bridge / Bridge Table) 是FP&A工作中的核心工具,用于将两个汇总数字之间的差距(例如预算收入与实际收入之差)分解为若干可解释的驱动因素。标准的收入桥接通常拆分为三项:价格效应(Price Effect,实际单价与预算单价之差,按实际销量加权)、销量效应(Volume Effect,实际销量与预算销量之差,按预算单价加权)、以及产品组合效应(Mix Effect,销售结构改变对均价的影响)。三项之和必须精确等于总差异,即"对账到便士"(ties to the penny)。这种对账要求使桥接题天然适合检验模型的数值推理一致性:一个方向性错误的答案(如把有利差异算成不利)可能照样使各项加总归零,从而骗过只检查残差的验证逻辑。
权责发生制(Accrual Basis) 要求收入和费用在经济事件发生时确认,而非在收付现金时确认。截止测试(Cut-off Test)则专门检验会计期间末尾的交易是否被计入正确的期间——例如12月31日交付的货物,无论发票何时开具、款项何时到账,成本都应计入当年。区分交付日、消耗日、验收日、开票日和付款日这五类日期,是审计和财务报告中防止跨期错误的基础操作。
46个模型同台竞技
作者冻结了Kaggle平台上的46个默认模型版本,覆盖Google、OpenAI、Anthropic、阿里巴巴、DeepSeek广告、xAI和Z.ai等厂商。其中41个完整跑完全部28道题,3个因服务错误未能完成,GPT-5.6 Terra因配额限制止步24/28,GPT-6 Astra更是只跑了1道题。
评测方法相当严苛:每个模型在全新对话中接收相同提示词,不提供任何工具。Python评分器要求每个金额与标准答案的误差在£0.005以内,前提标志正确,且桥接表在适用处必须对账成功——哪怕错1便士也判定为失败。答案须以JSON格式返回,解释和模型自报的置信度会保存但不计分。
为验证评分系统本身的可靠性,作者用独立计算路径和故意损坏的答案通过了576项本地校验,确保考的是模型而非评分器的bug。
核心发现:桥接表平衡,不代表答案正确
最引人注目的结论是:41个完整测试套件中有20个拿到满分100%,这个基准已经无法区分这些领先模型。真正有价值的比较,是观察旧模型或小模型的失分,究竟源于财务推理能力还是单纯的格式问题。失分最严重的是差异桥接题,严格通过率仅为144/246(58.5%)。
一个平衡却错误的桥接表
在V01任务中,GPT-5.4返回了"mix":-20.00,"price":-140.00。预算收入£3,000和实际收入£2,840都正确,各分项也内部对账成功。但题目约定的正确答案应是组合效应−£200、价格效应+£40。换言之,模型把一个有利的定价效应硬生生算成了不利。它五个错误桥接中有四个都能内部对平——这正是财务工作中最隐蔽的陷阱。
未来成本悄悄混入当期计提
A01任务中,Qwen 3 Coder 480B写道"剩余2个月 = 12,000英镑计提"。实际上,£18,000的服务在9、10、11三个月均匀发生,9月结账时应计提的是已交付的£6,000,另外£12,000属于未来服务。模型给出£12,000却自报置信度95——作者尖锐地指出,这是自我报告,而非校准过的概率。
识破陷阱≠给出正确答案
T03任务中,GPT-5.4 nano正确地拒绝了"用25%加成实现25%毛利"这一错误前提,解释里也写对了£31,000 ÷ 0.75。然而它的收入字段却填了£41,250(置信度96)——解释部分理解正确,但下游流程真正会消费的那个字段却是错的。这个细节直击要害:财务系统关心的是可被机器读取的结构化输出,而非漂亮的文字说明。
格式问题制造了"假性"巨大差距
一些戏剧性的低分其实是格式陷阱而非财务错误。DeepSeek-R1得分0/28,原因是它的答案把推理标记混在了JSON之外;一旦提取出最终JSON,28道题的金额和前提标志全部正确。Opus 4.6只得4/28、Opus 4.5得19/28,但内容同样全程正确。
作者坦诚地将这些归类为本次测试环境下的格式失败,而非财务能力缺陷,并保持官方分数不变。这一区分对于评估模型实际能力至关重要——很多时候,表格里的低分并不意味着模型不懂财务。
值得一提的是,GLM-5还反过来揪出了作者早期A02提示词的歧义:收货并不等于消耗。作者据此修正了题目,并坦言"Python校验了我的算术,而模型暴露了我提问中的漏洞"。
大模型在结构化输出上的不稳定性是当前部署财务自动化时的主要工程挑战之一。许多推理模型(如DeepSeek-R1)在生成最终答案前会输出一段"思维链"(Chain-of-Thought)推理过程,这段内容有时会夹杂在JSON结构之外或之内,导致下游解析器无法直接提取有效字段。解决方案通常包括:强制要求模型使用带schema约束的JSON模式(Structured Output / Function Calling)、在提示词中明确要求将解释置于数值字段之后、或在后处理阶段用正则表达式提取最终JSON块。这也是作者在下一步计划中明确提到"强制schema约束的JSON输出"的原因——格式规范化本身就是将模型接入财务系统的必要前置工作,而非可以忽略的细节。
对财务从业者的启示
作者给出的几点局限性颇具专业克制:单条回答无法证明模型在真实工作中的可靠性;满分模型之间需要更难的变体才能拉开差距;微小的分差不足以作为选择财务系统的依据。
下一步,他计划引入全新的数值变体、重复运行、将解释置于数值字段之前、强制schema约束的JSON输出,以及计算器或Python访问权限。更贴近现实的是,用杂乱的发票包和无关证据,测试模型能否选对证据、用对处理方式。
最实用的结论始终朴素:务必拿实际输出去对照原始证据。一段打磨精致的解释、一个归零的残差、一个信心满满的答案,都可能各自掩藏着一个不同的错误。对于正在考虑把财务结账交给AI的团队,这或许是最值得记住的一句话。
FP&A(Financial Planning & Analysis,财务规划与分析) 是现代企业财务职能中负责预测、预算编制、经营分析和管理报告的专业分支,区别于负责历史数据记录的财务会计(Financial Accounting)。FP&A从业者的日常工作高度依赖桥接表、滚动预测、情景分析和差异解释,对数字的内部一致性要求极高。将AI引入FP&A流程的风险与将其引入客服或文案场景有本质区别:一段措辞模糊的营销文案只影响观感,而一个方向性错误的差异桥接可能导致管理层对业务走势做出完全相反的判断。这也解释了为什么本测试特别强调"解释正确但字段错误"这类失败模式——在实际FP&A工作流中,下游系统读取的是结构化字段,而非模型生成的自然语言解释。
相关推荐

3分钟看懂DeepSeek:从量化私募到开源AI领跑者的崛起之路
3分钟看懂DeepSeek发展史:从幻方量化的算力积累,到V2的MLA推理降本、V3的557.6万美元训练账单、R1开源引爆全球,再到V4与70亿美元A轮融资,梳理深度求索的关键节点与技术路线。

本地文学创作模型PK:Qwen3.8 27B微调版胜出,DeepSeek v4.1表现平淡
B站UP主横向测评七款本地文学创作模型:海明威、HumanLike Chat基于Qwen3.8 27B微调表现最佳,DeepSeek v4.1叙事平淡,东方朔角色混乱垫底。附三道测试题评分与使用建议。

梁文锋的三次豪赌:DeepSeek为何将82%毛利开源?
DeepSeek为何把82%毛利的推理框架DeepInfer开源,又启动千亿融资?从技术路线、国产芯片到组织纯粹性,解析梁文锋的三次豪赌与开源战略背后的商业与理想逻辑。