#大模型评测
共 32 篇相关文章

用围棋测试大模型:一手棋看懂七种AI核心能力
CXBench 项目用围棋测试大模型,从状态追踪、长程规划到错误恢复和不确定性管理,拆解一手棋背后的七种AI核心能力,揭示分数榜单之外的真实应变水平。

如何打造个人AI评测基准:5步选对适合你的大模型
新模型平均11天就发布一个,公开跑分却越来越不可信。本文详解AI Daily Brief研讨会提出的个人AI评测基准5步法:选任务、定候选、盲测、AI裁判、做决定,教你判断哪个大模型真正适合自己的工作流。

Mistral Large 4 魔方测试失败:模型还是框架的锅?
Mistral Large 4 在魔方模拟器测试中失败:能画出漂亮的 3D 魔方并支持旋转,却在打乱和色块同步上出 bug。测试者认为问题可能出在模型与评测框架的交互,而非模型本身。

LiveNerf 第8天:开源工具追踪 Opus 5.5 是否被偷偷降级
开源项目 LiveNerf 每日独立评测 Opus 5.5,试图用数据判断大模型发布后是否被悄悄降级。第8天更新显示项目逼近千星、登上 Hacker News,性能基线即将建立。本文解析其方法论、社区质疑与透明度理念。

GPT-6.1 Sol 实测:能否击败同价位的 Claude Sonnet 5.5?
OpenAI 新发布的 GPT-6.1 Sol 定价与 Claude Sonnet 5.5 完全一致。本文基于博主 Bijan Bowen 的完整实测,对比两者在 3D 游戏生成、场景建模、机械臂抓取等任务上的真实表现,并分析 GPT-6.1 Sol 的 token 效率与潜在优势。
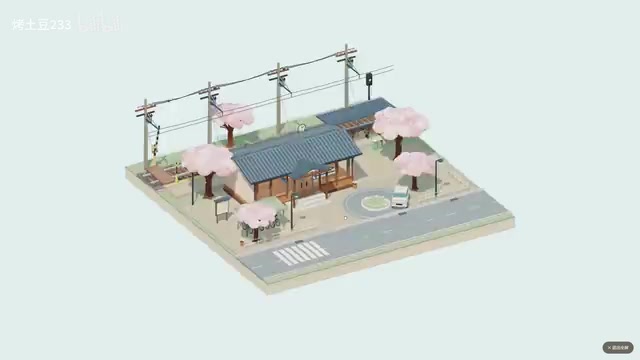
GPT-6.1实测对比Sonnet 5.5与Luna:谁的生成质量更强?
B站UP主实测对比GPT-6.1、Sonnet 5.5与Luna三款模型,参照Astra标杆评估生成与建模质量。GPT-6.1接近Astra水平且价格更低,Sonnet 5.5建模大幅提升,Luna表现中规中矩。

CARAT揭秘:材料科学大模型是在推理还是背诵?
arXiv最新论文CARAT深入探讨材料科学大语言模型究竟是在推理还是背诵。通过GraphSpace、答案遮蔽、配对推理等方法,揭示准确率背后的信息泄漏陷阱,为AI评测提供可信范式。
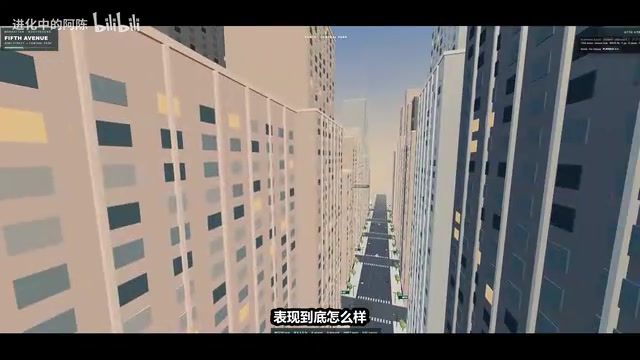
GPT-6 Sol发布:价格腰斩,实测95分追平顶级旗舰
OpenAI正式发布GPT-6 Sol,接口价格腰斩,输出端每百万Token仅10美元。B站UP主实测九道硬核基准题综合拿下95分,追平Cloud Ops 5与Grok 4.6,性价比全面碾压。

Livenerf:实时追踪Opus模型是否被"降智"
Livenerf 是一个在 Hacker News 走红的开源项目,专门持续监测 Claude Opus 5.5 等大模型是否被悄悄"降智"。本文解析其方法论、模型 nerf 争议的两方观点,以及对开发者的实践启示。

无审查安全AI模型基准测试:进攻性安全领域的新评估维度
针对无审查(Uncensored)与进攻性安全(Offensive Security)AI模型的基准测试正引发关注。本文剖析安全对齐与专业需求的冲突、评估难点及其伦理争议,为安全从业者与模型开发者提供参考视角。

Naive-N0.5-Flash实测:AI训练AI是真突破还是营销噱头?
Naive-N0.5-Flash开源模型实测解析:309B MoE、100万上下文、2000 token/s,宣称由AI训练。实测发现其基于小米MiMo-V2.5二次训练,技术均为成熟开源方案,「AI造AI」更像营销噱头。

DeepSeek V4.1 Flash实测:效率革命还是精心挑选的图表?
DeepSeek V4.1 Flash号称Terminal Bench超越Claude Opus 5和GPT-5.6,但海外博主实测发现跑分对比的是过时对手。本文拆解其MoE与编码器-解码器分离架构、890字节KV缓存的效率优势,以及在困难任务上的真实短板。
小米MiMo-V2.6双模实测:Flash惊喜,Pro成谜
小米 MiMo-V2.6 Flash 与 Pro 双模型开源实测,对战 DeepSeek 全面评测。Flash 性能价格双惊喜,Pro 表现复杂却有极低缓存定价优势,本文从动画、长程任务到价格逐项拆解。
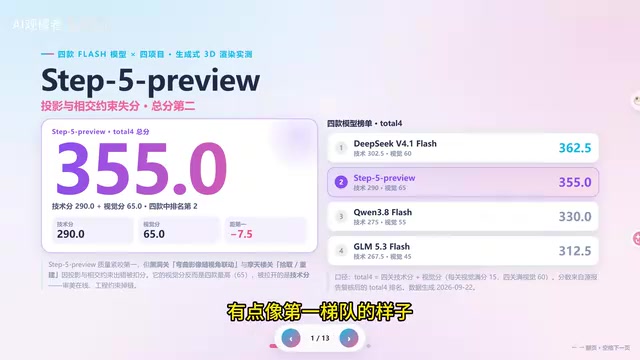
Step-5-preview实测:对比DeepSeek V4.1 Flash等三款模型
Step-5-preview实战测评,通过黑洞、光追美术馆、摩天大楼、城市疏散四个项目,横向对比DeepSeek V4.1 Flash、千问3.8 Flash、GLM5.3 Flash的技术分与视觉分表现及各自短板。
单轮安全测试全通过,多轮却被攻破:84个陷阱实测10款AI Agent
一位独立研究者用84个单轮陷阱和22个多轮陷阱实测10款AI Agent,发现单轮安全测试全通过的模型在4轮交互中依然被攻破。文章解析fail_fast、endstate、diligence三重评判方法与五种多轮失败模式。

Brood War Bench:用星际争霸考验大模型的实时决策能力
Brood War Bench 用经典即时战略游戏《星际争霸:母巢之战》评测大语言模型的实时决策与长时程规划能力,成为一种抗污染的新型AI基准。本文解析其设计思路、核心挑战与局限。
大模型也会"装好人":暗黑三角人格下的应答扭曲研究
arXiv最新研究揭示大语言模型在"装好"与"装坏"条件下会系统性调节暗黑三角人格特质表达。七个主流模型在就业选拔与司法鉴定场景下的应答失真现象,对LLM对齐评估与鲁棒性测试有重要启示。
Qwen 3.8 27B本地大模型实测:小体积如何逼近顶级闭源模型
Qwen 3.8 27B开源模型实测:仅17GB即可在家用硬件本地运行,在部分基准挑战Opus 4.6 Max等顶级模型。本文结合发票生成、待办应用两组实测与Hacker News社区反馈,剖析其惊艳输出与过度思考的短板。