AI能否逆向工程CUDA?破解NVIDIA生态壁垒的社区构想

Reddit用户提议用AI生成开源CUDA实现,文章分析其技术可行性与现实边界。
文章从一位AMD用户提议用AI逆向工程CUDA的Reddit帖子出发,分析了这一构想的吸引力与巨大难度。CUDA的护城河不仅是API,还包括编译器、数学库、工具链和框架绑定,逆向需分驱动层、运行时层、库层、编译器层四个层面推进。AI虽可辅助反编译、代码翻译和测试生成,但无法自主完成架构级逆向。社区已有ZLUDA、HIPIFY、ROCm等尝试,但性能和兼容性仍有天花板。文章认为该构想短期不现实,却反映了CUDA生态锁定带来的真实痛点,长期看具有社区探索价值。
一个Reddit帖子引发的技术脑洞
最近在Reddit上,一位AMD Radeon用户发了一个帖子,标题直截了当:「Anyone feel like reverse-engineering CUDA?」
他的 motivation 很真实——作为A卡用户,他被排除在CUDA生态之外,而NVIDIA凭借CUDA在AI训练和推理市场建立了近乎垄断的地位。他观察到,现在有越来越多的modder用AI工具来逆向工程游戏和软件,比如用Photocraft、Gridcraft这类工具,甚至有人做出了GTA5里加入Sonic角色的mod。于是他提出一个大胆的想法:能不能用AI来生成一个开源的CUDA实现?
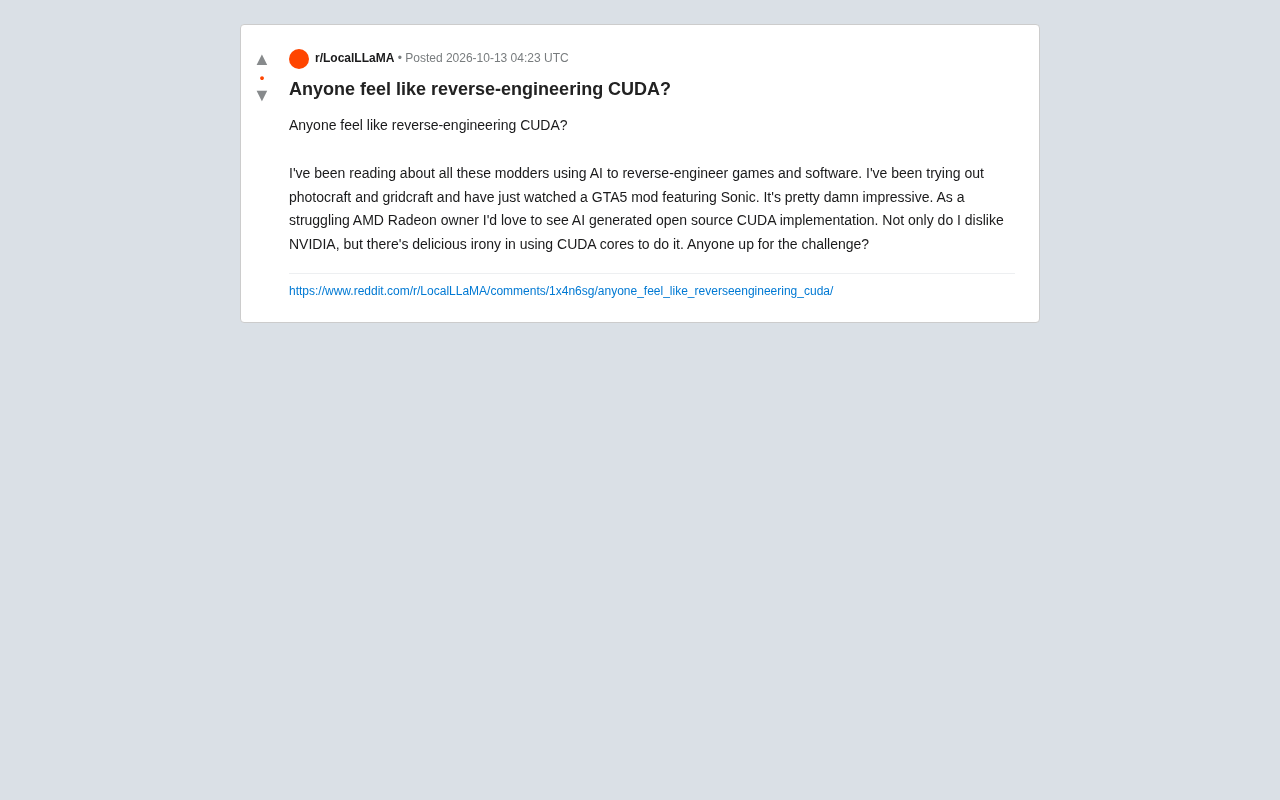
他还加了一句颇具讽刺意味的话:用CUDA核心来做这件事,本身就充满了「美味的讽刺」。
为什么这个想法既迷人又棘手
CUDA的护城河不只是技术
CUDA从2006年推出至今,已经积累了近二十年的生态沉淀。它不仅仅是一套API,还包括编译器(NVCC)、数学库(cuBLAS、cuDNN)、性能分析工具(Nsight)、以及无数框架和框架的框架(PyTorch、TensorFlow的GPU后端都深度绑定CUDA)。
要「逆向工程」CUDA,目标可以拆成好几层:
- 驱动层:让AMD GPU能执行CUDA的PTX中间码
- 运行时层:模拟CUDA runtime API(cudaMalloc、cudaMemcpy等)
- 库层:重写cuBLAS、cuDNN等核心数学库
- 编译器层:把CUDA C++代码转换成能在其他硬件上跑的代码
每一层都有不同的难度。社区其实已经有一些尝试,比如ZLUDA项目试图在AMD GPU上运行CUDA二进制,但它在性能和兼容性上都有明显天花板,而且一度因法律和资金问题中断。
PTX(Parallel Thread Execution) 是CUDA体系中的中间指令集架构,类似Java的字节码。NVIDIA编译器NVCC将CUDA C++源码先编译为PTX,再由驱动程序中的JIT编译器转换为特定GPU架构的SASS机器码。PTX的关键价值在于它提供了跨代GPU的兼容层:同一份PTX可以在不同架构的NVIDIA GPU上运行。因此「在AMD GPU上运行CUDA二进制」的最直接思路,就是实现一个能解析并执行PTX的运行时或转译层,把PTX转换为AMD GPU可执行的指令。ZLUDA正是走这条路,将PTX转换为AMD的GCN/RDNA指令。但PTX规范虽公开,其语义与硬件微架构的对应关系仍高度依赖NVIDIA的实现细节,这是转译层难以完美复现性能的根本原因。
HIP(Heterogeneous-compute Interface for Portability) 是AMD推出的类CUDA编程接口,语法与CUDA C++高度相似,配合HIPIFY工具可将大部分CUDA源码自动转换为HIP代码,再编译到AMD的ROCm平台或NVIDIA的CUDA后端。ROCm则是AMD的对标CUDA的完整开源软件栈,包含编译器、数学库和运行时。理解HIP与CUDA的对应关系很关键:HIP并非模拟CUDA,而是提供一套独立API,通过hipify实现源码级迁移,而非二进制级兼容。这意味着已有CUDA项目若想迁移到AMD,通常需要重新编译,且依赖的第三方库(如cuDNN)必须有对应的HIP版本(如MIOpen)才行。这也是为什么生态迁移远比API翻译困难。
AI逆向工程的实际能力边界
帖子中提到的「用AI逆向工程游戏」和「用AI逆向工程CUDA」之间存在巨大的鸿沟。游戏mod通常是在已有的PC版本上做内存修改、模型替换或脚本注入,本质上是在已知架构和API上做加法。而CUDA逆向涉及的是闭源编译器、专有指令集和硬件微架构,AI目前在这类任务上还远不能自主完成。
不过,这并不意味着AI无用。AI可以在以下环节提供助力:
- 反编译辅助:用大模型理解汇编代码片段、推断函数意图
- 代码翻译:将CUDA C++自动转译为HIP(AMD的异构计算接口)或SYCL
- 测试生成:自动生成大量测试用例来验证兼容性
- 文档补全:根据行为推断API语义
但这些都只是「辅助」,真正的架构级逆向仍然需要人类专家的深度参与。
反编译(Decompilation) 是指将机器码或汇编代码还原为高级语言代码的过程,是逆向工程的核心环节。传统反编译器如Ghidra、IDA Pro依赖模式匹配和控制流分析,但面对经过高度优化、内联展开的GPU内核代码时,可读性往往极差。大模型在此环节的潜力在于:它可以根据上下文推断变量语义、函数意图,甚至为混淆代码生成注释。然而,LLM存在幻觉问题,可能生成看似合理但语义错误的代码,因此在安全与正确性要求高的场景下,AI反编译的输出必须由人类专家复核。此外,CUDA内核涉及大量并行语义和内存层级细节,这些信息在汇编层面难以完整恢复,是AI辅助逆向目前的主要瓶颈。
社区反应与类似尝试
Reddit帖子的评论区(虽然原文未完整收录)通常会分成两派:一派认为这是技术浪漫主义,另一派会指出ZLUDA、HIPIFY等已有项目。事实上,AMD自己也在推ROCm和HIP,试图降低CUDA代码迁移的成本。
从更广的视角看,这个帖子反映的是一个真实痛点:CUDA的生态锁定效应。很多AI研究者和开发者即使想用AMD或Intel的GPU,也因为CUDA依赖而却步。如果有一个开源、跨平台的CUDA兼容层,整个AI硬件市场可能会更健康。
但也要清醒地看到,NVIDIA的护城河不只是软件API,还包括硬件和编译器之间的深度协同优化。逆向工程可以做到「能跑」,但要做到「跑得快且稳定」,难度是指数级上升的。
小结:一个值得认真对待的脑洞
这位Reddit用户的提问,表面上是「有没有人想一起干」,背后其实是对封闭生态的一种反抗。用AI辅助逆向工程CUDA,短期内不现实,但作为长期社区项目,它有探索价值。
如果你对这类项目感兴趣,可以从ZLUDA、HIPIFY、以及一些PTX到SPIR-V的转换工具入手,先了解已有的技术栈。也许下一个突破,就来自某个A卡用户的深夜灵光一现。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。