AI评测器真相:没有答案键,评分会有多不可靠?

77项研究显示:AI评测器的可靠性取决于它自己会不会做题,且错误系统性偏向放水。
作者梳理77项评测器研究发现,评测器判断对错的能力与它自身解题能力高度绑定:在它答错的题上,与专家一致性从0.78骤降到0.30。答案是验证过的答案键能显著修复这一问题,但有细微错误的答案键得分仅0.21,反而低于不给键的0.46。评测器的错误有方向性,19项研究中12项偏向误通过,大学证明题评分中即便给出评分标准仍有38%到45.7%的失败证明被误判为通过。顺序效应和格式效应也会显著改变判决。作者据此提出一套五步20样本的评测器检查流程,并强调在既无答案键、评测器又答不出的题目上,仍应保留人工审核。
用另一个模型来给AI的输出打分,已经成了很多团队评估系统的常规做法。但这个评分到底有多可信?一位作者梳理了77项相关研究后发现:没有经过验证的答案键(answer key),评测器恰恰在那些它自己也答不对的问题上最不可靠,而且它的错误还系统性地偏向"放水"。
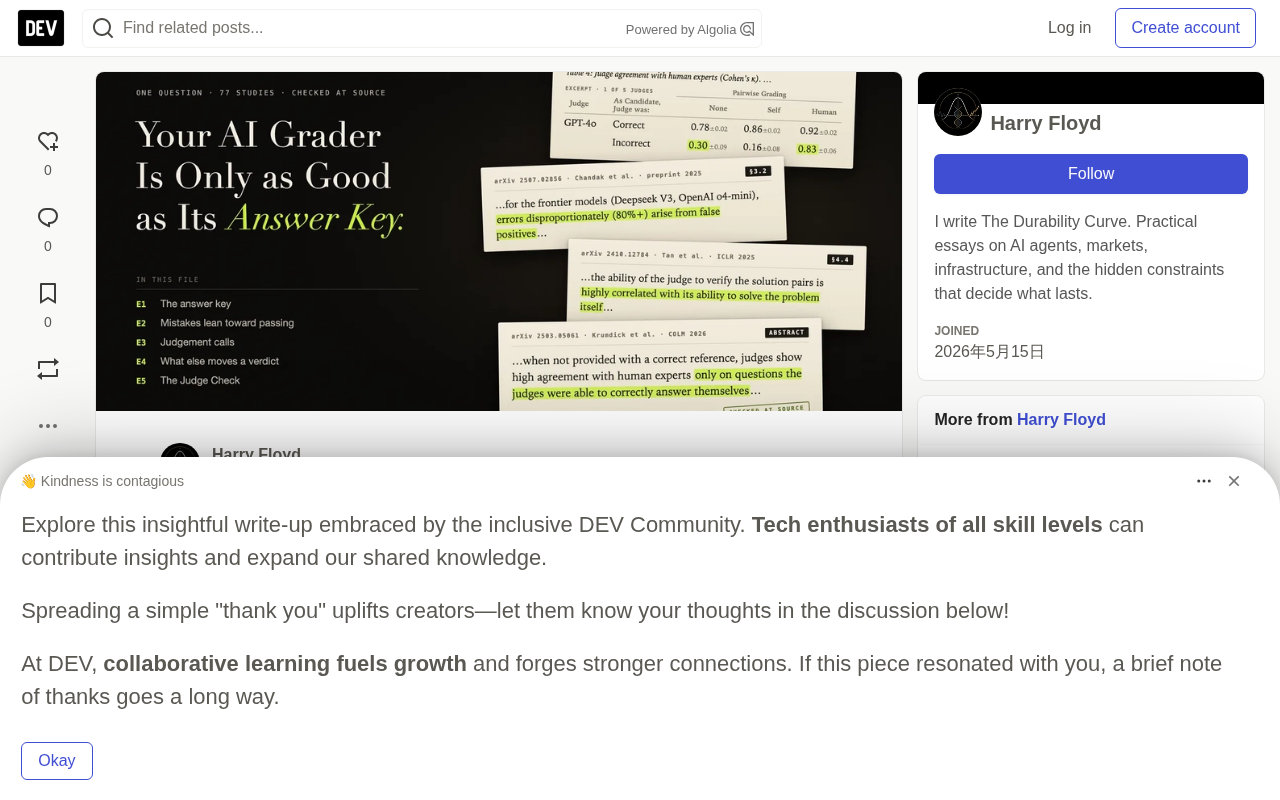
评测器的盲区:答不对的题,也判不准
作者在阅读研究前先写下了自己的预期:评测器在轻松的聊天式偏好判断上应该表现不错,在它自己解不出的难题和垂直领域上会失败。77项研究翻完,他发现漏掉了一个关键事实——学界早在2023年就提出了"给评测器一份参考答案"的修复方案,而后续研究则揭示了它在什么情况下有效、什么情况下会悄悄失效。
问题的核心在于一个已被反复验证的规律:评测器判断对错的能力,与它自己解题的能力高度相关。据JudgeBench的研究,评测器"检查答案"的能力和它"解决问题"的能力紧密绑定。GPT-4o在打分时,凡它自己答对的题目,与专家的一致性达到0.78(Cohen's κ);而它答错的题目,一致性骤降到0.30。换句话说,评测器越是不懂,越容易给出不可信的判断——而它不懂的地方,往往正是最需要被准确评估的地方。
Cohen's κ(Cohen's kappa) 是衡量两名评定者对同一批对象判断一致性的统计量,取值通常在0到1之间(也可能为负,表示低于随机一致)。它的关键优势在于扣除了“纯粹靠运气也能对上”的那部分一致:如果两个评定者各自独立地按相同比例随机打分,原始一致率可能不低,但 κ 会把这部分机会一致剔除。因此,κ=0.78 表示扣除机会一致后仍高度一致,κ=0.30 则仅属于“一般”甚至“勉强”水平。
在评测器场景里,κ 比原始一致率更能反映真实可靠性,因为评测任务中“通过/失败”的标签分布往往不均衡——比如绝大多数答案都是正确的,此时只要评测器无脑判“通过”,原始一致率也会很高。κ 能揭示这种虚高。不过 κ 也受标签分布影响:当某一类标签极其稀少时,κ 会被压低甚至出现悖论。所以读评测研究时,看到 κ 要同时留意样本的类别比例,最好结合混淆矩阵中的误通过、误失败数量一起判断,而不是只盯一个数字。
答案键为什么是刚需
2023年,MT-Bench的作者提出了一个朴素方案:让评测器先自己回答一遍,再把它自己的答案当作参考答案。在数学题上,这个做法把失败率从70%降到了15%。同年Prometheus的作者也发现,有了参考答案,评测器就不用自己去解那道题了。
但这个方法有个致命前提:评测器自己的答案必须是对的。一项横跨金融、数学和推理题、由领域专家打分的研究显示,没有正确答案作参考时,评测器只在它自己能答对的题目上与专家保持一致。GPT-4o的例子很直观:不用答案键时,它答对的题一致性0.78,答错的题只有0.30;而在它答错的题上,把自己(错误的)答案当键,一致性反而掉到0.16;换成专家的答案,则升到0.83。
关键在于"验证过的"答案键。作者测试的五款评测器中,如果答案键有细微错误,得分只有0.21——低于完全不给键(0.46),也低于给一个毫不相关的键(0.50)。而经人工核验的模型生成答案能拿到0.61,接近人工撰写的0.69。作者由此得出结论:在其实验设定下,核验模型的答案就足够了。
错误偏向放水,而非误杀
评测器的错误不是均匀分布的,而是有明显的方向性。作者找到19项报告了评测器"偏向哪边出错"的研究:12项偏向把本该失败的作品判为通过,3项偏向相反方向,4项混合。
大学级别的证明题评分最能说明问题。即便评测器手里拿着专家的评分标准,7个中有5个仍然把专家判定为失败的证明中38.0%到45.7%判成了通过,同时只误杀了5.0%到12.3%的正确证明。作者点出了一个关键区别:"评分标准告诉你该看什么,但这不等于告诉你答案是什么。"
代码审查则相反。对照书面规范检查代码时,GPT-4o在两个基准上分别误杀了26.2%和35.9%的正确程序,如果还要求它解释和修复代码,误杀率飙到73.2%和87.9%。所以如果你的评测器会点评或修复代码,也要统计它的误杀。
结论很明确:误通过和误失败要分开统计。只看总体一致性会掩盖方向性,而一个宽松的评测器会让你的系统看起来比实际更好。
误通过(false pass)与误失败(false fail) 是两类方向相反的错误,类比于统计检验中的假阳性与假阴性。误通过指评测器把一个实际不合格的答案判为合格,误失败指把一个实际合格的答案判为不合格。二者对系统的危害路径完全不同:误通过会让差答案混入训练数据、上线结果或排行榜,使系统表现被高估,且这种污染往往难以回溯;误失败则会大量丢弃本可用的正样本或误伤正确答案,降低迭代效率并可能让团队对模型能力产生悲观误判。
文章强调“分开统计”正是因为总体一致性会把两类错误相互抵消。如果一个评测器误通过很多、误失败也很多,总体准确率看起来可能只是中等,但实际上它在两个方向上都不可用。实践中应分别计算误通过率(实际失败中被判通过的比例)和误失败率(实际通过中被判失败的比例),并根据业务代价设定不同的容忍阈值:在内容安全、医疗建议等场景,误通过代价远高于误失败,宁可严;在需要大规模挖掘正样本的场景,则要重点压制误失败。
主观判断题:没有标准答案的难题
客观正确性可以有答案键,但主观判断没有,这正是作者预测部分成立的地方。
垂直领域的记录好坏参半。在依据文献回答的科学题上,最好的评测器o3与人类投票一致率65.1%,而随机猜测是50%。在临床评分中,最好的模型在5类任务中的3类达到了医生彼此之间的一致水平,但没有单一模型能覆盖全部5类;作者在少量医生评分案例上微调出的评测器达到了其中3类。HealthBench中,医生先撰写评分标准,OpenAI的GPT-4.1评测器在7个主题中的5个上超过了平均医生水平。
作者原本以为评测器在轻松的聊天偏好判断上会很稳,结果这条预测也没完全成立。GPT-4与专家标注者的一致率是85%,超过人类彼此之间的81%(去掉平局后);但把平局算进来,第一轮只有66%(成对评分)和60%(单答案评分),而人类之间是63%——大致就是人类水平。一项更严格的测试发现,没有任何模型能通过"统计上替代某位标注者"的检验。
标注者间一致性(inter-annotator agreement) 是主观任务里衡量“人类自己是否靠谱”的基准线。它的逻辑是:如果两位人类专家在同一批样本上的一致率只有63%,那么一个与某位专家一致率达到66%的评测器,其实已经达到了“大致相当于另一位人类标注者”的水平,而非明显更差。换言之,评测器在主观任务上不必追求接近100%——那可能连人类都做不到——而应以其可达到的标注者间一致性作为合理目标。
但这里有两个陷阱。第一,一致性目标取决于任务的可判定性:事实性问答、代码审查等有客观依据的任务,人类一致性本身就高,评测器理应逼近这一高线;而开放式创意写作、价值判断等任务,一致性天花板很低,拿高一致率要求评测器并不公平。第二,高一致性不等于高正确性。两名标注者可能共享同一种系统性偏见,于是互相一致却同时偏离真实标准。因此,在主观任务中,除了报告评测器与人类的一致率,还要报告人类彼此的一致率作为对照组,并尽量使用多位标注者、取多数投票或计算一致性区间,而不是与单一“专家”的标准答案对齐。
还有什么在左右判决
除了答案键,还有几个隐性因素会动摇评测结果。
顺序效应:交换两个答案的先后顺序,GPT-5.4在一个基准上改判的比例达11.4%,另一个基准10.5%;Gemini 3.1 Pro和Claude Opus 4.6则在2.0%到3.8%之间。
格式效应:同样的内容改成Markdown格式,五款评测器中有四款以73%到97%的比例偏好Markdown而非纯文本,而两位人类标注者在30对样本上只有57%的偏好率。
自我偏袒:评测器是否偏袒自己模型的答案仍有争议。有研究认为GPT-5对自己的错误答案格外宽容,另一项研究则把大部分自我偏袒归因于评测器在难题上的不确定。如果你的评测器和被评测的模型是同一个,最好专门测一测这种配置。
热门修复方案的效果被高估:由三个较小评测器组成的评审团在三个问答集上胜过单独使用GPT-4,但只与它自己的最佳成员持平。而当评测器本身不比它所评测的模型更强时,用少量人工标签来纠正它,最多只能把你需要的人工标签减半。
顺序效应与格式效应 属于评测中的非内容性偏差,即答案的语义没变、只是排版或呈现次序变了,判决却随之改变。顺序效应在成对比较中最常见:评测器被要求从 A、B 两个答案中选更好的一个,当把两者位置互换后,若它仍然偏好换到前面的那个,就说明它受位置而非质量驱动。这类偏差会在大规模自动评分中引入系统性噪声,尤其当被评测模型恰好总被排在某一位置时,结果会整体偏移。
格式效应则表现为评测器对 Markdown 标题、项目符号、加粗等结构化排版的偏好。文章数据显示,四款评测器对 Markdown 的偏好率高达73%到97%,而人类标注者只有57%,说明模型把“看起来更规范”误当成了“内容更好”。这对实际工作的启示是:比较不同系统时必须统一格式与呈现顺序,做A/B测试时最好随机化左右位置并交替格式,否则测出的可能只是排版差异。一种低成本的控制方法是在评测流程中加入“同一答案换格式/换顺序”的探针样本,若判决翻转率高,就说明该评测器在此任务上的裁决不够稳定,结论需要谨慎采信。
一套能上手跑的"评测器检查"
作者基于Hamel Husain和Eugene Yan的实践指南,扩展出了一套五步检查,共20个样本。它是一次筛查,能抓出宽松的评测器,但不能"放行"一个评测器——要真正信任一个评测器,Husain的指南建议每个失败模式准备约100个样本。
- 挑选20个你的评测器已经在评分的项目,其中至少10个是你已知错误的答案,然后自己给这20个项目打分。
- 让评测器跑两遍:先不给答案键,再用你验证过的答案作为键。开放性问题则给它一份"好答案必须做到什么"的清单。
- 对有唯一正确答案的题目,让评测器在独立的对话中分别作答。如果它答错超过一两道、并且把那些错误答案判为通过,就不要在没有答案键的情况下用它评这类题。
- 把相同的答案换一种排版(标题、项目符号、加粗),如果是成对评分则交换顺序,统计有多少判决发生了改变。
- 分开统计误通过和误失败。如果验证过的答案消除了误通过,就给你的评测器配上答案键;如果误通过依然存在,要么修正答案键,要么在这类项目上保留人工审核。
关键输出指标包括:已知错误项目数、无键时的误通过数、有键时的误通过数、误失败数、评测器答对/答错题目上的分别一致率,以及排版翻转数。作者在自己24道算术题的演示运行中,严格规则下得到4个已知错误、3个无键误通过、0个有键误通过、2个排版翻转,整次运行花费2.83美元。
一个可复现的结论
这篇分析的价值不在于给出某个具体数字,而在于揭示了一个被忽视的评估盲区:你用来评估AI的那个分数,本身可能就是一个未被评估的数字。评测器的能力边界与它自己的解题能力缠绕在一起,而它的错误又系统性地偏向"让系统看起来更好"。
作者给出的是一个可操作的判断:先给评测器配上验证过的答案键,然后数一数它到底放过了什么。在那些既没有答案键、评测器又答不出来的题目上,最稳妥的做法仍然是保留人工审核——因为恰恰是在这些地方,自动化评估最容易给出看似合理、实则错误的安心。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。