AI速报:Liquid决策模型与Saluki 27B本地部署盘点

本期AI速报聚焦本地可部署的开放权重模型与降价云API,核心主线是降低大模型落地的硬件与成本门槛。
本期AI速报梳理了四条对本地部署与成本控制友好的更新。Liquid AI放出3B与Omni 600M两款开放权重决策模型,以单次前向传播直接输出答案,3B版本综合评测均分82.9;Conway Research的Saluki 27B采用IQ2量化将27B模型压缩至约7.89GB,工具调用得分88分,支持llama.cpp与Docker,Apache 2.0商用友好;GitHub热榜出现一个"小而可组合"的工程师Agent技能库,兼容任意模型,MIT许可;Anthropic Claude Haiku 5.5上线,平均成本降低约75%,并首次支持可调Effort参数,允许开发者在响应质量与成本之间灵活权衡。整体趋势指向开源优先、本地可跑,大模型落地的硬件与API成本门槛正在持续下降。
本期AI速报聚焦几款新发布的开放权重模型与开源工具,核心关键词只有一个:本地能不能跑。从Liquid AI的决策模型,到约7.89GB的Saluki 27B,再到Anthropic的降价消息,这一轮更新对本地部署与成本敏感的开发者尤为友好。以下逐一梳理。
Liquid AI放出开放权重决策模型
据Hugging Face博客信息,Liquid AI放出了新一代开放权重决策模型,包含一个约3B参数版本与一个Omni 600M版本。这类模型的特点是单次前向传播直接输出答案,不依赖冗长的多步推理链,适合对延迟敏感的决策场景。
在公开评测中,3B版本取得了均分82.9的成绩。对于一个仅3B参数量级的模型来说,这个分数相当可观,意味着它在保持小体积的同时具备了不错的综合能力。600M的Omni版本则进一步压缩了部署门槛,适合资源受限的边缘端或移动端尝试。
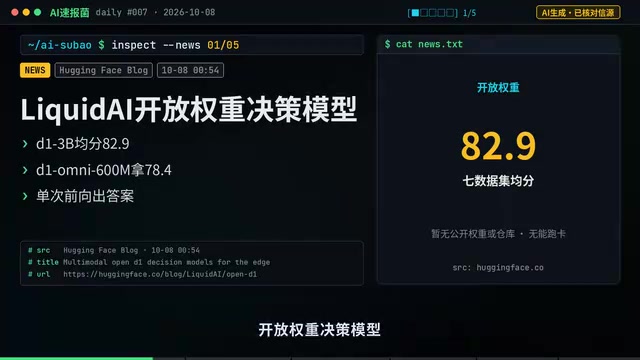
决策模型这一方向近来受到关注,原因在于它把"推理"压缩进单次前向,省去了反复采样和长链思考的开销。对需要快速响应的Agent系统而言,这种设计能显著降低响应时间与推理成本。
**决策模型(Decision Model)**与当前主流的推理模型(如o1、DeepSeek广告-R1系列)在架构哲学上存在根本差异。推理模型通过生成大量中间步骤(Chain-of-Thought)来提升准确率,代价是输出token数量成倍增长,延迟与成本随之上升。决策模型则将推理能力"内化"到权重中,训练阶段通过大量决策数据让模型直接学会从输入映射到最优输出,推理阶段仅需一次前向传播(forward pass)即可得到答案。这种设计在要求毫秒级响应的场景中优势明显,例如实时游戏AI、高频交易信号生成、机器人运动控制等。代价是模型的"推理过程"不透明,难以调试,且在需要多步逻辑推导的任务上通常弱于同等规模的推理模型。Liquid AI此前以其自研的LFM(Liquid Foundation Model)架构著称,该架构基于液态神经网络理论,与Transformer有所不同,这也是其能在小参数量下取得较高综合评测分数的潜在原因之一。
Saluki 27B:27B模型压到约7.89GB
Conway Research放出了Saluki 27B的模型卡。最引人注目的是它的量化配置——采用IQ2量化,使得27B参数的模型文件被压缩到约7.89GB。这意味着一张消费级显卡甚至部分核显设备都有机会尝试运行一个27B级别的模型。
模型卡中提到其工具调用(tool calling)得分88分,表明它在Agent场景下的函数调用能力经过了专门优化。许可方面采用Apache 2.0,商用友好,开发者可以自由集成到自己的产品中。
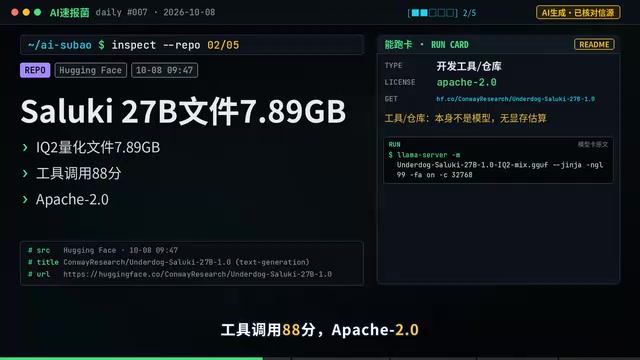
部署方式上,Saluki 27B可通过llama.cpp在本地CPU或GPU上运行,也支持Docker容器化部署。IQ2量化虽然会带来一定的精度损失,但对于想在有限硬件上体验大模型的用户来说,7.89GB的体积与27B的参数规模之间取得了一个值得尝试的平衡点。
IQ量化是llama.cpp生态中引入的一套基于"重要性加权"的非均匀量化方案,与传统的Q4/Q8等均匀量化不同。传统量化对模型所有层的权重一视同仁地压缩精度,而IQ量化会根据每个权重对输出的重要程度分配不同的比特数——对模型输出影响大的权重保留更高精度,影响小的权重则压缩更激进。IQ2意味着平均每个权重约占用2比特,是目前主流量化方案中压缩率最高的档位之一,因此27B参数的模型才能压缩到接近8GB。相比之下,同等参数量的Q4量化通常需要约14-16GB,Q8则需要约28GB。IQ2的精度损失在知识密集型任务(如事实问答)上会更为明显,但在结构化输出、工具调用等任务上损失相对可控,这也解释了为何Saluki 27B会专门标注工具调用得分作为核心指标。
开源Agent工具与Skills登上GitHub热榜
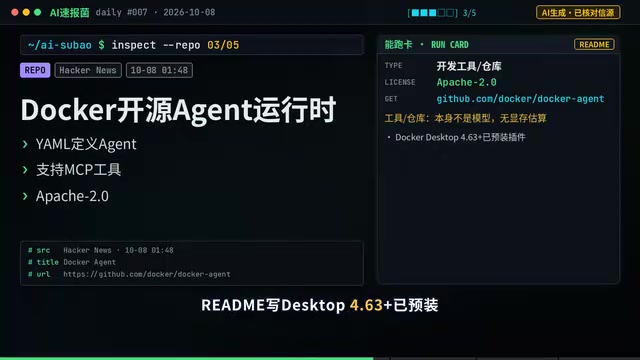
工具生态方面,本期有两个项目值得关注。其一是一个用agent.yml定义Agent的开源框架,支持MCP(Model Context Protocol),同样采用Apache 2.0许可,README中提到其Desktop版本预装了相关依赖,开箱即用程度较高。
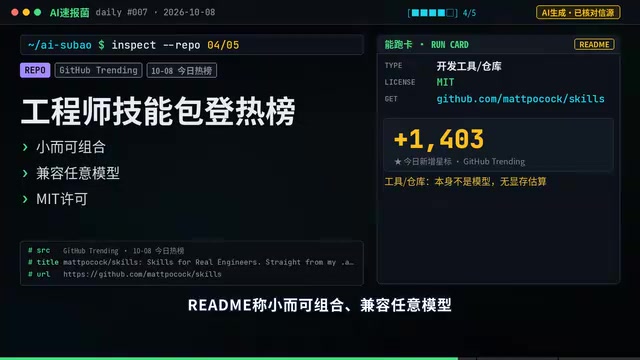
其二是一个登上GitHub热榜的工程师Agent技能库(Skills)。它的设计思路是"小而可组合",各项技能模块化拆分,可以灵活拼装,并且兼容任意模型,采用更为宽松的MIT许可。这种可组合的技能设计正成为Agent工具的主流范式——不绑定特定模型、按需组装能力,降低了迁移和集成成本。
**MCP(Model Context Protocol)**是Anthropic于2024年底提出并开源的一套标准化协议,旨在解决AI模型与外部工具、数据源之间的接口碎片化问题。其设计思路类似于编程语言的LSP(Language Server Protocol)——定义一套通用的Client-Server通信规范,让任意模型(Client)都能通过统一接口调用任意工具(Server),无需为每对组合单独开发适配层。MCP的Server端可以暴露工具(Tools)、资源(Resources)和提示模板(Prompts)三类能力,Client端按需发现和调用。目前已有文件系统、数据库、浏览器控制、代码执行等数十个官方及社区MCP Server实现。对于Agent框架来说,支持MCP意味着可以直接复用整个MCP生态的工具库,而不必自己从零实现工具集成逻辑,这大幅降低了新框架的冷启动成本。
Anthropic Claude Haiku 5.5上线,成本降约75%
据Anthropic官网消息,Claude Haiku 5.5正式上线。官方称其平均成本约降低75%,这对高频调用、预算敏感的应用是重大利好。Haiku系列定位轻量快速,大幅降价意味着在批量处理、客服、数据清洗等场景下的使用门槛进一步下探。
此外,Haiku 5.5首次支持可调Effort参数,允许开发者在响应质量与成本/速度之间自行权衡——需要更深思考时调高Effort,追求低延迟时调低。这种细粒度的成本控制能力,正是生产环境中真正需要的。
Effort参数(也称Extended Thinking或Thinking Budget)是近期多家主流API提供商相继推出的推理成本控制机制。其底层原理是控制模型在生成最终回答前所允许消耗的"思考token"上限——Effort越高,模型可以生成越长的内部推理链,最终答案质量通常更好,但耗时与费用也成比例上升;Effort调低时模型快速给出答案,适合无需深度推理的简单任务。OpenAI的o系列以reasoning_effort参数(low/medium/high)实现类似功能,Google Gemini则以thinking_budgettoken数来控制。对于生产环境中同一应用需要同时处理"简单查询"和"复杂分析"两类请求的场景,Effort参数允许开发者在请求级别动态调整推理深度,而不必为不同任务维护多个模型部署,是降低整体推理成本的实用手段。
小结
本期几条更新有一条共同主线——开源优先、本地可跑。Liquid的小体积决策模型、IQ2量化后仅7.89GB的Saluki 27B、可组合的Agent Skills,都在降低大模型落地的硬件与成本门槛;而Anthropic的降价则从云端一侧呼应了同样的趋势。对开发者而言,先看能不能在本地跑起来,依然是评估一款新模型最务实的起点。
相关推荐

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。

Costco科技产品价格竞猜:显示器、键鼠、Bose音响值不值?
YouTube博主在Costco竞猜科技产品价格:2K 180Hz显示器、罗技键鼠、Bose音响和CyberPower UPS实测估价,揭示仓储会员店的选品定价逻辑与品牌溢价真相。