AI图像编辑为何总是越改越崩?一致性困境深度解析
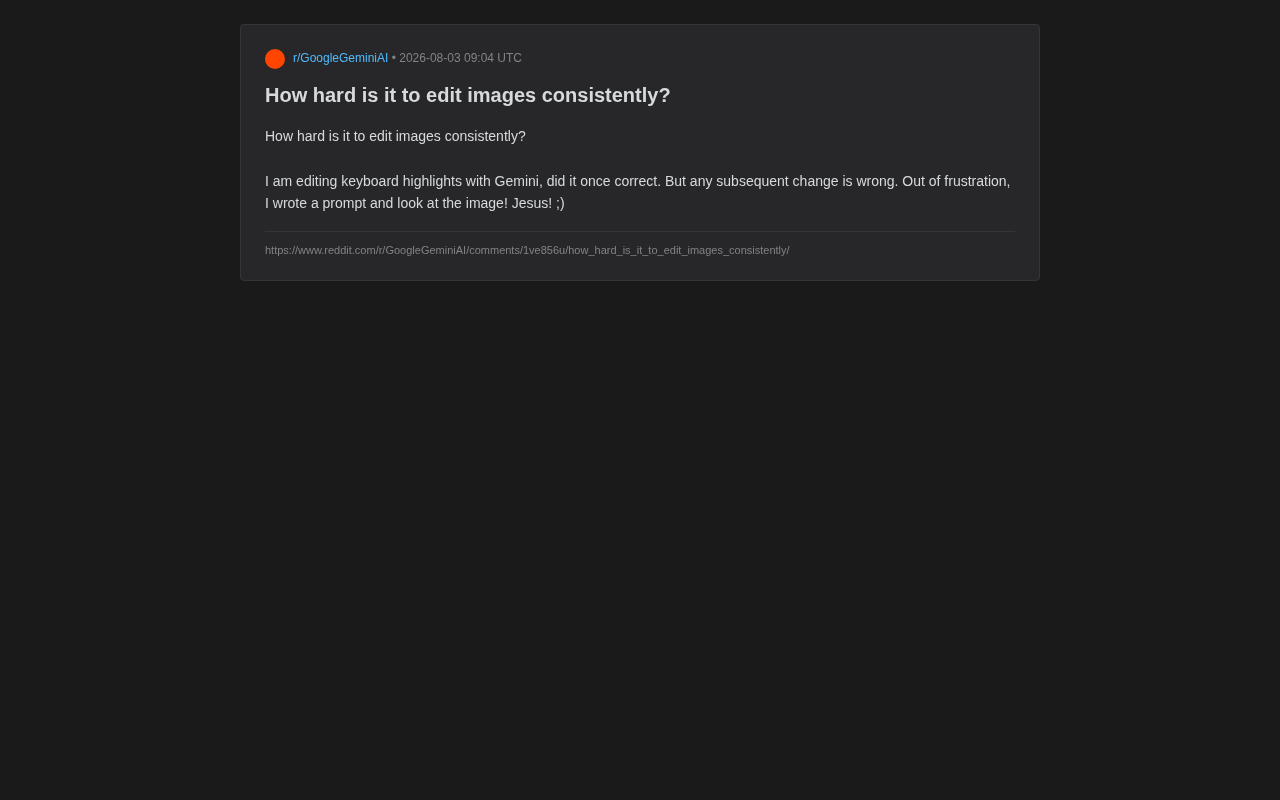
一个来自Reddit的真实吐槽
近日,一位Reddit用户分享了他使用Google Gemini进行图像编辑的经历,引发了不少共鸣。他的任务看似简单——编辑键盘的高光效果。第一次尝试,AI给出了正确的结果。但当他试图进行后续的连续修改时,结果却屡屡出错,最终在挫败之中,他随手写了一个提示词,得到的图像让他哭笑不得。
这个看似轻松的吐槽背后,其实揭示了当前生成式AI在图像编辑领域一个非常核心且棘手的问题:一致性(Consistency)。
为什么AI图像编辑难以保持一致?
生成模型的本质是「重新想象」而非「局部修改」
很多用户对AI图像编辑存在一个误解,认为它像Photoshop那样是在「局部修改」现有像素。但实际上,大多数基于扩散模型(Diffusion Model)的生成式编辑,本质上是在根据你的提示词重新生成整张或大部分图像。
扩散模型是当前主流的图像生成架构,其工作原理分为两个核心阶段:前向扩散过程逐步向图像添加高斯噪声,直到图像变成纯随机噪声;反向去噪过程则训练神经网络学会从噪声中逐步恢复出清晰图像。Stable Diffusion、DALL·E 3、Imagen等知名模型均基于这一框架。扩散模型的数学基础源自非平衡热力学,由Jascha Sohl-Dickstein等人于2015年首次提出,后经2020年Jonathan Ho等人的DDPM(Denoising Diffusion Probabilistic Models)论文推广至图像生成领域。其核心思想借鉴了物理学中的扩散过程:正如墨水滴入水中会逐渐扩散至均匀分布,前向过程通过马尔可夫链逐步将数据分布转化为简单的高斯分布,反向过程则学习这一扩散的逆操作。与此前主流的GAN(生成对抗网络)相比,扩散模型训练更稳定、模式崩溃问题更少,但推理速度较慢——这也催生了LCM(Latent Consistency Model)、SDXL Turbo等加速方案。
值得一提的是,在扩散模型崛起之前,GAN统治图像生成领域长达近7年(2014-2021)。GAN由生成器和判别器组成,通过对抗训练实现图像生成,但长期受困于训练不稳定、模式崩溃(生成器只学会产生有限种类的输出)以及难以控制生成多样性等问题。2021年OpenAI的DALL·E和2022年Stability AI的Stable Diffusion标志着扩散模型正式取代GAN成为主流。这一范式转换的深远影响在于:扩散模型将图像生成从「对抗博弈」重新定义为「逐步去噪」的过程,使训练目标更加清晰、优化更加稳定,但也引入了推理速度慢和编辑一致性差等新问题。
此外,现代扩散模型(如Stable Diffusion)实际上并非直接在像素空间进行扩散和去噪,而是在一个压缩后的潜在空间(Latent Space)中操作。这一创新由Robin Rombach等人在2022年的LDM(Latent Diffusion Models)论文中提出,通过VAE(变分自编码器)先将图像压缩到低维潜在表征,再在该空间中执行扩散过程,最终通过VAE解码器将结果映射回像素空间。这种设计将计算成本降低了数十倍,使消费级GPU也能运行图像生成。但这种压缩也意味着信息损失——潜在空间中的微小变化经过解码后可能在像素空间产生显著的视觉差异,这进一步加剧了编辑一致性的挑战。
在编辑场景中,模型通常会对原图施加一定程度的噪声,然后在文本条件引导下重新去噪——这意味着输出本质上是一次「有条件的重新生成」,而非对像素的直接操作。
这就解释了为什么第一次编辑可能正确,而后续修改却频频翻车。每一次生成都带有随机性(由种子seed和采样过程决定),模型并不会真正「记住」上一次生成的确切结果。在技术层面,随机种子决定了初始噪声的具体模式,而采样器(Sampler,如DDPM、DDIM、Euler、DPM-Solver等)则决定了从噪声到清晰图像的去噪路径。值得进一步说明的是,CFG(Classifier-Free Guidance)引导强度是控制生成图像与文本提示词匹配程度的关键超参数——CFG值越高,生成结果越严格遵循提示词,但也可能导致图像过饱和或出现伪影;值越低则给予模型更多创意自由度,但可能偏离用户意图,典型的推荐范围为7-12。采样器方面,DDIM允许确定性采样(在固定seed下可精确复现结果),而随机采样器如祖先采样(Ancestral Sampling)则在每一步引入额外随机性,使得即便seed相同也可能产生差异。即使使用相同的提示词,不同的seed会产生完全不同的图像;而即便固定了seed,采样步数或CFG引导强度的微小变化也可能导致输出差异。当你要求模型「再改一点」时,它可能会连带改变那些你本不希望触碰的区域,比如键盘的整体布局、颜色甚至形状。
连续编辑中的误差累积效应
更麻烦的是误差累积问题。当你在同一张图上进行多次连续编辑时,每一次生成引入的微小偏差都会被下一次编辑继承并放大。这类似于「复印件的复印件」,几轮下来,原始图像的关键特征已经面目全非。这位Reddit用户遇到的「越改越错」,正是这一机制的典型表现。
一致性问题的技术根源
文本提示词缺乏精确的空间控制能力
纯文本提示词(Prompt)在描述「哪里要改、改多少」时天然是模糊的。你告诉模型「调整键盘高光」,但模型无法准确理解你指的是哪几个键、光泽度要提升多少。这种语义与像素之间的鸿沟,使得精确、可复现的编辑变得极其困难。语言本身是离散和抽象的,而图像编辑需要的是连续且精确的空间控制——「左上角第三个键的反射高光亮度提升15%」这样的指令,远远超出了当前文本-图像对齐技术的能力边界。
当前主流的文本-图像对齐依赖CLIP等对比学习模型建立的共享语义空间,但这一空间本质上优化的是高层语义匹配(如「猫」与猫的图像),而非低层视觉属性的精确映射(如特定区域的亮度数值),这正是精确编辑难以实现的底层原因。CLIP(Contrastive Language-Image Pre-training)由OpenAI于2021年发布,通过在4亿个图文对上进行对比学习训练,构建了文本与图像之间的共享语义空间。CLIP的训练目标是让匹配的图文对在嵌入空间中距离更近,不匹配的更远。这种训练方式使CLIP具备了强大的零样本分类能力和跨模态理解能力,但其学到的是统计相关性而非因果关系。例如,CLIP理解「键盘」意味着某种视觉模式,但无法理解「高光」在物理光学中的具体含义——反射角度、材质的BRDF(双向反射分布函数)、光源位置等精确信息完全超出了CLIP的表征能力。
模型上下文记忆的局限性
虽然像Gemini这样的多模态模型具备一定的上下文理解能力,但在图像生成任务中,模型对「视觉状态」的保持能力仍然有限。Gemini等多模态大模型(Multimodal Large Language Model, MLLM)通过将视觉信息编码为token序列,与文本token一起送入Transformer架构进行联合处理。具体而言,视觉编码器(如ViT,Vision Transformer)首先将图像分割为多个patch并编码为embedding向量序列,然后通过投影层将视觉token映射到与文本token相同的表征空间。这一过程中,原始图像的分辨率通常会被大幅降低——例如一张1024×1024的图像可能被压缩为256或576个视觉token,这意味着每个token需要代表大量像素信息。这种信息压缩是模型高效推理的前提,但也是像素级精确控制的天然瓶颈。Transformer的上下文窗口是有限的,且视觉信息经过编码器压缩后不可避免地丢失了大量底层像素细节。模型在推理时更多依赖语义级别的理解,而非像素级别的精确记忆——它能理解「这是一个键盘」,却难以精确维持键盘上每个键帽的高光角度和反射强度。
这也是为什么专业设计工作流至今仍高度依赖图层、蒙版等确定性工具。Photoshop等专业工具之所以在精确编辑中不可替代,核心在于其确定性操作范式:图层系统允许非破坏性编辑(每一步修改都可独立撤销和调整),蒙版提供像素级的区域控制,混合模式和不透明度则给予设计师对视觉效果的精确数值控制。这种「所见即所得、所改即所改」的范式与生成式AI的概率性输出形成了根本性对比。当前业界的趋势是将两者结合——例如Adobe在Photoshop中集成的Generative Fill功能,即是在传统图层/蒙版架构之上叠加生成式AI能力的典型案例。
实用技巧:如何缓解AI图像编辑的一致性问题
使用Inpainting局部重绘与蒙版
如果工具支持局部重绘(Inpainting),尽量圈定需要修改的具体区域,而非让模型重新生成整图。这样可以最大限度保留未选中区域的原始像素,避免「牵一发而动全身」。
Inpainting是计算机视觉中的经典问题,传统方法依赖纹理合成和偏微分方程来填补缺失区域。在扩散模型时代,这一技术被重新定义:用户通过蒙版(Mask)标记需要修改的区域,模型仅对蒙版覆盖的部分施加噪声并重新生成,而蒙版外的区域则保留原始像素。Stable Diffusion的Inpainting专用模型、Adobe Firefly的生成填充(Generative Fill)、以及Photoshop中集成的AI功能都采用了这一思路。需要注意的关键技术挑战在于新生成区域与保留区域之间的边缘过渡自然度,以及语义一致性——新内容需要在光照、透视和风格上与周围环境完美匹配。实践中,适当扩大蒙版边缘的羽化范围(通常建议蒙版边界向外扩展8-32像素)可以有效改善过渡区域的融合效果。
固定随机种子提升可复现性
在支持种子控制的工具中,固定seed可以让生成结果更具可复现性。虽然不能完全解决问题,但能减少每次生成之间的随机跳变。需要注意的是,seed的固定效果与采样器的选择密切相关:使用确定性采样器(如DDIM)时,固定seed几乎可以保证完全相同的输出;而使用包含随机步骤的采样器时,即使seed相同,批次大小、分辨率等参数的变化也可能导致结果偏移。在Stable Diffusion WebUI、ComfyUI等开源工具中,用户可以精确控制这些参数;而在Gemini、ChatGPT等商业API中,seed控制的粒度通常更为有限。
一次性表达完整编辑意图
与其分多次逐步微调,不如在一个提示词中尽可能完整、精确地描述最终想要的效果。减少编辑轮次,就能减少误差累积的机会。这也解释了为何用户「出于挫败随手写的一个提示词」反而可能得到意外结果——虽然那次是负面案例,但完整描述确实是更稳妥的策略。在提示词工程(Prompt Engineering)实践中,结构化描述被认为比自由文本更有效:先描述整体场景和主体,再添加细节修饰,最后指定风格和质量参数。例如「一个机械键盘,RGB背光,键帽上有柔和的漫反射高光,整体偏冷色调,工作室灯光,8K渲染质感」比简单的「调整键盘高光」更可能产生预期结果。
选择专用的指令式编辑模型
针对一致性需求,业界已经出现了一些专门优化的方案,比如支持指令式编辑(Instruction-based Editing)的模型,它们在保持原图结构方面做了专门训练,比通用生成模型在编辑场景中表现更好。
指令式编辑的代表性工作是2023年由Tim Brooks等人提出的InstructPix2Pix模型。该模型通过大规模的「编辑指令-图像对」数据集进行训练,使模型能够理解自然语言编辑指令(如「让天空变成日落色」)并直接在原图上执行修改,而无需用户提供参考图或精确蒙版。其训练数据集的构建本身就是一项创新工程——研究团队使用GPT-3生成编辑指令,再用Prompt-to-Prompt技术生成对应的编辑前后图像对,从而以低成本构建了大规模训练数据。
Prompt-to-Prompt是由Amir Hertz等人于2022年提出的注意力控制技术,是理解指令式编辑如何实现的关键基础。其核心发现是:在扩散模型的去噪过程中,交叉注意力(Cross-Attention)层的注意力图直接决定了图像的空间布局——每个文本token的注意力权重映射到图像的特定区域。通过在编辑前后的两次生成中,保持或交换特定层的注意力图,可以实现只修改特定语义元素而保持其余部分不变的效果。例如,将提示词从「一只猫坐在沙发上」改为「一只狗坐在沙发上」时,通过替换「猫/狗」对应的注意力图、保留其余注意力图,就能仅替换动物而保持背景和构图不变。这一技术为后续的可控编辑研究奠定了重要基础。
后续的MagicBrush、HIVE、InstructDiffusion等工作进一步提升了编辑精度和结构保持能力。Google的Imagen Editor以及最新的Gemini图像编辑功能也融入了类似的指令理解机制,但如本文所述,在多轮连续编辑场景中,这些模型仍面临显著的一致性挑战。
写在最后:期待更可控的AI编辑时代
这位Reddit用户的经历,代表了大量普通用户在拥抱AI创作工具时的真实困惑。生成式AI在「从无到有」的创作上已经展现出惊人能力,但在「精确、可控、可迭代」的编辑场景中,它离专业工具仍有明显差距。
一致性问题不仅仅是用户体验的痛点,更是当前生成式模型架构的根本性挑战。未来,随着可控生成技术、区域感知编辑以及更好的上下文状态管理的发展,我们有理由相信这一困境会逐步得到改善。在可控生成(Controllable Generation)领域,ControlNet通过引入额外的条件分支(如边缘检测图、深度图、人体姿态骨架等),让用户在生成过程中施加精确的空间约束。ControlNet由Lvmin Zhang和Maneesh Agrawala于2023年提出,其创新在于通过「零卷积」(Zero Convolution)层将额外的条件控制分支接入预训练扩散模型的编码器中,无需重新训练基础模型即可添加精确的空间控制能力。这一设计既保留了基础模型的生成质量,又实现了细粒度的结构引导,目前已支持十余种控制类型,包括Canny边缘、HED软边缘、OpenPose人体骨架、深度图、法线图、语义分割图等。IP-Adapter则允许用户通过参考图像来控制生成风格和内容一致性;T2I-Adapter、UniControl等工作进一步统一了多种控制信号。在商业产品层面,Midjourney的「--cref」和「--sref」参数、Runway的Motion Brush、Krea AI的实时引导生成等功能都是可控生成技术的应用体现。这些技术的快速发展,正在从多个维度逐步攻克一致性难题。
值得关注的前沿方向还包括:基于3D表征的编辑方法(通过NeRF或3D Gaussian Splatting建立场景的三维理解,从而实现视角一致的编辑)、基于视频扩散模型的时序一致性技术(其帧间一致性机制有望迁移至图像编辑的多轮一致性问题)、以及将传统图形学的确定性操作与生成式AI结合的混合架构。NeRF(Neural Radiance Fields)由Ben Mildenhall等人于2020年提出,通过隐式神经网络表征三维场景的颜色和密度场,仅从多视角2D照片即可重建出可自由视角渲染的3D场景。3D Gaussian Splatting则是2023年由Bernhard Kerbl等人提出的替代方案,使用大量三维高斯分布显式表征场景,实现了实时渲染速度。这两种技术在图像编辑中的潜在价值在于:如果模型能建立对场景的三维理解,那么光照变化、视角调整等编辑操作就可以基于物理正确的三维关系来执行,而非在二维像素平面上「猜测」,从而从根本上解决编辑一致性问题。目前,Instruct-NeRF2NeRF等工作已展示了基于3D表征的文本引导编辑能力。这些研究方向共同指向一个目标:让AI不仅能「想象」出好看的图像,更能像专业工具一样精确地「执行」编辑操作。
在那之前,理解模型的工作原理、掌握正确的使用技巧,仍是每一位AI创作者的必修课。
核心要点
- AI图像编辑的本质是重新生成:基于扩散模型的编辑并非局部像素修改,而是在潜在空间中对整张图像进行有条件的重新生成,这从根本上导致了编辑结果的不确定性。
- 一致性是当前最核心的技术瓶颈:文本提示词缺乏精确空间控制、模型上下文记忆有限、连续编辑的误差累积效应,三者共同构成了AI图像编辑的一致性困境。
- 实用缓解策略:使用Inpainting局部重绘缩小修改范围、固定随机种子提升可复现性、一次性表达完整编辑意图减少迭代轮次、选择InstructPix2Pix等专用指令式编辑模型。
- 未来方向值得期待:ControlNet等可控生成技术、基于NeRF/3D Gaussian Splatting的三维感知编辑、以及传统图形学与生成式AI的混合架构,正在从多个维度逐步攻克一致性难题。
相关推荐

M&M's斥资数百万换掉人工蓝色素,为什么这么难?
玛氏公司投入数百万美元,试图用螺旋藻天然色素替代M&M豆中的人工蓝色素,却因物料浓稠堵塞管道、残留物引发霉菌风险而被迫改造整条产线。本文解析这场配方迁移背后的工程难题、消费者与监管推力,以及"无人工色素不等于健康"的清醒判断。

Meta全球AI开发者黑客松组队需求:计算机视觉与医疗AI方向
Reddit开发者发帖为Meta Global AI Developer Hackathon招募队友,方向聚焦计算机视觉与医疗AI。本文分析这一组队信号背后的赛道逻辑、技能互补需求与黑客松选题策略。

Claude 多个模型报错:Fable 5.1、Sonnet 5.5、Haiku 5.5 故障复盘
Claude Fable 5.1、Sonnet 5.5、Haiku 5.5 及 Opus 5.5 fast mode 出现错误率升高,官方 17 分钟内完成定位与恢复。本文梳理故障时间线、多模型连带故障的技术原因,以及对开发者重试与降级策略的实际启示。