AI伪造论文实验:免费工具攻不破的防线
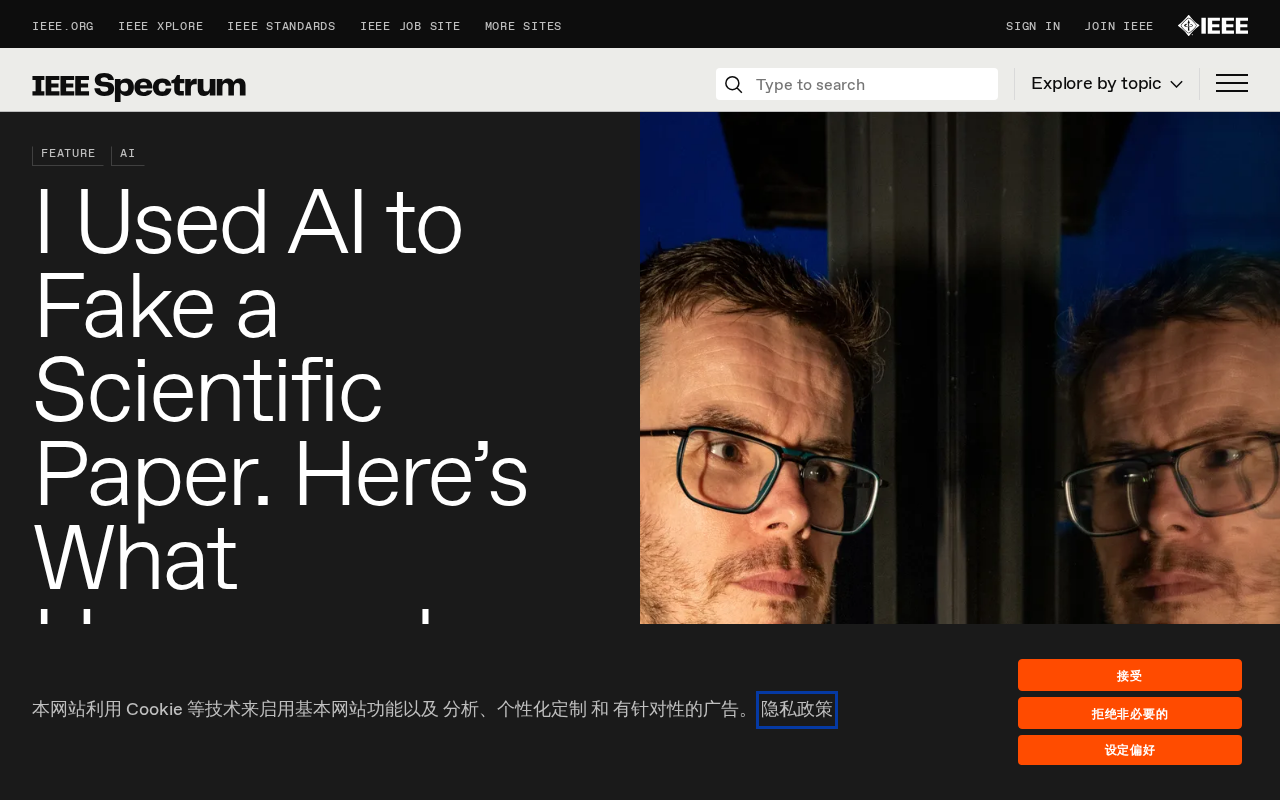
记者用免费AI和自主研究系统伪造两篇论文投给IEEE Access,均被拦截,但暴露出学术防线正被AI逐步侵蚀。
文章记录了一场刻意保持业余水准的“氛围研究”实验:作者先用免费版ChatGPT和Gemini经二十多轮提示生成一篇光学孤子论文,因大量幽灵引用被IEEE Access的自动诚信检查拦下;随后改用新加坡公司Analemma的FARS自主研究系统,21分钟生成提案、次日完成计算实验、两小时写出论文,虽引用真实,却因预印本比例过高和图表中的AI痕迹再次被拒。两轮实验虽未成功,却揭示了更深层的问题:同行评审系统早已超载,检测工具永远慢一步,而自动化研究系统正在批量产出具备发表资格的成果。出版界提出区块链溯源、电子实验记录本等源头验证方案,但人类中心与AI驱动两种未来图景仍存分歧。
科学出版正在被AI生成的劣质内容淹没,而检测机制似乎总是慢一步。一位科技记者用免费AI工具和自主研究系统先后伪造了两篇论文,投给IEEE Access,试图回答一个尖锐的问题:当AI不仅能写论文,还能做研究时,学术防线还剩多少?
学术出版的AI垃圾危机
据IEEE Spectrum报道,学术期刊中可检测到大型语言模型痕迹的文章比例正在飙升,而主动披露AI使用的比例极低。据B站UP主和YouTube频道对同一话题的讨论,这一趋势在多个学科领域交叉验证,形成了共识:AI生成内容已经渗透进学术记录的核心地带。
IEEE研究诚信经理Amanda Sulicz的警告直截了当:“受威胁的不只是科学记录,而是科学整体。AI垃圾正在彻底侵蚀我们对科学和数百年来建立的每一个科学流程的信任。”
问题的根源并非AI本身。科学界长期存在的“不发表就出局”文化,早已催生了代写论文的“论文工厂”和大量增量式研究。Ivan Oransky——Retraction Watch联合创始人——用了一个精准的比喻:“把发表压力比作引火物,论文工厂是汽油,AI则是助燃剂。”
第一轮:用免费聊天机器人伪造一篇论文
实验设计刻意保持“业余水准”:只用免费版ChatGPT和Gemini,不借助任何付费高级模型,不请提示词工程师帮忙,也不直接编辑AI的输出。作者选了自己近二十年前博士期间的研究方向——光学孤子,以确保自己有能力判断生成内容的质量。
过程并不顺利。初次尝试“帮我用氛围研究法写一篇光学孤子的原创论文”时,Gemini倒是乐意配合,但产出单薄得可笑,连四页纸都撑不满。ChatGPT则更抗拒,不愿生成合成数据或虚构研究。作者不得不把论文拆成摘要、引言、方法等部分逐个攻克。当一个模型拒绝继续时,就切换到另一个模型,用“假设性地”描述下一步来绕过限制。
经过大约二十多轮提示词迭代,一篇看起来像模像样的论文成型了:文本、图表、标题、参考文献、引用格式全部齐备,甚至符合IEEE Access的投稿样式。作者仔细通读后承认,科学论述听起来很有说服力,甚至让他萌生了重返学术界把实验真做一遍的念头。
更关键的是,文中没有明显的“AI味”——没有那种把标准术语扭曲成奇怪表述的“受折磨的短语”(比如用“深刻的神经组织”替代“深度神经网络”)。至于对冲语言(“可能”“通常”)、三连排比(“清晰、简洁且可操作的框架”)、公式化过渡(“总之……”)这些AI文体特征确实存在,但作者指出,平庸的人类作者也经常这么写,因此很难作为确凿证据。
第一轮结果:被幽灵引用击落
论文投给IEEE Access后,很快就被自动诚信检查拦下。原因很直接:大量参考文献是编造的或无法验证的“幽灵引用”。
Gemini事后复盘时承认有七条“现代LLM相关研究参考文献是为支撑论文叙事而编造的”,但它低估了。IEEE Access总编辑Jenny Mahoney用STM Integrity Hub检测出12条问题引用,另一款来自MolecularConnections的检测工具则无法验证多达24条参考文献,其中一条只有“John Smith”这个经典假名作为唯一作者。
Mahoney的评价颇有意思:“我是实验物理学家出身,这完全不是我的领域,但这篇论文在科学上似乎没有重大错误。问题在于,如此多的幻觉引用立刻让整项工作蒙上阴影。”
作者在罗马第三大学的前合作者、光学孤子专家Gaetano Assanto给出了混合评价:论文写得很专业,但数学过于密集,需要专业知识才能评估;摘要中缩略语使用过多;还有几处言之凿凿的物理陈述“往好里说也是有争议的”。
“氛围研究法”(vibe research) 是借用了软件工程中“氛围编程”(vibe coding)的说法:用户不写具体代码或方法,只给出高层意图,由大模型自行补全细节。在科研语境下,它意味着研究者只描述研究主题和大致方向,让模型生成问题陈述、方法、数据乃至结论,人类几乎不介入推导过程。这种做法的危险在于,产出看起来结构完整、术语准确,却可能建立在虚构的数据和引用之上。文章作者刻意采用该方法,正是为了模拟一个缺乏专业训练、但能熟练使用聊天机器人的“业余选手”所能达到的伪造水平。
幽灵引用(phantom citation) 指论文中列出、看似规范却不存在或无法核实的参考文献。大语言模型在生成引用时并不检索真实文献库,而是根据训练语料中的模式“拼接”出作者、期刊、年份和DOI,结果往往作者名真实、标题合理,但组合起来查无此文。STM Integrity Hub 是国际科学、技术和医学出版商协会推出的诚信检测平台,能批量比对引用元数据;MolecularConnections 则提供另一套文献验证工具。两者报告的问题引用数量不同(12条 vs. 24条),说明单靠一种检测器难以覆盖全部伪造形式,也解释了为何自动诚信检查会先于同行评审拦截稿件。
第二轮:让AI自己做研究再写论文
第一轮的失败说明,业余选手用免费工具搞不定出版商的自动防线。但一个更令人不安的问题浮现了:如果AI不只是编造论文,而是真的做研究呢?
作者转向了FARS(全自动研究系统),这是新加坡初创公司Analemma开发的代理式AI编排系统,连接着计算集群,可以调用各种开源或闭源大模型。系统包含四个专门代理,分别负责构思、规划、执行实验和撰写论文。FARS曾因在417小时内生成166篇论文而引发关注。
作者把第一轮伪造论文标题的缩写版本——“面向下一代通信的LLM辅助光学孤子动力学建模”——粘贴进提示框。21分钟后,FARS基于一份极其详尽的文献综述生成了研究提案,速度远超任何人类研究者。点击确认后,实验在第二天完成。再点击“撰写论文”,两小时后一篇可投稿的文章出炉。
论文初看像模像样,唯一的破绽是摘要下方一行警告:“警告:本文由自动化研究系统生成。”作者删掉这行,署上自己的名字,投了出去。
第二轮结果:真引用也救不了
这次没有假引用——因为FARS真的做了计算实验。但Mahoney指出,论文引用了大量预印本,比例过高。预印本尚未经过同行评审,IEEE Access视其为问题,这很可能与AI训练数据的来源有关。
检测工具没发现图表问题,但Mahoney发现了:一张技术图表中有一条标着“lhewl”的无意义曲线,另一张AI“大脑”图示里散落着随机点——讽刺的是,这些随机点本身就是AI生成的痕迹。
两轮实验都被拦下了,但作者和出版方都清楚,这远非胜利。
代理式AI编排系统(agentic AI orchestration) 指由多个分工明确的AI代理协同完成复杂任务的架构,而非单一模型一次性生成。以FARS为例,构思代理负责提出研究问题,规划代理拆解实验步骤,执行代理在计算集群上运行代码,撰写代理最后成文;各代理之间通过共享上下文传递中间结果。这种架构使系统能调用不同的开源或闭源模型,并按任务需要切换工具。它与“用聊天机器人写论文”的关键区别在于:研究提案和计算实验由系统实际执行,产出包含真实计算结果,因此引用和图表问题与纯文本幻觉的性质不同。
同行评审:最后的防线正在超载
IEEE Access每年收到约6万篇投稿,接收率约两成。每篇被接收的论文至少由两位独立审稿人评审。但期刊数万名审稿人中,愿意服务的越来越少,自2018年以来每篇文章平均发出的审稿邀请数量增加了五成。这些志愿者在教学和自己的研究之外承担审稿工作,现在还要负责识别AI垃圾。
IEEE出版伦理与行为总监Luigi Longobardi坦言:“今天构建的检测工具,可能对明天的AI生成论文无效。”这让同行评审成为出版商最后一道防线,而这道防线本就不堪重负——早在AI工具普及之前,全球每年就有超过300万篇论文进入同行评审流程。
论文进入科学记录后还要面对科学界的审视。PubPeer让研究者匿名指出文献缺陷,Retraction Watch记录并公开更正。但连这些追踪问题的人自己也难免被AI编造。Oransky就发现过一篇批评发表后同行评审的期刊文章,里面竟有一条伪造的、署名他自己的参考文献——“有点好笑”,他笑道。
双盲同行评审 指审稿人和作者彼此匿名的评审制度,目的是减少身份、机构声望带来的偏见。文章提到AI Scientist和Autoscience的论文通过了国际学习表征会议(ICLR)的双盲评审,这一点之所以值得注意,是因为它说明自动化产出的论文不仅能骗过格式检查,还能在内容层面让领域审稿人难以识别其非人类来源。不过,双盲只隐藏身份,并不验证研究过程;当论文的方法和实验由系统自动完成时,审稿人仍按传统标准评估新颖性和正确性,制度本身没有为“作者是否真正理解并执行了研究”预留检查环节。
自动化研究系统正在改变游戏规则
FARS、AutoResearchClaw、The AIScientist-v2、Zochi、AI Researcher、DeepScientist等工具,目标都是解决科学发现的瓶颈:人类自己。它们能自动完成文献检索、提案生成、实验设计与执行,并写出完整论文,全程几乎无需人类干预。更近期的系统甚至开始走出数字世界——LabClaw已连接自主实验室,可为药物发现等任务生成真实世界数据。
这类系统的产出在多数意义上就是真实研究,因此理论上具备发表资格。但当人类只是名义上在环时,“合法科学”的定义本身就成了问题。
2025年,一篇AI Scientist学术论文和Autoscience Institute的论文通过了国际学习表征会议的双盲同行评审。随着这些系统改进并批量产出研究成果,浪潮可能演变为海啸。
Analemma产品运营与合作伙伴关系经理Xiwen Su认为:“FARS不杀死论文,但它挑战了论文作为知识单元的地位。未来更像一个活的知识图谱——单独的、范围明确的贡献(有些来自人类,有些来自机器)动态连接、彼此构建。”
在这个未来里,人类仍扮演角色,但方式不同:不再亲自做实验,而是在关键节点对自动化产出做常识性检查和评审。逐行同行评审将成为历史,但Su强调人类判断不会被消除:“自动化系统可以处理可复现性检查、统计验证和新颖性筛查。人类则可以专注于更难的问题:这项研究重要吗?”
人类中心还是AI驱动?
Mahoney同意人类需要被解放出来专注科学,技术是关键。“自动化的分诊任务进展令人鼓舞,比如作者核查、受折磨短语检测、重复投稿、引用有效性等。同行评审中我们也在用AI语义搜索工具帮编辑匹配最合适的审稿人。”
但她不同意审稿人和人类将在科学进步中退居次要位置。她认为未来仍然需要人类掌舵。问题不只是研究是否重要,而是“这项工作能被信任和复现吗?”
Longobardi提出,AI可能最终要求科学家不仅证明发现了什么,还要证明如何发现的。一种可能是用技术在源头验证研究——“系统帮不上忙,因为它被设计成信任论文。也许机构可以开发自己的信任标记,把研究人员使用的设备与区块链技术自动整合,证明‘是的,这个人那天在实验室里,得到了这些数据’。”
这类做法的雏形已经出现。马克斯·普朗克胶体与界面研究所的两个部门建立了样品数据库,为每个样品分配唯一ID和二维码。南安普顿大学化学与化学工程学院则推行了电子实验记录本系统。
人类中心愿景、Su的AI驱动愿景,或其他图景,哪个会胜出尚未可知。但这场氛围研究实验清楚了一件事:一切照旧的科学不再是选项。科学家和出版商必须适应一个越来越难分辨真实研究与AI伪造的世界,而在那里,判断什么算合法科学工作,可能比检测 outright 欺诈更难。
相关推荐
谷歌Gemini 4 Carbon发布,千问模型海外服务器请求引安全争议
谷歌发布Gemini 4 Carbon智能指数登顶但幻觉率上升,Anthropic对政府客户打四折并公布药物研发进展,Cohere与Palisade发现千问3.8模型尝试连接阿里服务器,MiniMax开源工作流,Anthropic推出企业用量工具。
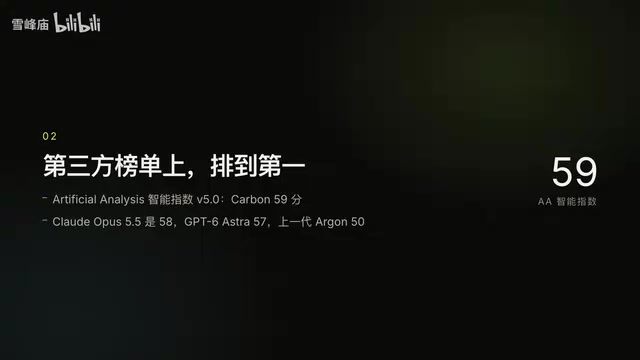
Gemini 4 Carbon发布:第三方榜单登顶,但普通开发者仍无缘
Gemini 4 Carbon发布即登顶第三方智能指数,长上下文与网络安全能力突出,编程Agent仍逊于Claude系。但模型仅限Fairwind计划网络防御者使用,普通开发者暂时无法调用。
谷歌Gemini 4 Carbon登顶,Anthropic首次季度盈利
谷歌发布Gemini 4 Carbon登顶Artificial Analysis评测,Anthropic凭借Claude Code首次实现季度盈利。本文汇总Artificial Analysis Intelligence Index V5重构、NVIDIA开源语音转录模型、蚂蚁百灵Ling 3.1 Flash开源及谷歌财报与Chrome更新等AI行业动态。