Gemini 4 Carbon发布:第三方榜单登顶,但普通开发者仍无缘
Gemini 4 Carbon智能指数登顶,长上下文与安全能力突出,但仅限网络防御者使用。
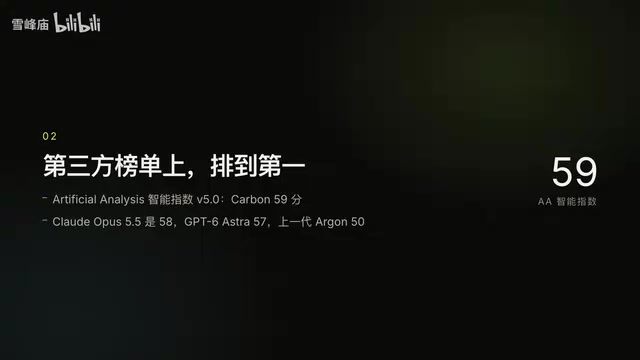
Google在10月28日发布Gemini 4 Carbon,距上一代仅15天。该模型在Artificial Analysis智能指数上以59分排名第一,领先Claude Opus 5.5和GPT-6 Astra。核心优势集中在长上下文与网络安全:Graphworks测试中25万至100万Token上下文定位准确率达96.2%,远超竞品的71.8%;安全能力覆盖漏洞发现、可利用性验证与补丁生成全链条。编程Agent指数59分仍低于Claude Code配Opus 5.5的62分。短板方面,幻觉率从4%升至11%,且Google未发布技术报告与参数信息。目前Carbon仅面向Fairwind计划中的网络防御者开放,普通开发者暂无法调用。
Google在10月28日发布了Gemini 4 Carbon,官方称其为目前最强的前沿模型。距离上一代Gemini 4 Argon开放仅过去15天,如此短的迭代周期,Google给出的解释是“研究员和模型手拉手,把迭代速度提上来了”。第三方评测机构Artificial Analysis的新版智能指数上,Carbon以59分位列第一,领先Claude Opus 5.5的58分和GPT-6 Astra的57分。
然而,这个“全球第一”目前与大多数开发者无关。Carbon仅面向Fairwind计划中的网络防御者开放,普通开发者还需等待。这揭示了一个值得注意的趋势:前沿模型的首发策略正在从“广撒网”转向“定向赋能”,安全领域成为优先落地场景。
性能跃升:编程与Agent任务进步显著
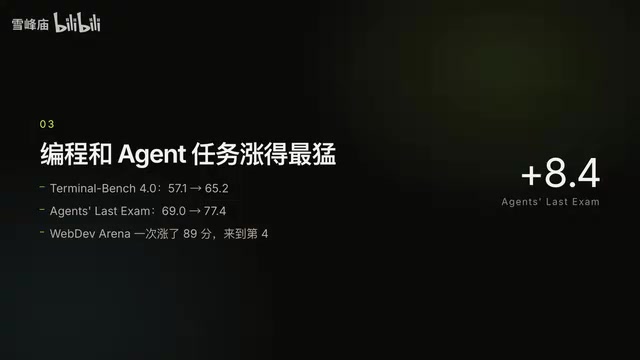
Carbon本次提升最明显的领域集中在编程和Agent任务。Terminal Bench从57分提升至65分,Agent's Last Exam从69分涨到77分,Web Dev Arena上更是一次跃升89分,排名第四。
这些数据与截图信息中“长上下文是它的强项”形成呼应——在需要多步推理和工具调用的场景中,Carbon展现出更强的任务完成能力。不过,在编程Agent指数上,Carbon的59分仍低于Claude Code搭配Opus 5.5的62分,说明在纯编程Agent赛道,Claude系依然保有优势。
长上下文:拉开差距的核心武器
长上下文处理是Carbon本次最突出的技术标签。在Graphworks的测试中,模型需要在25万到100万Token的上下文中定位信息,Carbon拿到了96.2%的准确率,而GPT-6 Astra仅有71.8%。
这种量级上的差距意味着,在处理大型代码库、长文档分析或复杂多轮对话时,Carbon的可用性会明显高于竞品。对于需要“大海捞针”式信息检索的企业场景,这一能力具有直接的生产力价值。
长上下文窗口(Long Context Window) 指模型单次推理可接收的Token总量。Token是模型处理文本的基本单位,约等于0.75个英文单词或半个汉字。上下文窗口越大,模型一次能“看到”的信息越多,越适合处理大型代码库、长篇合同或跨多轮对话的长期记忆任务。业界常用“大海捞针”(Needle-in-a-Haystack)测试评估长上下文能力:在数十万Token的无关文本中埋入一条关键信息,要求模型准确检索出来。Carbon在Graphworks测试中覆盖25万至100万Token区间,意味着其理论上可一次性读入约75万英文单词的素材,这对企业级文档分析和代码审查具有直接意义。
网络安全成为主线:从找漏洞到写补丁
网络安全是这一代模型的主线任务。找漏洞的SEC Bench Pro拿到88.2%,验证漏洞能否被真正利用的Exploit Gym从42%提升到54.8%,写补丁的CWE Bench为71%。
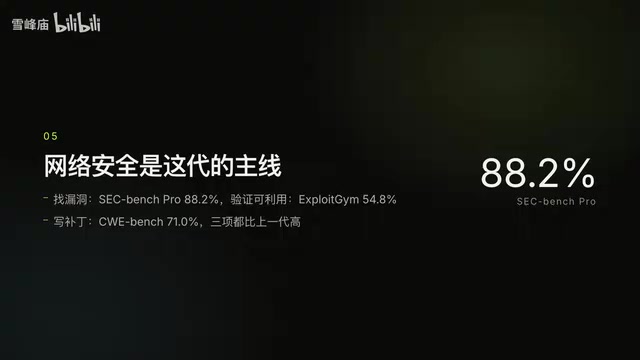
这三个指标构成了一条完整的防御链条:发现漏洞、验证可利用性、生成修复补丁。Google将Carbon首发限定给网络防御者,正是基于这一能力定位。Exploit Gym从42%到54.8%的跃升值得关注——验证漏洞可利用性是安全工作中最耗时的环节之一,模型能力的提升可能显著压缩响应时间。
CWE Bench 中的CWE指“通用弱点枚举”(Common Weakness Enumeration),是由MITRE维护的软件安全缺陷分类体系,涵盖缓冲区溢出、注入攻击、权限校验缺失等数百种弱点类型。CWE Bench以真实代码库中的已知弱点为样本,要求模型生成能消除该弱点的修复补丁,并检验补丁是否通过功能测试与安全测试。Exploit Gym 则评估模型能否将已发现的漏洞转化为可实际利用的攻击路径,即验证漏洞的“可利用性”。两者分别对应防御链条的“修复”与“验证”环节,与SEC Bench Pro的漏洞发现能力共同构成端到端的安全评估框架。
短板同样明显:幻觉率上升与信息不透明
Carbon并非没有代价。独立测试显示,其“换绝率”(即幻觉或错误生成率)从4%上升到11%,这意味着性能提升的同时,可靠性有所下滑。对于安全场景而言,这个数字需要谨慎对待。
另一个值得关注的信号是Google没有发布技术报告,也没有公布模型参数。这与Google过往对前沿模型的信息披露习惯有所不同,外界难以从架构层面理解Carbon的能力来源,也难以独立复现或评估其风险边界。
幻觉(Hallucination) 指模型生成看似合理但与事实不符或无中生有的内容。在安全场景中,幻觉的危害被放大:模型可能虚构不存在的漏洞编号、给出错误的补丁逻辑,或声称某段代码安全而实际存在缺陷。文中“换绝率”从4%升至11%,意味着每生成约9条输出就可能出现1条错误内容。对于依赖模型进行漏洞研判和补丁生成的防御者而言,这一水平要求必须保留人工复核环节,模型的输出只能作为辅助参考而非最终结论。
价格与可及性:定价克制,但门槛仍在
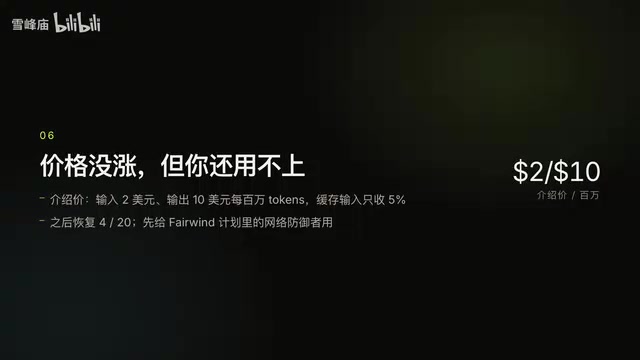
价格方面,Carbon没有涨价。介绍价每百万输入2美元、输出10美元,缓存输入仅收原价的5%。这一价格策略在竞品中具备竞争力,但可及性才是关键问题。
目前Carbon仅面向Fairwind计划中的网络防御者开放。对于绝大多数开发者和企业而言,模型能力再强,无法调用就意味着无法转化为实际价值。Google选择在安全领域先行封闭测试,可能是出于能力风险控制的考虑,但也让“全球第一”的榜单成绩暂时停留在纸面。
多源交叉视角下的Carbon定位
综合B站UP主与多家第三方评测频道的信息,Carbon的共识优势集中在长上下文和网络安全两项能力上,AI指数登顶是多个来源确认的事实。分歧则出现在编程Agent赛道:部分分析认为Carbon的综合编程能力已接近Claude系,但Agent指数59对62的差距仍被多数评测者视为实际短板。此外,有单一来源指出“换绝率”的上升可能与安全场景的定向优化有关,这一说法尚未得到其他来源佐证。
对于普通开发者而言,Carbon的发布更像一个信号而非工具:前沿模型的迭代速度在加快,能力天花板在抬升,但获取门槛也在以场景化的方式重新划分。等待,可能是当下唯一确定的选择。
相关推荐

Last Week Tonight深扒:政客与白人至上主义的危险纽带
Last Week Tonight调查佐治亚州参议员候选人Mike Collins与佛罗里达州候选人Marshall Rawson,揭露他们与白人至上主义者的多重关联,以及共和党内的沉默反应。
AI圈爆料周:GPT-6.5泄露、Claude新模型与MiniMax性价比
本周AI圈爆料汇总:GPT-6.5疑似泄露、微软配置现GPT-6.1 Tera、Anthropic新模型能识别整类Bug、Gemini 4 Carbon早期表现失望,以及MiniMax M3.1 Flash以极低成本在基准测试中超越Claude Opus 5和GPT-5.6 Sol。
AI快讯:Gemini 4 Carbon发布,蚂蚁开源Ling-3.1
AI快讯:Google发布Gemini 4 Carbon量子位模型,宣称超越Opus 5.5且首发Token半价;蚂蚁百灵开源Ling-3.1-1019推动Personal Agent真实任务;国产AI制药19个项目18个成功,6个GPCR靶点全命中;零营收公司估值200亿美元再融10亿美元;四川便利店机器人售货失败。