AI写的模型跑在DOS上:367K参数塞进软盘

AI 编写并训练的 367K 参数语言模型被压进 435 KB,可在 DOS 软盘时代硬件上运行。
一个由 AI 自主编写与训练的实验性微型语言模型引发讨论:Claude 负责编写 Transformer 结构,Opus 5.5 生成约 3500 条训练数据,最终模型仅 367K 参数,经 8 位整数量化后程序与权重合计约 435 KB,可存入一张 3.5 英寸软盘并在 Intel Pentium 的 DOS 内存中运行。它对训练中见过的问题回答尚可,遇到复杂或过长的问题则输出混乱。项目的价值不在于性能,而在于验证了"AI 造 AI"的开发闭环,以及极端算力与存储约束下语言模型的可行性边界。
当语言模型回到软盘时代
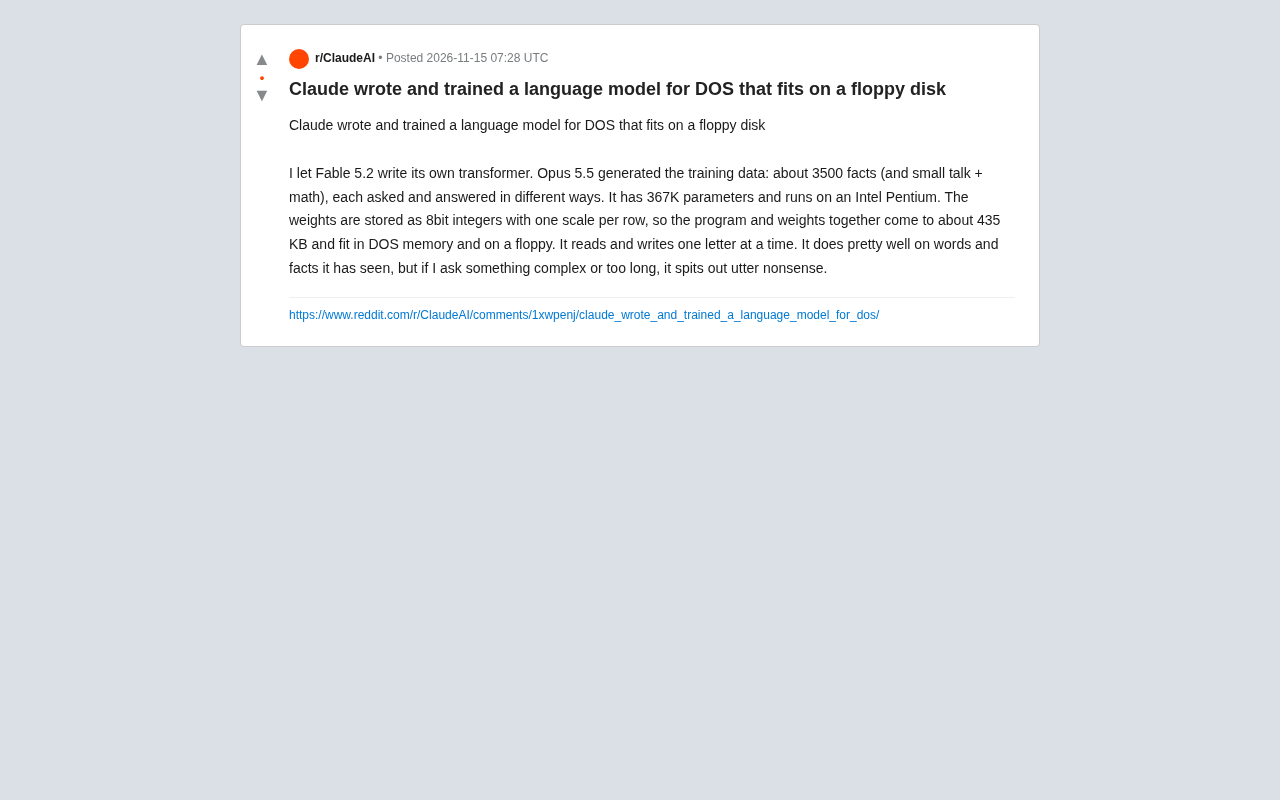
一个由AI自己编写并训练的微型语言模型,最近在Reddit上引起讨论。这个项目让Claude(具体版本为Fable 5.2)编写Transformer结构,再由Opus 5.5生成训练数据——约3500条事实、闲聊和数学问答,每条都以不同方式提问和回答。最终模型只有367K参数,能在Intel Pentium处理器上运行,程序与权重合计约435 KB,足以存入一张软盘并完全载入DOS内存。
这并非追求性能的工程,而是一次关于「最小可行语言模型」的边界实验。
技术拆解:如何把模型压进软盘
数据与训练
训练数据由Opus 5.5生成,覆盖约3500条事实性知识、简单闲聊和算术题,每条内容用多种问法表达,以增强模型的泛化能力。整个训练过程由AI完成,人类只负责设定目标与验证结果。
Transformer 结构是 2017 年论文《Attention Is All You Need》提出的神经网络架构,核心是自注意力机制(self-attention):序列中每个位置都能直接"关注"其他所有位置,从而建模长距离依赖,而不像 RNN 那样逐步传递状态。一个完整的 Transformer 通常包含嵌入层、多头注意力、前馈网络、残差连接与层归一化。本项目的特别之处在于,这套结构代码并非人类手写,而是由语言模型直接生成,因此需要在参数规模、层数、词表大小上都做极简化裁剪,才能在 367K 参数和 DOS 内存的约束下落地。
量化与存储
模型权重以8位整数存储,每行使用一个缩放因子(scale per row)。这种量化方式大幅压缩了体积,使程序与权重总和控制在约435 KB。作为参照,一张经典3.5英寸软盘容量为1.44 MB,模型只占其中一小部分。
8 位整数量化指把训练得到的 32 位浮点权重映射到 -128~127 的整数区间,从而把每个参数的存储需求压缩到原来的四分之一。映射需要一个缩放因子:若整行权重共用一个 scale(per-tensor/per-row),则整行共享同一个动态范围,精度损失较大但元数据开销极小;若每个权重单独一个 scale(per-channel),精度更高但额外存储会侵蚀压缩收益。逐行缩放(scale per row) 是这两者之间的折中——每行矩阵元素共享一个缩放系数,既控制了精度损失,又只增加少量额外字节。这种思路也是 GGUF、GPTQ 等现代量化格式的雏形,在嵌入式与边缘推理中尤为常见。
运行环境
模型运行在Intel Pentium处理器上,完全在DOS内存中执行,读写时逐个字母处理。这意味着它不依赖现代GPU或大容量内存,而是回归到个人电脑早期的计算约束。
DOS 内存模型与现代操作系统差异很大:经典 DOS 的实模式寻址上限为 1 MB,其中 640 KB 为常规内存,应用程序必须在此范围内加载代码、数据和栈。这意味着模型权重不能简单"映射"进内存,而要精打细算地分段加载与覆盖。此外,逐字母(字符级)处理意味着模型以单个字符为最小 token 单元,而非 BPE 或 WordPiece 之类的子词单元;字符级词表更小、更省参数,但序列更长、生成更慢,也解释了为何长文本输出会变得不连贯。
能力边界:见过的好用,没见过的胡言
作者对模型的表现给出了坦率评价:对于训练中见过的词汇和事实,它回答得「相当不错」;但遇到复杂或过长的问题时,输出会变成「彻底的胡言乱语」。
这揭示了微型模型的根本限制——367K参数能容纳的知识量极其有限,它更像一个高度压缩的问答查找表,而非具备推理能力的通用模型。逐个字母的读写方式也意味着生成速度受限于字符级处理,无法流畅输出长文本。
为什么这件事值得关注
AI编写AI的闭环
项目最有趣的部分不是模型本身,而是开发流程:一个AI编写Transformer代码,另一个AI生成训练数据,人类只做调度和评估。这种「AI造AI」的循环正在成为新的工程范式,尽管当前成果规模极小。
极端约束下的工程思路
在算力和存储极度受限的环境中,8位整数量化和逐行缩放是务实的选择。这类技巧在边缘设备和嵌入式场景中同样有参考价值——当模型必须塞进有限内存时,如何取舍精度与体积是核心问题。
对「大模型竞赛」的反向提醒
当行业追逐万亿参数时,这个435 KB的模型提醒人们:语言模型的能力下限可以低到什么程度,以及参数规模与实用能力之间的鸿沟有多深。它不实用,但清晰地标出了「能跑」与「好用」之间的距离。
局限与展望
这个项目目前是技术演示性质,不具备实际应用价值。它的意义在于验证了一条极端路径的可行性:在DOS和软盘这样的古董平台上,语言模型依然可以存在。未来若结合更高效的量化方法和更大的训练数据,类似思路或许能在复古计算或教学演示场景中找到位置。
对于关注AI编程和边缘部署的开发者来说,这个实验提供了一个可复现的最小样本——367K参数、435 KB、一张软盘,足够说明很多问题。
相关推荐

Zed编辑器发布v1.29.2:一次常规版本迭代的观察
Zed编辑器发布v1.29.2补丁版本,由@JosephTLyons完成版本升级,提交经GitHub签名验证。本文梳理该版本的基本信息、补丁版本的含义以及对用户升级的实际建议。

Anthropic IPO遭质疑:Hacker News热议其上市时机
Hacker News出现「Just say no to Anthropic's IPO」帖子,引发对Anthropic上市时机与AI公司资本化的讨论,涉及估值泡沫与使命独立性等议题。

Genie 4世界模型上手:像木偶师一样实时导演世界
Google DeepMind 世界模型 Genie 4 深度解析:Special Guest X 实测展示如何用提示词实时导演场景、通过 Project Genie 构建自定义交互应用,以及提示词即种子的可复现设计。